过去一周,本地大模型圈子的聊天内容变了。之前大家算的是16G显存怎么塞进27B、KV cache还剩几个token、SSD能不能给显存接班;这周开始,群里冒出来的问题变成了——“这个只有2.37GB、连天都不会聊的东西,要不要给我的agent装一个?”
这个"东西"叫Jev。9月15日,前OpenAI研究员、官方简历上写着"共同发明RLHF和InstructGPT"的Diogo Almeida创办的TypeSafe AI结束隐身,发布Jev。同一天官宣DCVC领投的4000万美元种子轮。9月21日,也就是今天,它从邀请排队制正式开放注册:邮箱注册、Playground直接玩、API Key自建、Python/JS SDK齐了,Vercel AI Gateway专门给它加了个experimental_evaluate接口,Cloudflare Workers AI也上线了支持。知乎知乎
一个不会聊天、不能写代码、没法给你输出任何一句人话的模型,为什么让本地玩家集体动心?
它切走的,正好是你最烦的那部分调用
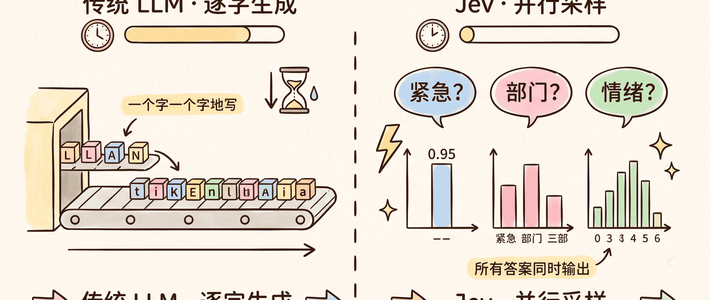
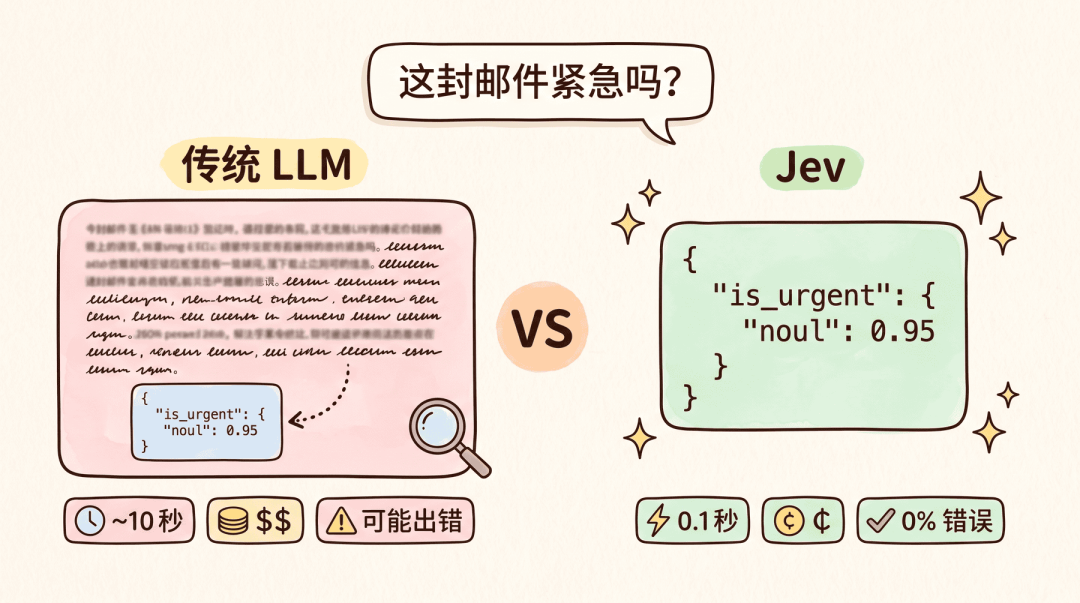
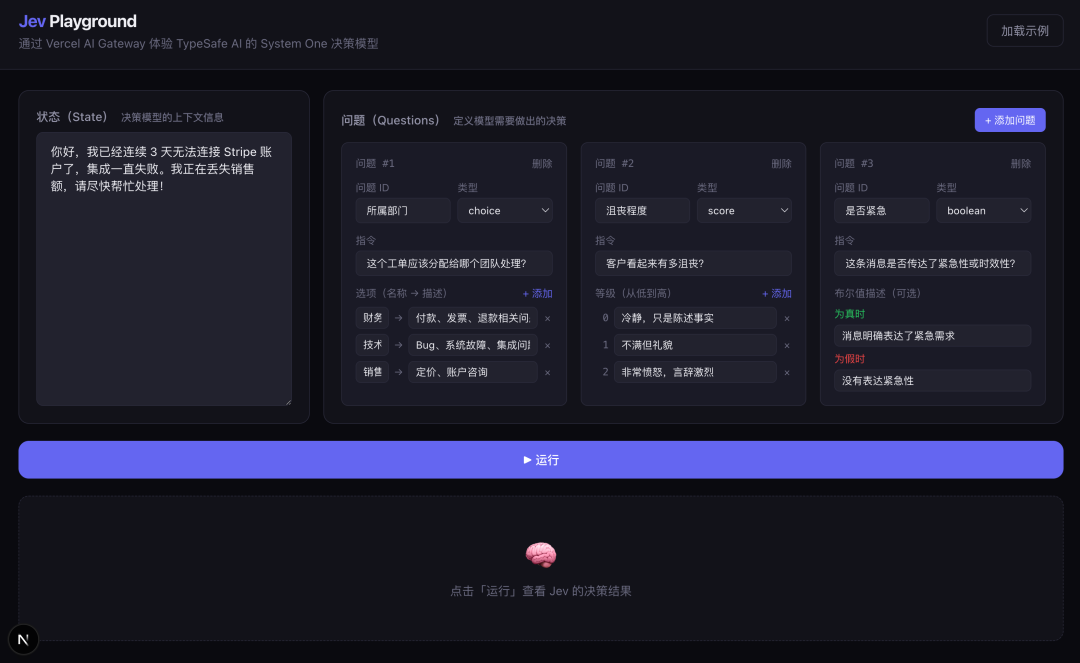
Jev被TypeSafe叫作"System 1模型",名字来自卡尼曼的《思考,快与慢》。你问传统大模型"这封邮件紧急吗",它会先写一大段分析再给结论;问Jev,它直接回你一段结构化JSON:“是,概率0.95”。程序里写个 if > 0.8 就能触发告警,不用从回答里抠答案,也不用担心它哪天抽风把JSON写坏。知乎
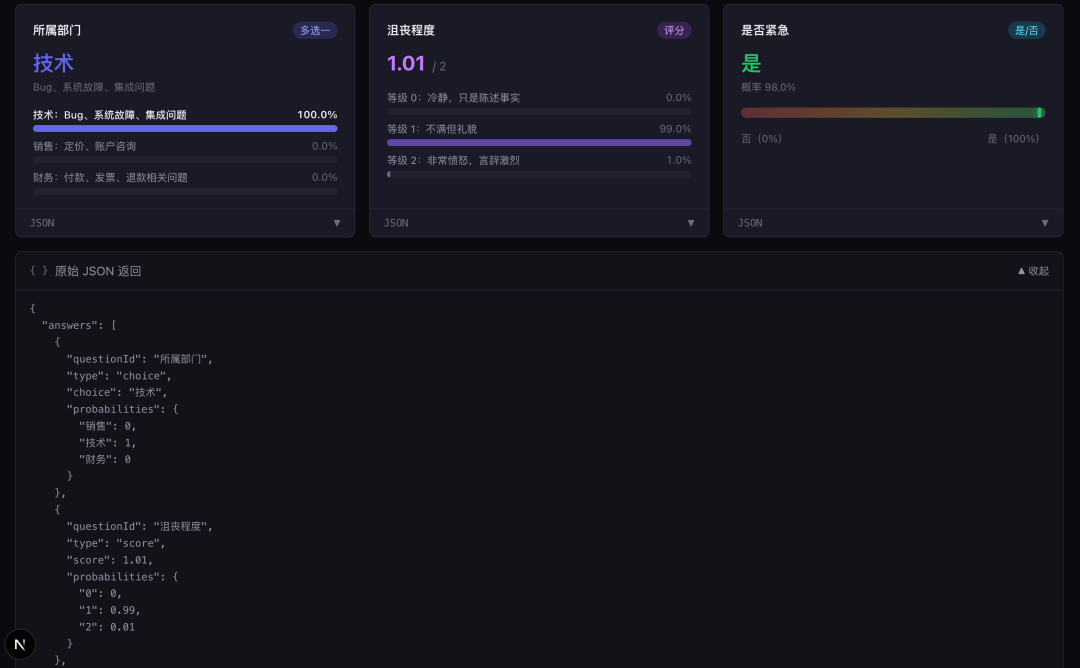
它只有三种题型,官方叫"AI原语":Noul(判断题,返回0-1概率)、Choice(选择题,最多255个选项,每个选项都给概率分布)、Score(打分题,自定义2-10级量表,分数可以落在两级之间)。原理上它不逐token"写字",而是并行采样,一次性把所有选项的概率吐出来——一次问1个问题和一次问10个问题,响应时间几乎没差别。训练方法也不是RLHF,而是自研的RLCD(校准决策强化学习):说90%把握,就得真做到九成对。知乎
对谁有感觉?就是那批已经拿本地27B在跑工单分类、报警定级、内容审核、工具路由的人。B站评论区有人一句话点中:"现在用DeepSeek要3~5秒,我希望1秒搞定。“社区已经有人拿它把1018篇论文分类花掉0.08美元、用浏览器agent 7.1秒搜完一次航班机票花0.0039美元、拿Claude Code配Jev做"快慢循环”,高频判断步骤成本砍了九成。官方定价每百万输入token 0.042美元,输出不要钱。哔哩哔哩哔哩哔哩
数字先分三档:厂商口径、独立复测、自报成绩
这波热闹里流传的数据来源很杂,我按证据等级给你拆开。
第一档,厂商和媒体口径,没法外部验证:比Claude Sonnet 5分类快193倍、比Opus 5便宜444倍、响应最高快近200倍、结构化输出零错误。方向可信,具体倍数先当宣传看——Jev闭源,没放权重、没发论文、没给训练数据,外界连它架构细节都无从核对。知乎
第二档,独立复测,可以较真。知乎用户wangleineo搭了7个benchmark(含专门为决策模型做的JevBench),拿Jev对中档开源模型qwen3-30b-a3b做对比:准确率差距不大,个别项目Jev反超;但每条query Jev平均0.3秒,LLM做结构化输出要几秒到十几秒。整套测试Jev花了两美分左右,本来就便宜的Qwen(0.75元/3元每百万token)花了近5块。他的结论很克制:官方数据基本可信,但Jev智能接近的只是中等水平LLM,且不排除对bench做过针对性优化。知乎
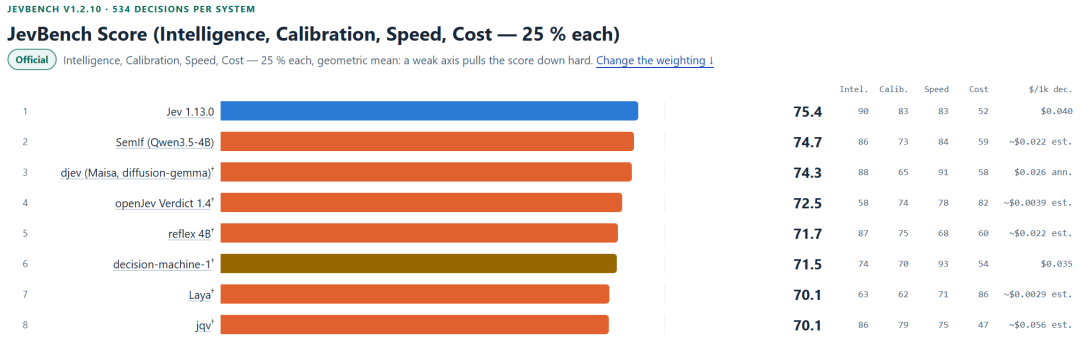
第三档,开源项目自报,打折看:本地版Laya宣称2000题基准76.6%对Jev的72.7%。 同机每秒86次对云端3次。作者自己测的,对面数据一半来自官方一半来自第三方,没交叉验证过。哔哩哔哩哔哩哔哩
本地玩家的真实战场:克隆三天4000星,但坑也提前暴露
Jev要排队那几天,“24小时冒出30个本地替代Jev的开源项目"已经成了海外博主的视频标题。热度最高的是Laya——就是那个在Hacker News上引爆原创权之争的项目:独立研究者Nandakishor Mukkunnoth发帖说,同样思路的非自回归决策模型他2025年3月就发了arXiv论文、开源了权重和数据集,无人问津。两年后换了个带着4000万美元融资的发布,就成了"范式级突破”。HN评论区吵成三派:有人说这就是"喂了更多数据的BERT",有人晒出自己一年前给客户做过类似的,也有人觉得这是典型的"多重独立发现",只是资源和注意力天差地别。哔哩哔哩知乎
技术本身倒是摊开了看:Laya用双向编码器,单次前向同时回答多个结构化问题,MIT协议、pip一键装。国内生态位已经有人补上——GitHub上的laya-setup把部署打包成一键安装,号称兼容TypeSafe官方API/SDK格式,能直接接进Claude Code和Cline;小红书上laya-mlx的Mac本地实测帖收藏比点赞还高。最扎心的一条是对账视频里说的:云端要排队、按token收费、每步约300ms。这不就是当年云端API逼着大家回本地的同款剧情吗。而且这波对硬件太友好了:0.4B参数、2.37GB模型文件,CPU就能跑毫秒级。过去几周大家还在为11.8GB的量化文件抠KV cache,战场突然换到了"要不要给决策层留个位置"。知乎哔哩哔哩哔哩哔哩
顺带提醒一个灰线:官方开放前就冒出了"注册免费送Key、完全兼容官方API"的第三方托管端点,视频播放量不小。模型文件小不等于来源可信,你的工单、邮件、客户数据从这种端点过一遍,等于自愿放弃这波"数据不出本机"的初衷。
三盆冷水,泼的都是"拿它当大脑"的人
第一盆:它不是规划器。知乎用户Karminski搭了个和Jev接口一样的纯随机数服务器,在迷宫寻路上对打——随机数892步、不到300毫秒通关;Jev跑了2306步,在(7,4)拐角原地打转到超时,哪怕把曼哈顿距离、last_move、邻居访问次数全喂给它也不听。它是个极速单步判断器,凡是"需要绕路回溯多步规划"(迷宫、装箱、调度)、“一步踏错当场GG”(贪吃蛇、俄罗斯方块那类游戏化控制)、“不可逆高代价操作”(删库、生产事务),都别问它。知乎
第二盆:金融圈已经替大家撞过墙。有人拿90根日线、5个市场、300次交易决策回测,16次做空全部返回"不适用",利润因子和胜率都不达标。结论是一句很值得抄下来的话:Jev不是交易AI,是被确定性代码包裹的判断原语。哔哩哔哩
第三盆:置信度不等于正确。Laya官网自己公布的反面数据:高棉语输入喂给英文checkpoint,准确率0%,平均置信度95.2%。校准训练让你敢用它的概率,前提是你给对了题型和语言。另外它也不是免费午餐:选择题选项一多就露怯,Banking77这种77选项任务Laya只有0.425,Jev是0.870;开源克隆的上下文普遍只有512-1024 token,而Jev据称有32k——这个差距在对比表里被刻意淡化了。知乎
这波要不要跟:分三种人
只需要本地聊天和写代码的:不跟。你现有的27B该干嘛干嘛,这波跟你无关,等JevBench榜单和TypeSafe是否开源权重再说。
已经在拿模型跑分类/审核/路由自动化、嫌又慢又贵的:现在就能动手评估。先走官方Playground免费试你的任务是这三种原语的形状:判断、选择、打分。 形状对得上再谈成本;涉及私有数据的验证,优先用MIT协议的本地克隆离线跑,别碰免费兼容端点。知乎
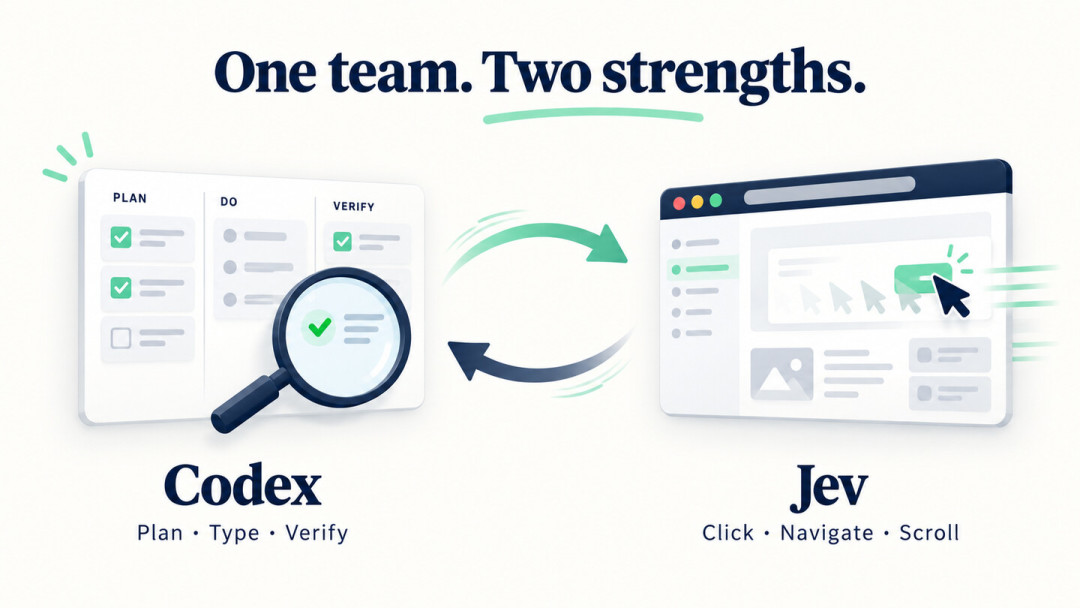
16G卡在跑Claude Code/Cline这类agent的:比起追Jev本身,"快慢循环"的工程思路更值钱——把每步都调大LLM的高频小判断拆出去,让大模型只在要写东西的时候上。这也是评论区共识最集中的一个方向,连"LLM是写作文、它是做选择题"这种吐槽都承认分工成立。
值得继续盯的三个信号:TypeSafe会不会发技术报告或开放权重(目前零披露,"千问套壳"的质疑和"超级BERT"的嘲讽都卡在这个信息缺口上);JevBench上开源模型的排名换手速度;以及大厂跟进——社区已经在赌DeepSeek下一版就学这个思路。wangleineo那句话我认同:这类模型没有太多技术壁垒,真正的价值在于"把决策点从大模型调用里拆出来"这个用法被验证了。对本地玩家来说,这意味着你的显卡账单和等待时间,第一次有了"拆"的解法。哔哩哔哩知乎