Qwen4发布了,本地党却望夫石上身:到底在等什么
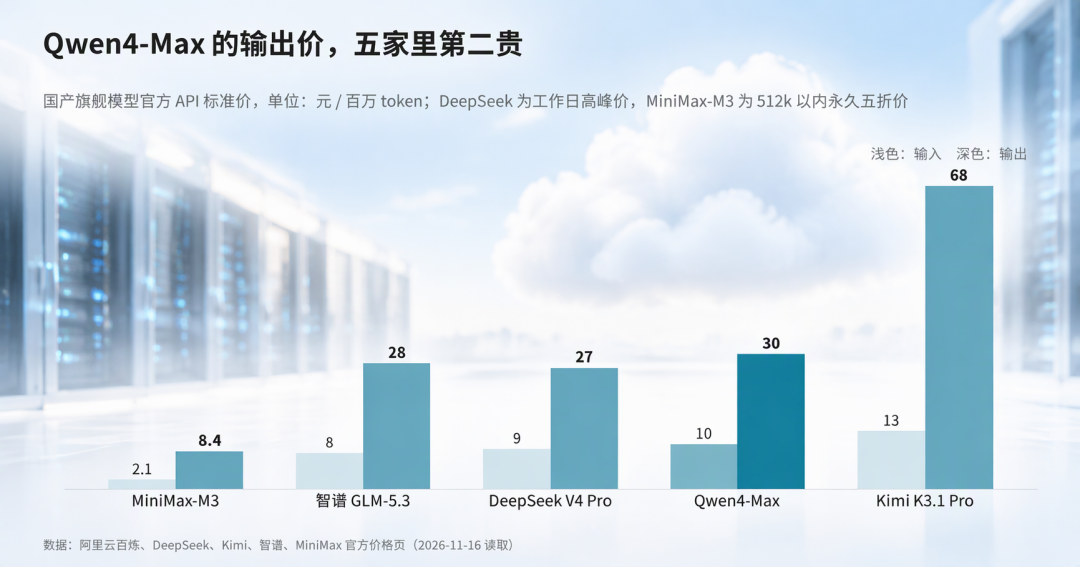
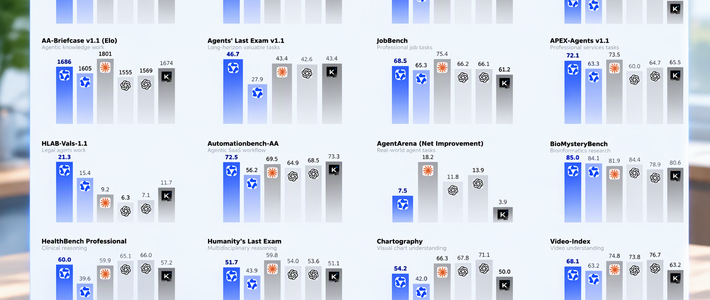
11月16日,阿里把Qwen4-Max正式版端了上来:总参数2.4万亿,原生视觉,百万上下文。官方发布信息里还标了激活规模:每个token激活71B,API已经上线,缓存命中低至每百万Token 0.5元,单任务平均费用比上一代降六成。微博知乎微博
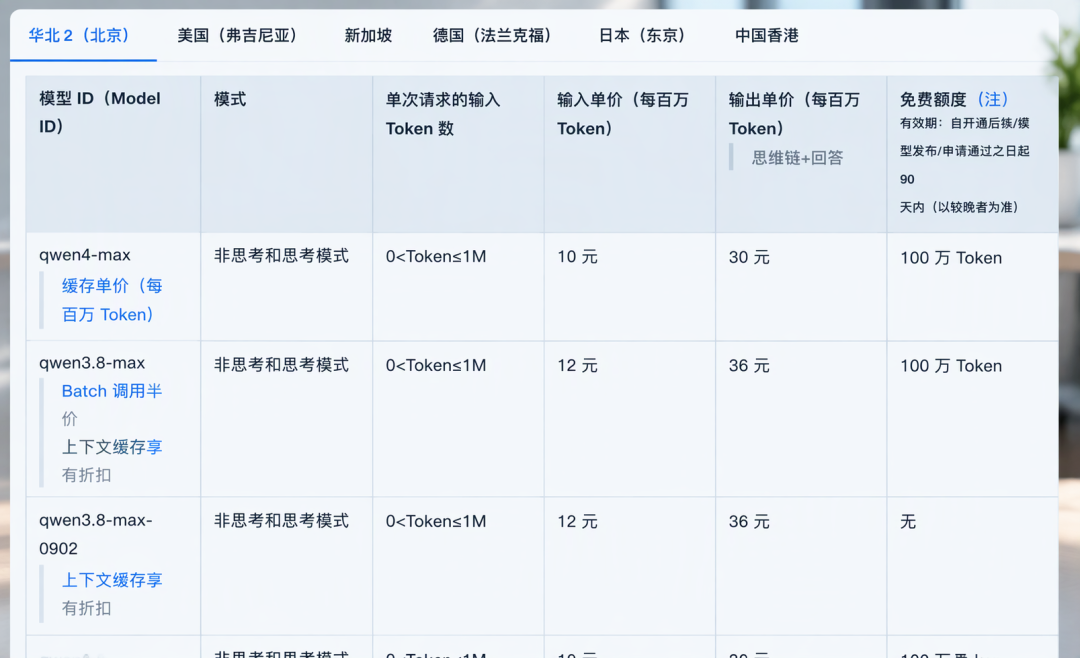
但对本地部署的人来说,官方公告里另一半话才是重点:旗舰Max闭源、只走API;Qwen4系列的中小尺寸模型将"陆续"开源。而"陆续"这个词,到今天还没开始。知乎
热评185赞的那句是"一个模型把大伙干成望夫石了"。哔哩哔哩
B站UP主给delay排了个理由单:27B要用Qwen4-Max蒸馏,所以必须等Max定档;预览版原定持续到11月25日,结果正式版提前在16号就来了。按这个逻辑,开源权重理论上随时可能放,但没人给准话。也有更阴暗的猜测:内部质量核验翻车,或者"有人基于Qwen3.8-27B发了西方价值观微调版,逼得官方压力山大"——都是社区推测,无实锤,当段子听。哔哩哔哩
本地党真正在等的,未必是27B,而是Flash。评论区的声音是:8G显存、速度翻倍、能力强过27B。听着很香,但请先看标签:这是社区期待,不是官方参数。小红书流传的"27B能在16GB配置跑",同样只是传闻。哔哩哔哩小红书
实打实的现役方案还是上一代:有用户拿Qwen3.5的9B加0.6B/1.7B的ASR小模型,一张16G显卡就支起了一个本地语音助手。一条高赞评论这样总结她在本地圈的处境:旗舰没抢到头条,但"外头天天神仙打架抢头条,转头一看全在偷偷拿她当底模蒸馏"。哔哩哔哩
所以开源真空期的这几天,生存指南就三条:
别碰"Qwen4泄露权重":官方没发之前,任何标着"预览/抢先/内部"的文件,基本不是坑就是雷;
已经跑Qwen3.8/3.5小模型的,不用拆环境:等开源正式版落地,看重量化档位和显存曲线再升级;
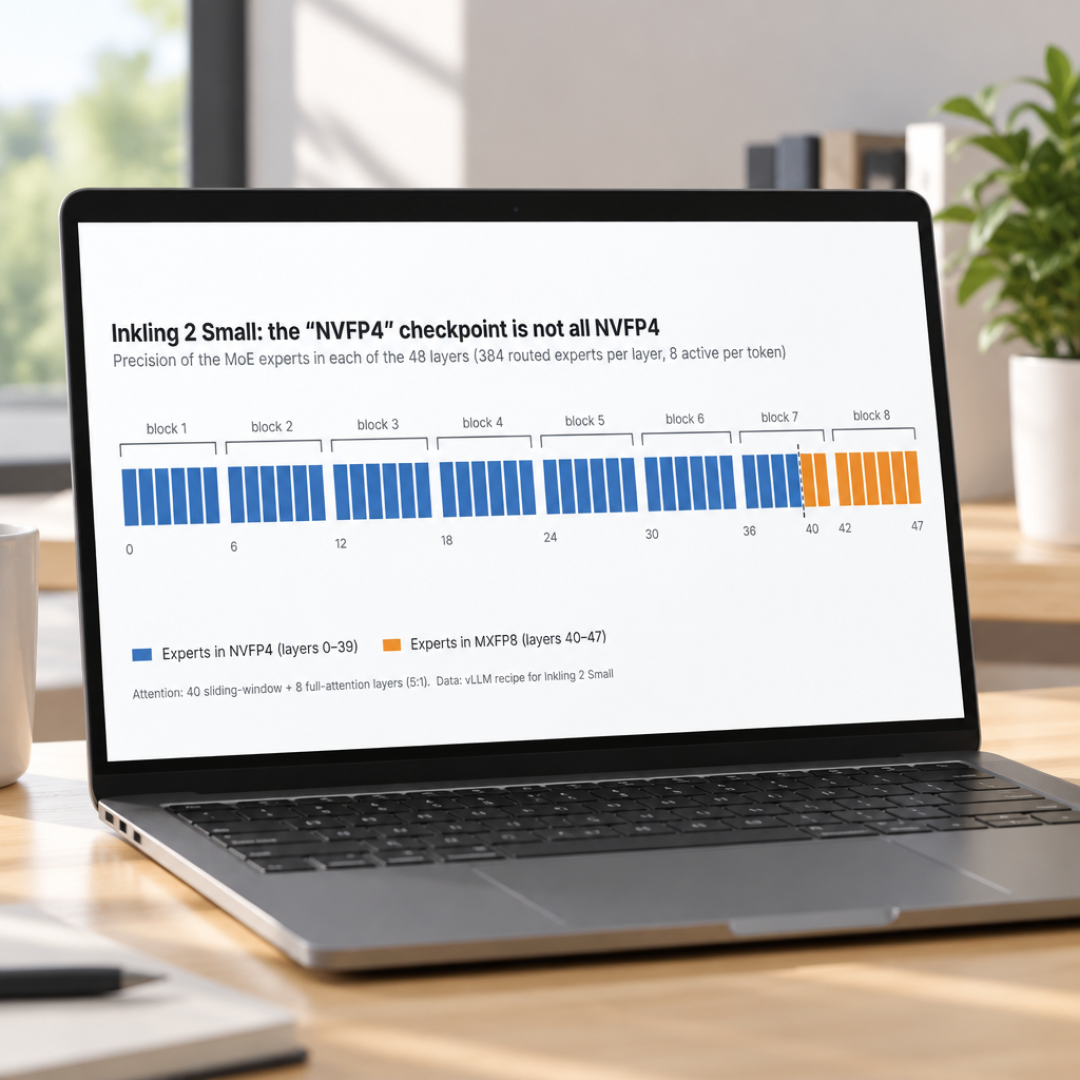
真等不及,还有第二选择:Thinking Machines在11月12日开源了Inkling 2 Small,总参数594B的MoE,每个token只激活17B,Apache 2.0协议。主版本checkpoint约需500GB显存,两台B300跑得动,家里的单卡没戏。知乎
最后说句扎心但实诚的:云端API降价六成,"本地部署省钱"这笔账正在越来越难算。把模型跑在自己机器上的理由,本来就不是省钱,是"数据不出本机"和"离线可用"。如果这两条对你不是刚需,这块望夫石,其实你不用跟着望。