










 深耕数码兴趣领域






24
31
真实能跑AI的笔记本,打游戏却很尬,YOGA Pro 15 RTX Spark解析
2026-11-16 23:49:20
0点赞
0收藏
0评论
“AI PC”这个词已经被用烂。大多数所谓AI笔记本,本地跑个7B小模型都难,真正干活还是得连云端。基本上只能演示一个本地抠图或者实时字幕。
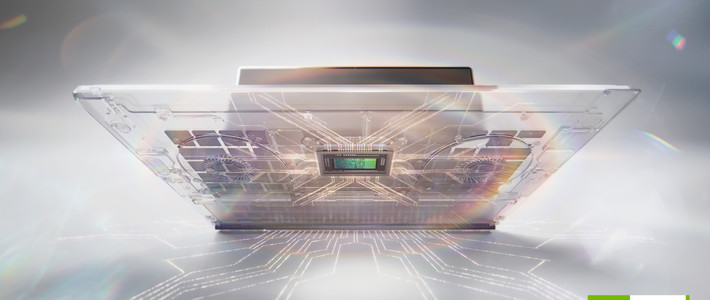
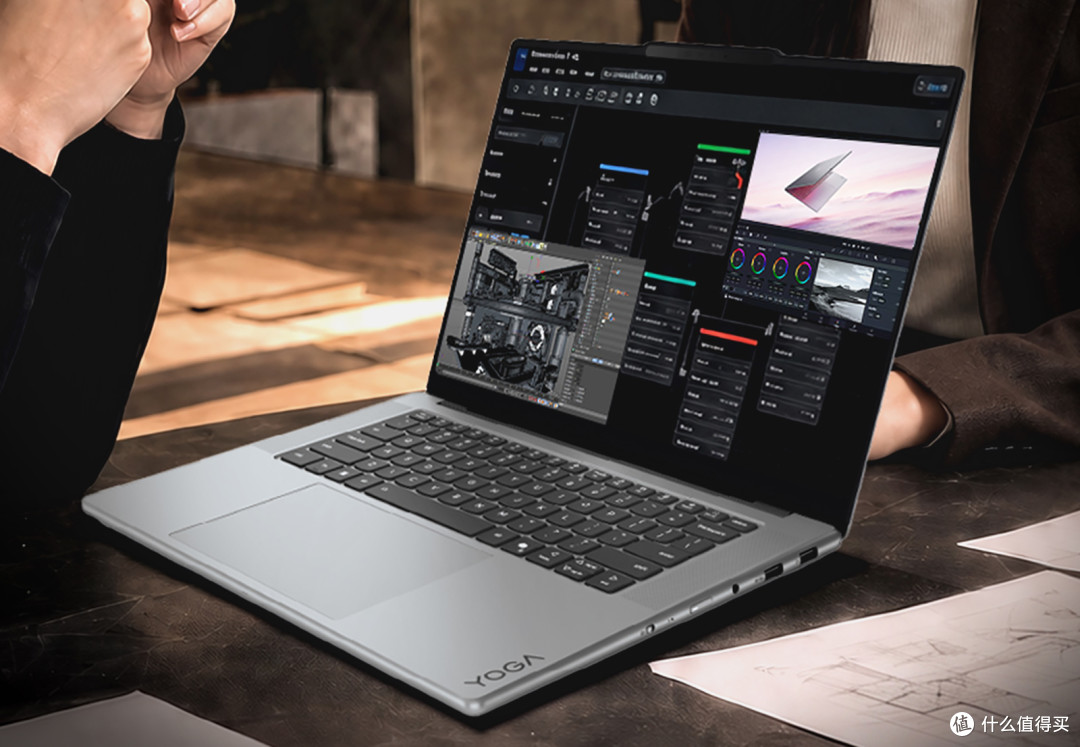
联想YOGA Pro 15 RTX Spark不一样。它搭载的是NVIDIA历史上第一颗完整面向个人电脑的SoC——RTX Spark N1X,CPU、GPU和内存被封装在同一颗芯片里,共享一个128GB的统一内存池,跑模型能力已经很不错。
一、NVIDIA RTX Spark N1X处理器
我们需要先把这颗处理器了解清楚。
RTX Spark N1X由两个Die组成,均为台积电N3E工艺。
CPU部分是20核Arm架构:10个Cortex X925 P核(最高4.0—4.1GHz)加10个Cortex A725 E核(2.8GHz),分为两个簇,分别配8MB和16MB L3缓存,外加16MB SLC缓存供整个SoC使用。
GPU部分是6144个CUDA核心的Blackwell架构,核心数量甚至超过了移动版RTX 5070 Ti的5888个。
但核心数多不等于性能强。N1X的GPU用的是256-bit LPDDR5X-9400统一内存,峰值带宽300GB/s,稳定带宽273.2GB/s。
作为对比,移动版RTX 5070 Ti的GDDR7显存带宽是677GB/s,是N1X的两倍多。
这决定了它的游戏性能天花板:GPU理论性能落在RTX 5060移动版和RTX 5070移动版之间,部分测试中甚至略低于RTX 5060。
所以,如果买电脑的主要目的是玩游戏,这台机器明显不适合。CPU受限的游戏在Windows on ARM的转译层之下,帧率会被压到30fps左右;高帧率电竞网游的表现也大幅落后于同价位的传统游戏本。
二、本地AI:128GB统一内存
这才是NVIDIA RTX Spark N1X真实值得说的。
传统独显笔记本跑本地大模型,最大的瓶颈不是算力,是显存。一张RTX 4090 laptop只有16GB显存,通常只能跑 7B–14B级别,70B量化版连权重都放不进去。
120B级别的模型?消费级独显根本装不下。N1X用128GB统一内存绕过了这道坎:模型权重和KV缓存都放在同一个池子里,GPU直接访问,不需要经过PCIe在内存和显存之间来回传输。
实测数据很能说明问题。在Llama.cpp或类似推理框架下,RTX Spark笔记本跑gpt-oss-120b(MoE架构)的速度大约在50—65 tokens/s之间,部分测试中甚至快过同芯片的桌面版DGX Spark。
对于需要把大量内部文档、代码库、设计素材喂给模型进行本地推理的创作者或开发者来说,50 tokens/s以上的生成速度已经是“可用”区间,而不只是“尝鲜”。
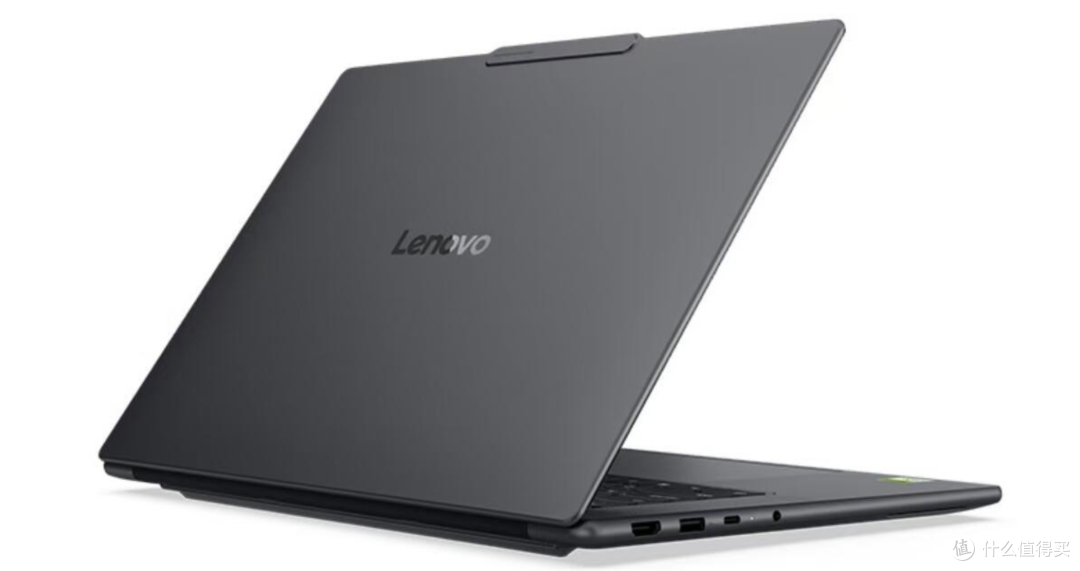
再看一个细节:统一内存的带宽是300GB/s,不是苹果M5 Ultra的1.2TB/s。在小模型、短上下文的纯decode场景下,带宽存在物理上限,M5 Ultra在这一项上确实更快。
三、配置解析
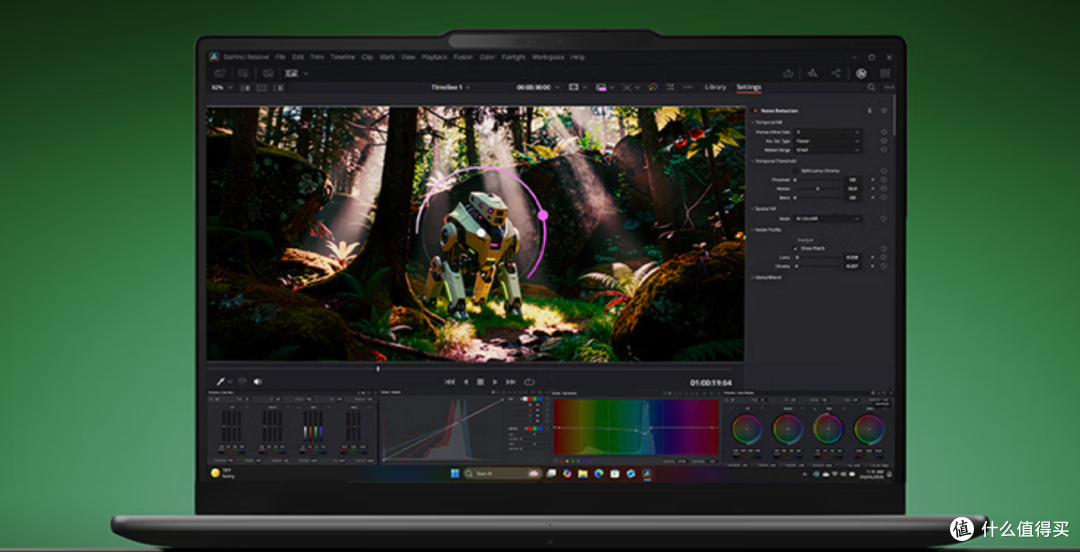
1、屏幕:15.3英寸2560×1600 165Hz OLED触控,100% DCI-P3,ΔE<0.5,1100尼特峰值亮度。
这块屏幕的素质在这个价位上没有槽点,色准和亮度都是创作本顶级水准。但它是镜面屏,没有抗反射涂层,反光会比较明显。 这是YOGA Pro系列OLED机型的老问题。
2、内存:128GB LPDDR5x 9400MT/s,四通道,板载不可更换。
这是整台机器最贵的部件,也是128GB版比64GB版贵出1.3万元的核心原因(64GB版国补价28499元,128GB版41499元)。
1.3万元买的不是“日常用更快”,而是模型容量上限:64GB能跑70B级别,128GB才能从容处理120B级别加长上下文的KV缓存。
3、硬盘:2TB PCIe 5.0 SSD。
还有一个2242规格的空盘位可以扩展。硬盘本身很快,但4K随机读写表现一般,属于大文件吞吐强、小文件随机弱的那一类。
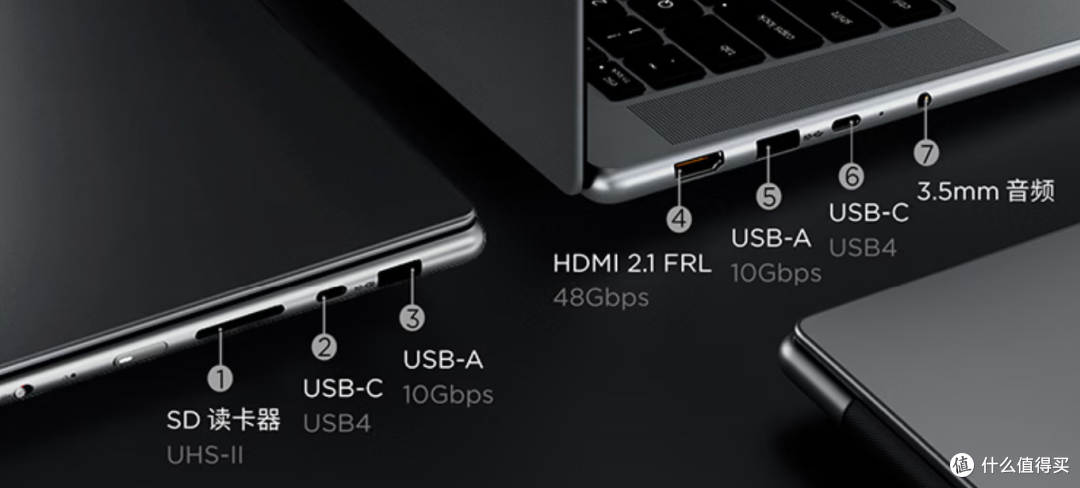
4、接口:左侧USB4(140W私有协议+100W PD+DP2.1)、USB-A 10Gbps、HDMI 2.1 FRL、3.5mm;右侧USB4(同规格)、USB-A 10Gbps、SD UHS-II读卡器。
两侧都有全速USB4和USB-A,对于创作者来说SD读卡器是实打实的加分项,不用带扩展坞就能完成素材导入和双屏输出。
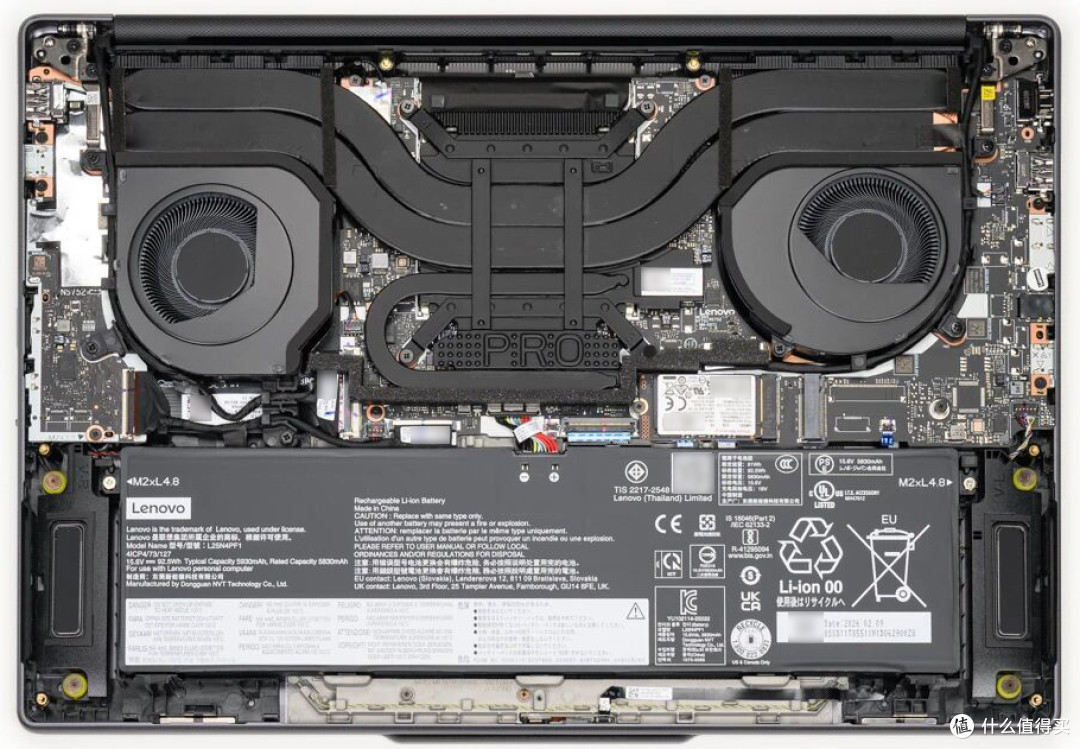
5、散热与功耗:双风扇三热管,内吹设计。满载创作模式下CPU约15W,GPU约55W,SoC封装总功耗约80W;单烤FPU时CPU可跑到70W。这套散热压住80W的SoC没有问题,但要注意N1X的SoC封装功耗不包含内存功耗,不能直接和“独显+CPU”的传统平台功耗数字对比。
总结
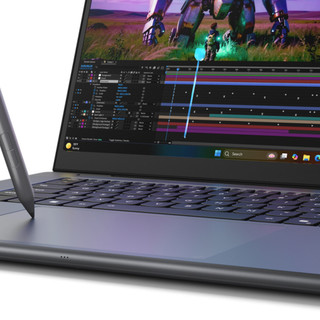
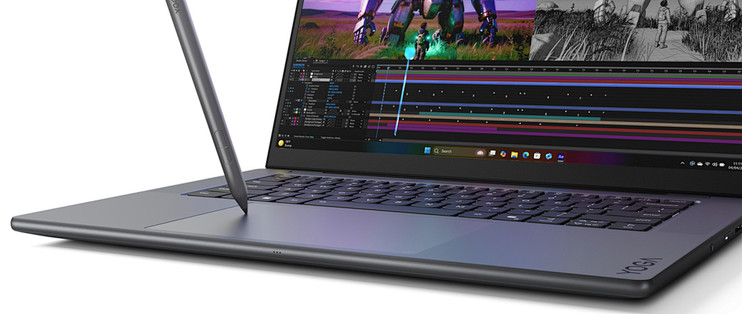
联想YOGA Pro 15 RTX Spark不是一台全能笔记本。它是一台为了本地大模型推理和AI创作工作流而存在的机器,游戏和部分传统WoA应用是主动妥协的部分。
适合的用户非常明确:工作流需要在本地跑70B—120B级别的模型,对数据隐私有硬性要求,不愿意或不能依赖云端API,同时需要CUDA生态的工具链支持。对这少部分人来说,41499元买到的是一台能装进背包的“个人AI工作站”,市面上很少有同类可选。
不适合的用户:电脑游戏需求;AI需求停留在“试试看”的阶段;数据隐私性不强。对这些用户来说,云端AI套餐加一台传统游戏本或轻薄本,总成本更低,体验也更完整。
NVIDIA用N1X证明了统一内存架构在PC上跑大模型是一条走得通的路,联想用YOGA Pro 15把这套方案塞进一台做工精致的轻薄本里。但“走得通”,并不等于“值得买”。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~