

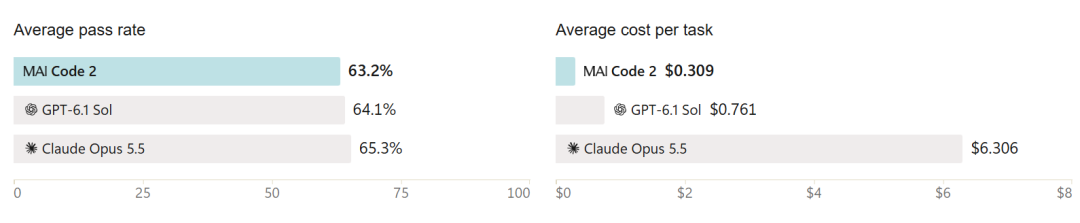
11月17日,微软在 Ignite 2026 上把七款 MAI 模型排成一排。最扎眼的是编程模型 MAI Code 2。微软给出的数字很直接:MAI Code 2的性能达到Claude Opus 5.5的96%,而成本仅为后者的5%。第一财经
发布会结束后,GitHub Copilot 的价目表上就能查到 MAI Code 2 的价格。MAI Code 2 每百万输入 token 0.5 美元,输出 2.5 美元,促销价到 2027 年 5 月 17 日。 Claude Opus 5.5 是 4 美元和 20 美元。两项一除,都是 12.5%。GitHub Docs
12.5% 是 5% 的 2.5 倍。两个数都不算假,只是口径不同。5% 是微软在自家选的四个编程基准里,跑完一个任务后的总成本;12.5% 是价目表上的 token 单价。
任务里输入输出各占多少、模型要重试几次,都会把这两个比例拉开。如果 Code 2 在一次任务里生成的 token 更少,5% 就可能成立;但少多少,只有微软的评测脚本知道。微软没公布每个任务具体烧了多少 token,5% 目前只能算官方自报。
价目表倒写得很细。促销结束后,输入涨到 1 美元,输出涨到 5 美元。还是拿 Opus 5.5 比,促销期是 12.5%,之后就是 25%。拿 GPT-6.1 Sol 比,促销期是 25%,之后是 50%。做今年的预算和做明年的预算,不能用同一张纸。
有人把这张表逐项除了一遍,结论一样:对 Opus 5.5 是 12.5%,对 GPT-6.1 Sol 是 25%。知乎
这不完全是文字游戏。企业最后付的是任务账单,不是 token 单价。一个模型如果输出更短、重试更少,单价高也可能更便宜。问题在于,微软只给了比例,没给每个任务的 token 账。采购方没法拿自己的代码库复现,只能先信,再试。
Code 2 只是其中一款。五款本次发布的新模型及升级版本:面向编程的MAI Code 2和MAI Code 2 Flash、面向网络安全的MAI Cyber 2 Flash、实时语音对话模型MAI Realtime 1,以及决策模型Microsoft-Decision-1.1。智东西
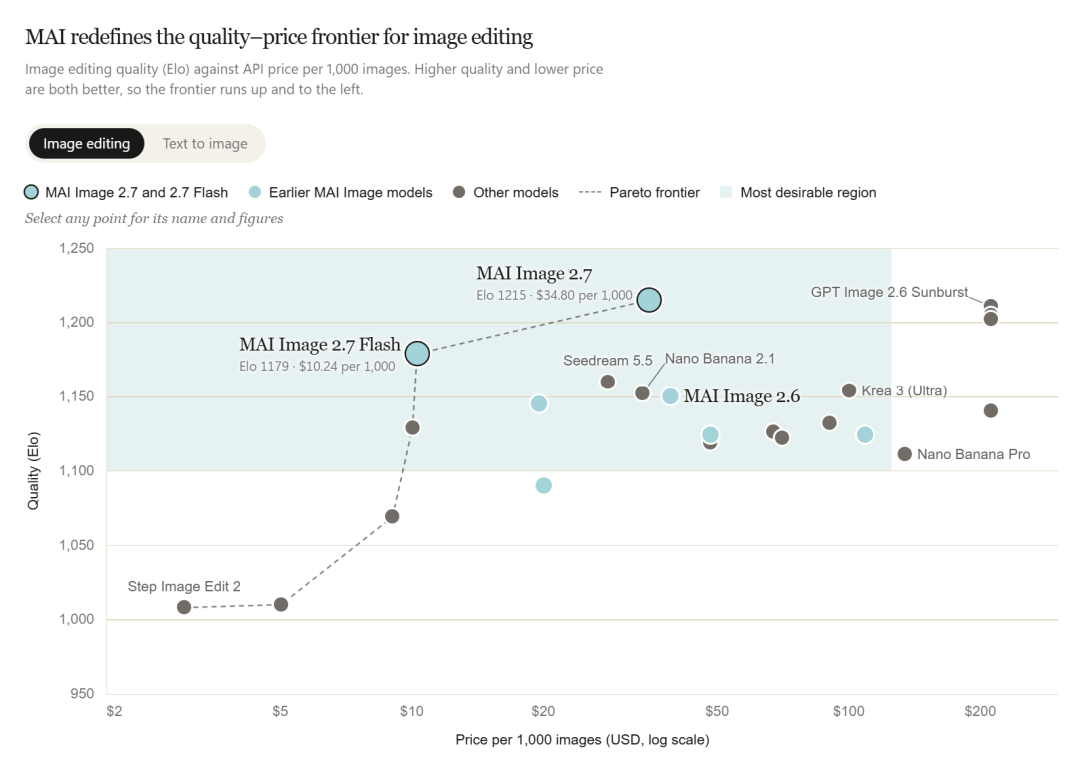
Code 2 Flash 管代码解释和局部修改,Cyber 2 Flash 管漏洞检测,Image 2.7 在图像编辑榜上升到了第一,价格压在对手的五分之一。它们不只放在模型列表里,还直接接进 GitHub Copilot、Microsoft Foundry 和 Copilot 工作流。
支撑低价的还有芯片。微软官方说,Maia 200 是它部署过的最高效的推理系统,每美元性能比现有系统高 30%。 模型跑在自己的芯片上,成本才有往下压的空间。微软
但边界,微软自己写在了发布材料里。Code 2 明确还没为更难的题目调优,比如基础科学研究,以及跨度很长的智能体任务。 这句话比 5% 更值得看。它说明 5% 对应的是一类被挑选过的日常企业编程任务,不是所有写代码的场景。知乎
真要选模型,别从新闻稿里的百分比开始。先把自己的任务拆成输入和输出:一次代码审查带多少上下文,一次重构要生成多少行,失败后重试几次。
再按价目表算三档:促销价、促销结束价、缓存命中后的价格。如果原来用 GPT-6.1 Sol,把月账单乘 0.25,是促销期的粗算;乘 0.5,是促销结束后的粗算。这个算法只含单价,不含重试和路由,只能当粗略参考。最后拿十几条真实任务跑一遍,别用基准平均分代替自己的仓库。
对个人开发者,最直接的变化是 Copilot 里多了一个便宜选项。对团队,真正的看点是价目表终于能查了:每百万 token 多少钱,促销到哪天,之后涨多少,都写在明面上。宣传比例可以变,价目表会留在那里。

当前文章无评论,是时候发表评论了