从TP2党到6台党:这周所有Spark集群实测数字摆在一起,拐点比你想的来得早
DeepSeek-V4.1-Flash 开源那晚(9月10日发布,性能超旗舰、降价开源并下线旧模型。)B站"困梦的杂物间"的评论区还在嘲笑折腾集群的:两台 Spark 装不下的东西,想都别想。一周后,这位自认"坚定TP2党"的UP主自己在回复里补了一句"结果一不小心6台了"。36氪哔哩哔哩
这不是个例。这周中文本地部署圈最热闹的现场,不是"哪个模型强"——那是上周吵完的事——而是一台128GB统一内存的DGX Spark,到底要串几台才配叫"本地跑V4.1 Flash",以及第几台开始是白花钱。我把散在B站、知乎、微博、小红书和GitHub issue里的实测数字对了一遍口径,发现这个圈子正在集体撞上一堵墙:钱越花越多,边际收益在TP4附近断崖。
先把各档数字摆平:速度、KV池、上下文,全是拆东墙补西墙
先说清楚:以下全是社区实测,官方从没公布过多机部署数据,各家引擎、量化档、任务类型(prose/代码)口径不一,横向对比看趋势,别抠单点数字。
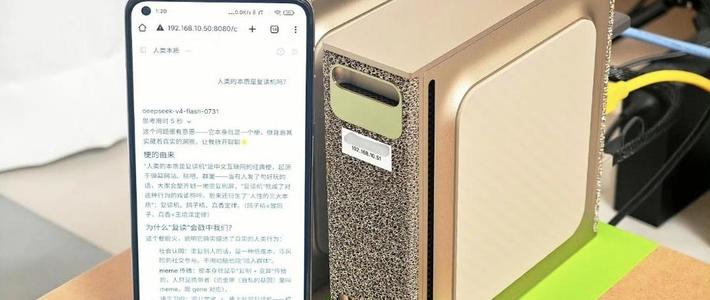
双机档。 MiaAI-Lab 用 EXL3 量化把权重压进两台 Spark(V4.1-Flash 原始权重552B,量化后约300GB,常规档两台256GB物理装不下,这是所有折腾的起点),微博9月13日晒出的结果是二路并发约42 token/s。知乎9月15日的教程走的是另一条路:DeepSeek-V4.1-Flash 的模型文件约为510GB,而一台 DGX Spark 只有128GB统一内存,靠非常规调度硬点灯。能亮不等于能跑,同平台一条测试视频的标题已经替它说了话:dgspark跑27b只有8token?跑本地化还得用服务器!新浪微博知乎哔哩哔哩
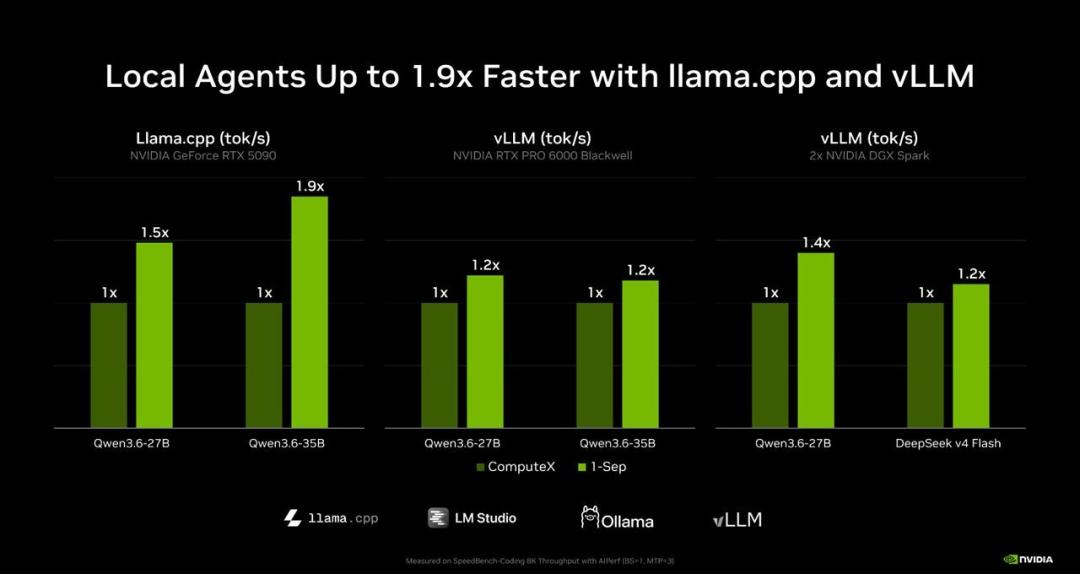
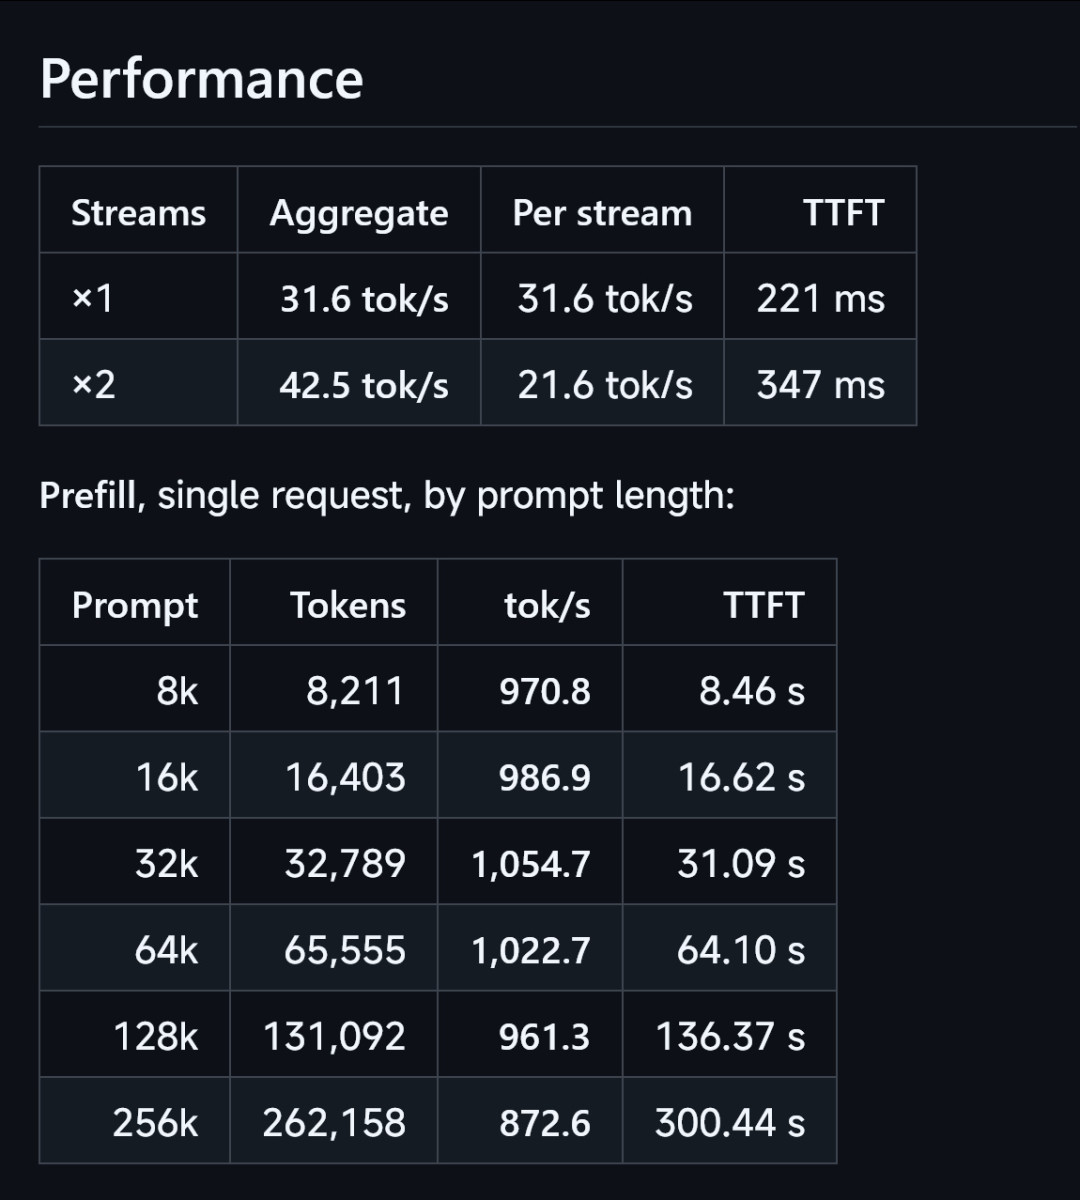
三机档。 微博9月12日的数字最扎心:3台能跑到37.9tok/s(作文)、TTFT 248ms,上下文32k约等于不可用。同一个模型,MiaAI-Lab 在 GitHub issue #11 里的三机测试又是另一幅面孔:上下文拉到1M,“速度可以接受,个人使用够了”。同一档硬件,一个说不可用一个说够用,差别就在你愿不愿意为长上下文让出KV池。新浪微博GitHub
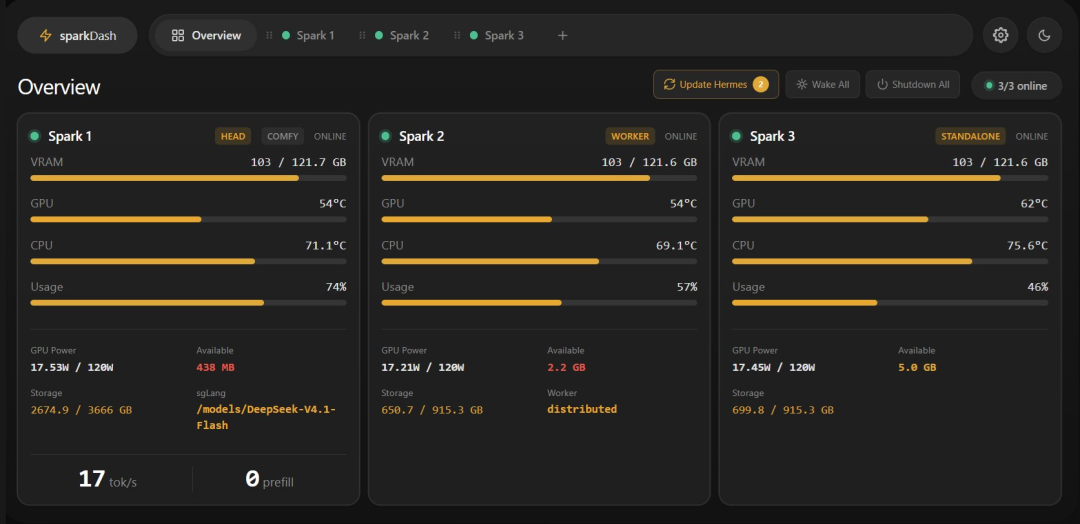
四机档。 这是这周信息量最大的一条实测(B站9月13日,4×DGX Spark 无交换机环路TP4):预填充速度持平,但升级V4.1相比V4 decode 衰减约30%,调优后压到10~20%;真正的痛点是 KV池从7.5M被压到2.5M——也就是说,硬件加了一台,上下文预算反而缩水,调优后才拉回4M左右。评论区有老哥给的替代参照是 TP4 跑 GLM-5.3-Flash:冷 prefill 2K 出头、c1 prose 40 token/s、bf16 KV 能到3.5M且长上下文不衰减。哔哩哔哩
八机档。 解码能去110 tok/s(代码场景)。到这一档,已经没人讨论"划不划算",因为那台数的人基本不在消费级预算里。新浪微博
然后是所有TP4党都没写在简介里的坑:9月13日有人实测发现新内核7.0会把四机环网TP4性能直接腰斩,得回退6.17。你多买的那台Spark的钱,可能先被一个内核更新吃掉了。哔哩哔哩
算总账的人终于出现了:“四台已经滑入不划算的区间”
把这台数换算成钱:国行 DGX Spark 1TB版本约29500元、4TB版本36999元。(微博9月13日的购机账贴)而评论区普遍反映这轮"价格涨了不少",四机方案落地已经在十万级。新浪微博
对照云端这边:官方9月9日官宣最高降60%,V4.1 Flash 上线后直接全面替代 V4 Pro、价格也按 Flash 算。也就是说,你纠结要不要凑四台的那个模型,API价格这周刚被打下来一截。评论区那位"一天大概烧200(ds4.1)、多个会话一起改"的重度用户看得最清楚:按他的用量,四台Spark的折旧要摊快两年,而这个token速度他"没法接受"。36氪36氪哔哩哔哩
社区这周的三句反方原话,值得每个想加机器的人抄在购物车备注里:
“能用API就用API吧,硬件的坑很大,用的时间可能还没部署折腾的时间就呢,尤其是最近模型更新频率很高。”哔哩哔哩
“模型更新得太快,一半时间都花在了折腾部署上,真正用的时间反而缩短了不少。”
“从目前来看,四台已经滑入了不划算的区间了,4.1的能力并不太强,只是速度快,性能和GLM-5.3-Flash几乎无差,但是token的消耗量却要大很多,本地有点累赘了。”
更要命的是版本追涨:这轮双机方案是为V4.1-Flash重做的,上一轮0731版V4-Flash的用户结论恰恰相反——“全都试了一遍,最后感觉还是2台部署deepseek0731的性价比最高”。模型每变大一次,你的TP2就旧一档(“还没吃上 2 台呢,2 台已经不够部署最新的 deepseek flash 模型,照这个趋势下去将来模型还会变大”),这条评论下面没人反驳,因为大家都看见510GB的文件夹了。哔哩哔哩
所以谁该继续买,谁该停手,谁该再等等
数字摊开到这份上,答案反而清楚了:
该买的只有一种人:数据出不了门的人。"日常办公啊,能处理本地80%的日常工作还是很好用的,API不允许使用。有涉密要求无解。"这条评论没有一条反驳,因为立场完全不同:对财务、政企、涉密场景,本地不是性价比问题,是合规问题。这类人这轮的实际选择是双机EXL3或维持0731的TP2,四台起步的讨论跟他们无关。哔哩哔哩
该停手的是"加一台凑TP4"的中间派。 KV池7.5M→2.5M的教训很直白:TP4不是"买第四台送1M上下文",而是一整套重新调优——散热(有人用微星版定频2200+3D打印散热件,甚至有小米空气净化器套件的野路子)、内核回退6.17、vllm的KV优化还没落地:官方这轮宣传KV缓存大幅缩减,但社区实测得到的答复是"需要vllm之类引擎支持,现在还不行,后续更新应该可以解决"。买第四台的钱里,有一半会花在这周的折腾税上。哔哩哔哩
该等的是观望党,等三个信号:一是vllm/推理栈什么时候吃下V4.1的KV压缩,这决定三机档"32k不可用"是不是死局;二是海外博主已经在做的 M5 Ultra 对 DGX Spark 对决,B站9月15日刚出中字实测。Mac阵营"再大下去苹果512G studio直接通吃"的调侃会不会兑现;三是NVIDIA在IFA2026刚预告10月发售的RTX Spark Windows PC和PAIR互联生态——这套一改,今天按"几台Spark"建的账本可能要重算。哔哩哔哩新浪微博
至于"本地部署到底值不值"这种大而空的问题,这周圈子里其实已经用脚投过票了:晒DDR5服务器条开箱的、咸鱼蹲第三台的、空气净化器改机箱的,没有一个人是在算token自由账——他们算的是另一笔账:数据在自己硬盘上的那笔安心账。这笔账API永远报不了价,但也永远轮不到TP4才买得着。(文中多机数字均来自社区单一样本公开实测,各家引擎、量化与任务口径不一,仅作趋势参考,不构成购买建议。)