这两天,镜友的群聊和信息流集体进入"天文名词翻译"环节:有视频把"1分钟拍百万恒星"安给了星语望远镜,有标题写"星语望远镜观测到8颗超新星",知乎评论区还有人一本正经地拿"30分钟上万平方度"去换算视场——换算的对象本身就错了。把国家天文台9月18日的官方披露、央视这几天对冷湖的报道全部对读完,可以下一个结论:这一轮刷屏,多数标题把两件事、两台"镜子"混成了一件。知乎
先把谁是谁捋干净,再算三个真正值得记的数字。
一、四个名词,一个是AI,一个是镜子,一个是阵列,一个是仿真台
天语望远镜:是一台真实的镜子。9月5日在青海冷湖赛什腾山完成首光,国内首台大视场、亚秒级采样的1米级巡天望远镜,也是上海交通大学光谱望远镜(JUST)的先导望远镜,2022年立项,由李政道研究所牵头、中科院上海天文台研制。1米口径主镜配大靶面科学相机,单次拍摄覆盖近9平方度天区——相当于40多个满月排开的面积,能探测到比人眼极限暗约50万倍的天体。“1分钟摄下逾百万颗恒星"是它的成绩:首光一张曝光,把天鹅座的北美洲星云、鹈鹕星云和周围银河里的上百万个天体一起收了进来。它真正的看家本领不是拍得多,而是"看得广、看得快”:收到天文警报能快速转向目标,还能对监测过的天区"倒带回放",帮科学家追溯事件发生前后的天空。调试完成后,预计2026年10月启动科学巡天。人民网光明网
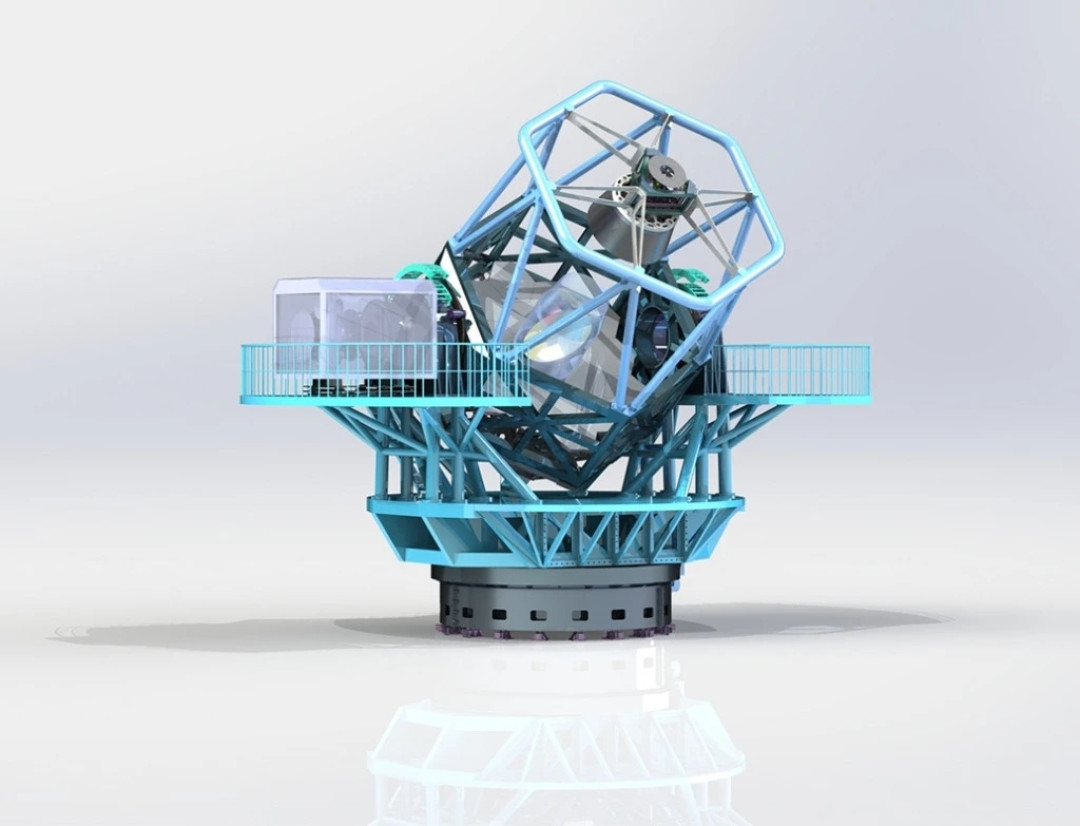
星语望远镜(StarWhisper):它根本没有自己专属的镜子。这是国家天文台刘继峰研究员团队牵头发起的天文具身智能观测系统,由银河系三维结构组与兴隆观测基地合作开发,把大模型、智能体和望远镜控制系统接进同一个闭环:先由跨巡天对齐时序模型从多巡天数据里挑出极早期超新星候选——解决"看什么";再用短时局部气象模型综合云量、风速、湿度评估观测条件——解决"怎么看";然后智能体综合科学目标优先级、设备实时状态和可观测窗口,完成"状态感知—任务规划—方案生成—流程验证"。它的智能体框架已经接入"司天"探路者和"司天"原型机,相关工作入选斯坦福HAI《人工智能指数报告2026》科学章节的代表性AI智能体案例。中国新闻网新华网
"司天"工程(GOTTA):是那个"天"字辈里最大的棋盘——我国面向时域天文学提出的大型分布式米级巡天望远镜阵列,目标是全球百余台1米级宽视场望远镜对全夜空做高频次、多色持续监测,专门捕捉超新星、中子星并合、黑洞撕裂恒星这类极端事件的早期信号,已入选联合国教科文组织"科学十年"计划。星语的Agent接的探路者和原型机,就是这个阵列的前哨。而这类宽视场时域巡天的标准产出形态,冷湖这台1米镜已经交了样:一次曝光,近9平方度,百万颗恒星。知乎

千问办公与那套"3天、千元"的仿真系统:官方通稿里被混在同一条新闻里的另一件事。望远镜组件和传感器接口被封装成MCP标准接口,Agent在其中可以反复试错。它的正确位置,是下面三笔账里的第二笔。新华网
二、三个数字,比四个名词更值得你记住
第一笔账:8和2。 官方的原话是"预警8颗极早期超新星候选,其中2颗在天气条件允许的情况下触发了后续观测"。注意三个限定词:候选,不是确认;触发观测,不是拍板科学结论;天气允许,说明调度之外的硬约束还在。标题写成"观测到8颗极早期超新星",目前从严谨口径上是超纲的。但这不构成降级的理由——时域天文学的第一性原理就是抢爆发后那几个小时,极早期阶段的亮度和光谱变化快,有些特征几小时后就永远消失,早一小时拿到光谱,和晚三天完全是两种科研价值。真正该盯的后续指标,知乎上一篇高赞回答列得很清楚:候选最终确认率多少?识别比既有流程早多少?误报漏报各占多少?同样的望远镜时间,是不是多换回了有效数据?这些数字官方还没公布,在它们公布之前,"新范式"三个字都值得保留一点耐心。新华网知乎
第二笔账:千元对数万元。 国际主流10米级地面望远镜,一个有效观测小时的运行成本可达数万元。更麻烦的是,镜筒、转台、相机的联动意味着错误的控制指令可能直接伤设备,而"三颗高价值候选同时出现、凌晨天气突变、某台望远镜宕机"这种局面,现实里根本没法按开发计划排练。所以先用仿真镜喂Agent,再让策略去碰真镜子,路径本身是对的——过去需要数月、数万元的专业仿真开发,被压到了3天、千元级。但两件事要说清:第一,被压缩的是开发周期,不是科研验证,"核心环境搭建"和"仿真系统通过科研验证"是两个不同的里程碑,"科研级"应当对应具体用途、误差范围和验证结果,而不是由开发速度背书;第二,仿真只能验证被建过模的情形,策略如果在仿真里利用了不真实的假设,上真机照样翻车。知乎
第三笔账:80万对700万。 薇拉·鲁宾天文台2026年2月24日一个晚上发出约80万条科学告警,全面运行后预计最高每夜700万条,公开告警约两分钟内就能发出。候选可以随着巡天能力无限膨胀,地面望远镜的时间却是常数——这才是AI必须进入观测调度的真实原因,而不是"大模型会看星星"。顺带把功劳分配说公道:望远镜的自动排程早就成熟,Las Cumbres观测网已经把全球7个站点的27台机器人望远镜当一个整体在管,计划每小时重算多次;而早在这一轮之前,BTSbot就已经用专用机器学习模型自主触发过超新星SN 2024jlf发光后约17小时的光谱。大模型Agent的增量在于降低系统之间的协调成本——用自然语言提任务、把工具链串起来跑通;精确的坐标计算、图像测量和仪器控制,仍然交给经过验证的专业程序。识别算法、调度系统、大模型各拿各的功劳,别打包。知乎知乎
三、你手里那台镜子,和这条新闻有什么关系
第一层关系比想象中近:星语在2025年发表的论文里,这套串联了观测规划、望远镜控制、图像处理和暂现源跟进的系统,最初就是部署在10台业余级望远镜组成的网络上——这类科研Agent的起点不是十米镜,而是和你家阳台上同一段位的镜子。当然,边界也要如实讲:那个版本的观测计划仍需天文学家审核,部分后续观测和硬件故障处理依赖人工。官方给AI的定位从头到尾都是"参与执行流程",不是"独立做科学判断"——科学家提出问题、设定目标,智能体跑观测、做验证、给迭代,最后一锤仍然在人。知乎
第二层关系是入口可能正在打开:科研团队透露,星语相关成果将陆续上线中国科学院"磐石"科学大模型平台,推动天文领域模型、工具与应用能力的共享复用。知乎星语问题下已经有镜友在讨论其相关开源工具与NINA这类业余观测框架的衔接。社区的声音值得听,但先别当事实用。更具体的一步是:天语10月启动科学巡天后,如果国内的时域告警逐步公开,业余望远镜做暂现源后随的参与门槛,可能比多数人预想的要来得早。新华网知乎
第三层关系是避坑:看到"AI望远镜"三个字就准备下单的,先分清楚商家说的是哪一层。目前消费端产品页里的"AI",基本还是自动对焦、目标识别、叠加拍摄那一套;而星语解决的是观测调度层的问题——两者只是共享了一个热词,不共享同一代落地进度。
这轮信息流混乱本身倒是个不错的提醒:2026年的秋天,天语开始巡天、星语继续攒候选、司天阵列往前推——国产时域天文学的戏份会越来越多,名词只会越来越多。先把"镜子是镜子、AI是AI、阵列是阵列、仿真是仿真"这四句存下来,再回头看任何一条刷屏标题,基本不会被带偏。
至于观测本身:天语首光拍的是天鹅座,这个季节入夜后它正挂在南方天顶附近,双筒沿着银河扫,北美洲星云的轮廓就在你眼前——它拍下的"百万恒星",和你在望远镜里看到的,是同一批光。