9月17、18号这48小时,B站配音区罕见地连着冒出三条同方向的中配:MarfilDraws的《2026本地LLM硬件实测》把Mac Studio M5 Ultra、DGX Spark、小米AI Cube摆在一起;紧跟着他的《Don’t Buy Local AI Hardware Until You Watch This》,从二手RTX 3090一路算到DGX Spark的带宽、转售价和电费;再加上Kai那条M5 Ultra对Spark的“大对决”中字。同期,4台Spark组TP4跑DeepSeek V4.1-Flash的踩坑实测视频下面吵了124层楼,小红书上一位Spark用户发帖《刷机救砖》拿了48条评论。
说白了,这周本地部署圈真正在吵的已经不是"哪个模型快",而是一个掏钱问题:三万块上下,要不要给本地大模型配一台专用主机。这篇不下"买哪台最强"的结论——现在也没人有资格下——我把这几条横评和踩坑帖里的数字拆开,标清楚每个数目前站在哪一档证据上,你对号入座。
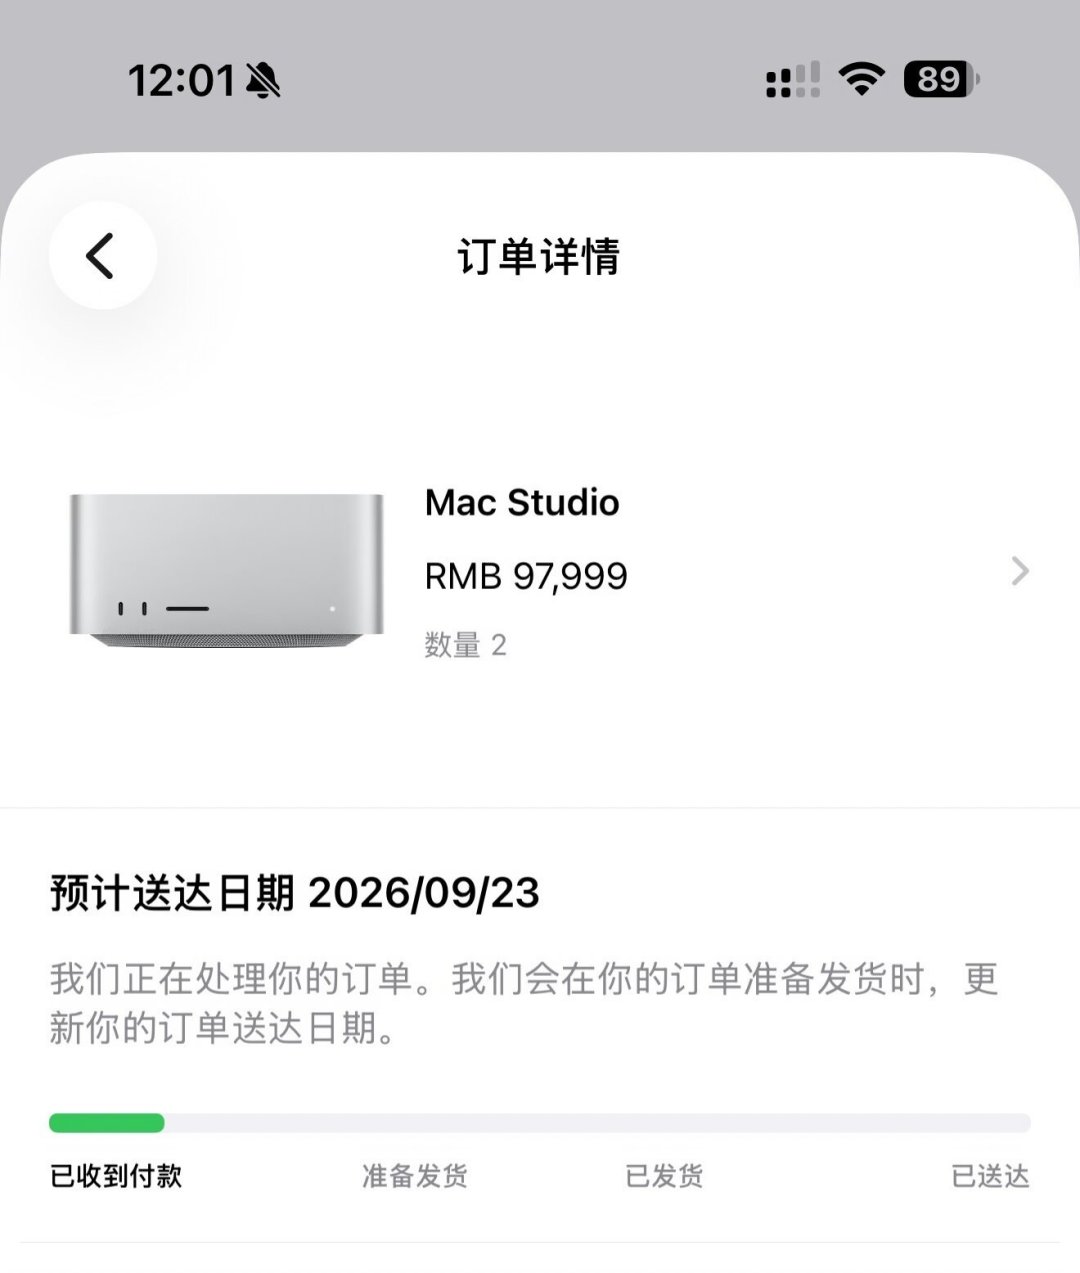
M5 Ultra:1.2TB/s是真的,"实测"也是真的没有
配音圈那批视频给这台机器的账面参数是一致的:36核CPU、80核GPU、最高512GB统一内存、内存带宽1.2TB/s,美区起步价$5499。这个纸面很唬人——512G意味着不用纠结量化,理论上能塞下不少以前只能集群跑的权重。哔哩哔哩
但MarfilDraws在三机对比里专门强调了一句:M5 Ultra尚未有独立实测,“$5499对比小米Cube"那条严格说是量产机跟概念机的同台。而社区的经验判断反而更具体——在Spark TP4实测视频的评论区,有条被多次回复的观点我认为是目前对"投Mac还是投N卡"最实在的描述:Mac方便省心,但长上下文的prefill速度和多用户并发是短板;单流短任务(写作、代码补全这种)Mac会强很多,多并发长上下文打不过多台Spark,前提是"等M5U评测出来再说,不理想就加一台Spark跑V4”。哔哩哔哩哔哩哔哩
对位人群:一个人用、任务短、受够了调环境和折腾,512G的容量确实对口。但这条路线现在买的是纸面参数。观察信号就一个:第一批独立实测什么时候中配进B站。
小米AI Cube:295 tok/s没造假,但它测的不是你会买到的东西
8月24号玄戒发布会之后,Cube的话题度一直在线(现场体验视频14万播放,工程版官宣3.9万赞369评)。许斐8月底的微博把演示规格说得很全:玄戒O3+O100+D100三芯,本机部署120B+3B双模型、快慢系统切换,航天铝一体成型、CNC打了33874个散热孔;更早的沟通会上,O100端侧原型机报过"实测每秒295个token"。微博
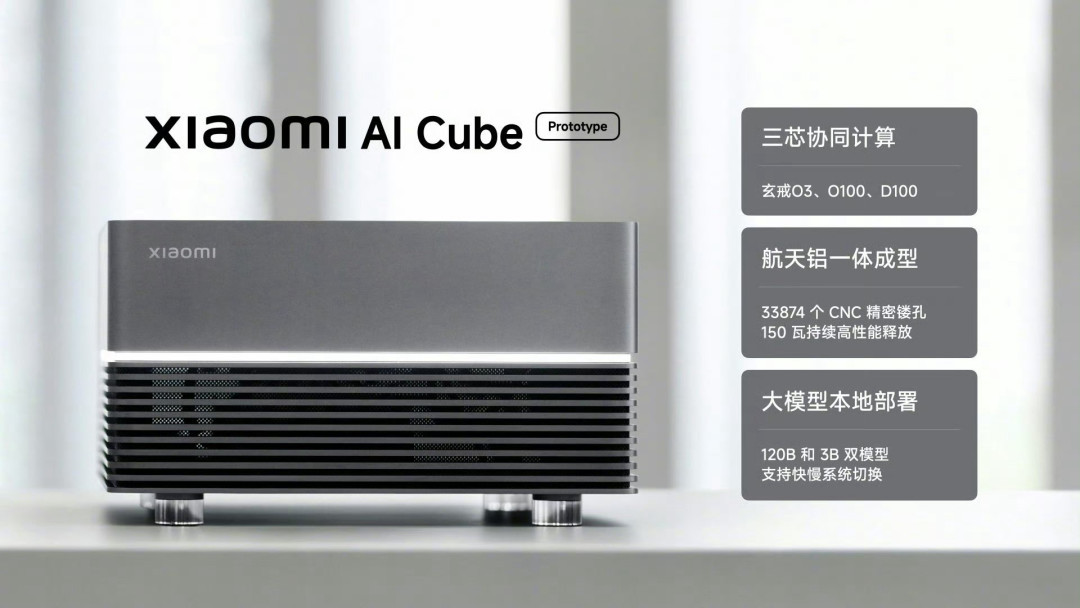
问题出在两个"官方口径"之外。第一,截至本周它仍是原型机,官方给O100和D100定的节奏是明年才量产应用。整机统一内存的账面数字也只有80GB,可闲鱼上已经出现"现货"话术的渠道帖——这是我要划的第一条红线。第二,MarfilDraws三机对比里点破了一个数字游戏:Cube宣传的高带宽指的是近内存链路,不是整机总内存带宽。这两件事叠在一起,295 tok/s和120B这些数字对普通用户暂时都只是演示。微博哔哩哔哩
对位人群:等国产端侧算力这条线的,现在的正确姿势是蹲正式发售的定价和第三方总带宽实测,任何"首发代抢"都别碰。
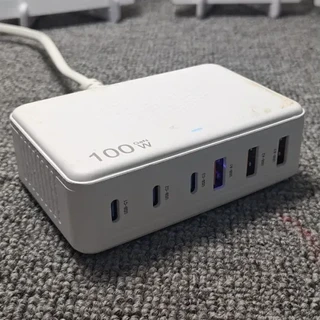
DGX Spark:8 t/s和"跑分姿势不对"同时存在,才是它的真实画像
这台最复杂。128GB统一内存+4TB,GB10芯片,渠道帖里还挂出"约1000 AI TOPS"。买过的人本周晒的账是这样的:三个月涨了5000——“说实话它只值3万,多那5千全是炒作”。另一头,小红书渠道在传"厂家封仓、现货收紧",华硕GX10、微星EdgeXpert这些GB10同门机器也跟着起价(8台GX10跑748B的实测视频已经干到1.3万播放)。哔哩哔哩
机器本身是坑与甜点并存。坑这边:9月13号有人实测新内核让4机环网TP4性能腰斩,需要7.0回退6.17。刷机救砖帖里"国内网络给Spark升级花了一天、中途一台变砖,普通用户能玩得转?“。Windows ARM版驱动至今不全,商家原话是"预计只能等RTX Spark正式发布”。哔哩哔哩小红书
甜点的证据在困梦的杂物间那条4台TP4实测(4995播放、95赞):552B约300G的权重两台确实装不下。但评论区玩家给出的性价比共识反而很收敛——“全都试了一遍,最后还是2台部署DeepSeek 0731性价比最高”、“三台跑起来、上下文1M、个人使用够了”、再往上"四台已经滑入不划算区间"。功耗倒是惊喜:官标240W,实际单机用户报"CPU/GPU最大140W,日常80W顶天"。哔哩哔哩
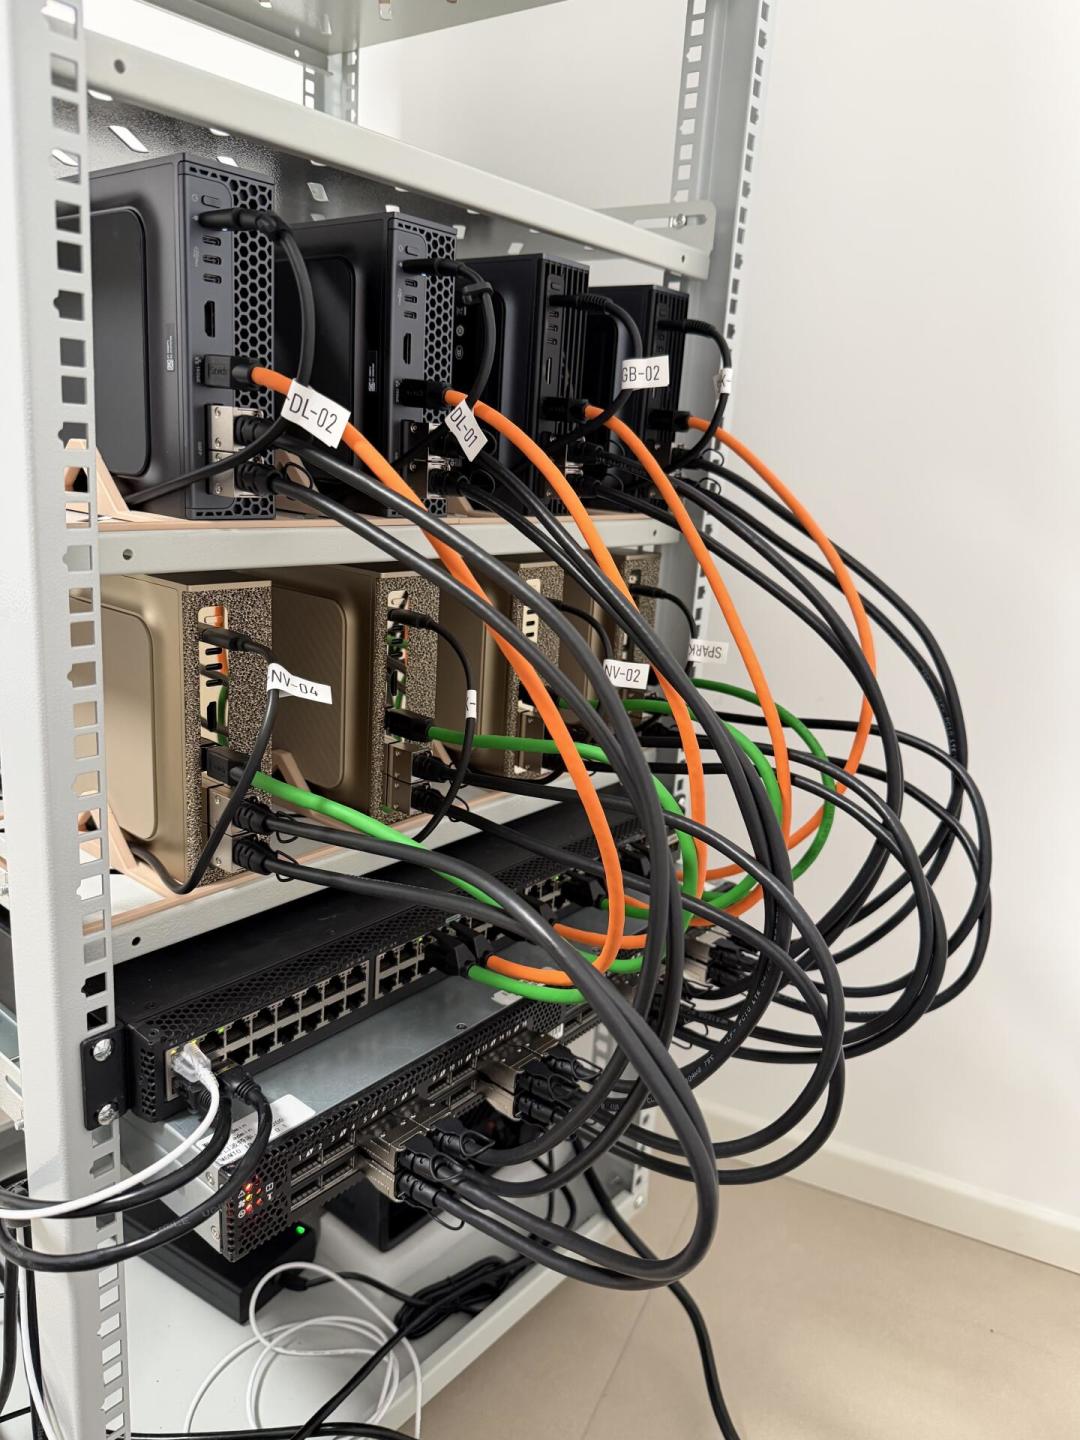
“dgspark跑27b只有8token"那条视频发布于9月12日。六天后另一条视频给出的说法是"跑分姿势不对、单用户测试体现不出真实力”。这两条摆在一起,恰恰是这台机器的画像:它的数字强依赖你的用法——单流短上下文、多机并发、长上下文灌满,是三个完全不同的Spark。评论区还有一句反方我原样保留:"能用API就用API吧,硬件的坑很大,用的时间可能还没部署折腾的时间长,尤其最近模型更新频率很高。"小红书那位一周连换三个模型的单机Spark用户,应该是这句话的知音。哔哩哔哩哔哩哔哩
对位人群:需要CUDA生态、打算2-3台起组、或者要给几个人并发做私有化的,这台是目前证据最完整的。只买一台图省心的、怕折腾内核和刷机的,再想想。
第四个数字:先租一周云,把"我到底跑不跑"验证掉
MarfilDraws那条"先别买"的视频,结论其实比三机对比更值钱:把二手3090、Spark、Mac Studio的带宽、转售价值、电费和隐性成本放在一起算之后,他给普通人的建议是——先上云租算力小规模跑一周,再决定买什么。背景还有一条:他提到当前处于内存涨价周期,主机成本本身在往上走。这条对"我缺一台机器"和"我缺一个用途"没分清的人,是最便宜的止损。哔哩哔哩
底线判断
本地这条线今年确实站住了:据36氪和经济参考报报道,信通院可信AI的MCP专项基准里,27B量级的本地模型StartLux(基座Qwen3.6-27B)拿到39.25%,离1.6万亿参数的DeepSeek-V4-Pro只差1.3个百分点,把284B、198B两款云模型压在身后。从业者给的口径是"跑得动20B-100B的整机在1万到6万"。本周北京印发的《词元经济发展行动方案(2026—2028)》也把模型轻量化和边缘部署写进了支持方向。知乎微博
但"值得存在"和"值得你现在下单"是两件事。我的底线判断就三行:任务短、一个人用、要省心——等M5 Ultra的独立实测;要生态、能接受折腾内核和刷机——Spark 2-3台是当前证据最厚的一档;只是想要"免费的token"——云API输出价已经打到4元/百万,你缺的不是机器,是用途。
你现在手头是什么卡、什么用途?评论区报个配置和任务,我看看这四台里哪台的坑跟你无关。