如果你正在维护一个企业 AI 知识库,这一年大概过得挺拧巴:向量库建了、embedding 换了、chunk 调了七八轮,然后首页开始告诉你 RAG 死了——Agent 该用回 grep,Karpathy 搞了个 LLM Wiki,Codex 用一堆 Markdown 管记忆,连"不用向量库的新方案"都被称为要掀翻整个行业。
我把知乎、小红书、B站、微博近半年围绕这场争论的帖子拉了一遍,光是知乎相关的 6 条高热度回答,浏览量合计就超过 240 万。翻完发现一个关键问题:发"死亡通知书"的帖子和晒"落地账单"的帖子,吵的压根不是同一件事;而"哪一派更强"这个问题本身没法赢,因为各路选手的语料和问题类型完全不同。
如果你的知识库项目正卡在这个岔路口,这篇帮你把四派的牌摊开,按你的场景直接抄答案。
一、"死亡"时间线:一场技术争论怎么变成集体焦虑
2024—2025 上半年:RAG 是大模型应用课的标配第一课,"一文读懂 RAG"式科普在知乎持续霸榜收藏。
2025 年:Claude Code 一类代码 Agent 进入开发工作流,用 rg/grep 现场搜文件,"先切块后检索"的范式第一次被大规模质疑。
2026-04:Karpathy 的 LLM Wiki 概念开始刷屏,社区转述 YC CEO Garry Tan 的"第二大脑":1,222 份人物档案、7,471 个 Markdown 文件、约 2.3GB——纯笔记库,不带向量库。B站同周就出现"告别传统 RAG"的复刻教程;一个月后谷歌也被社区热帖跟进:CodeWiki 把静态代码库转成可交互的"活体百科全书",自动附带源码链接并生成架构图、类图、时序图。微博微博
2026-06:小红书《RAG 已死一年了,如今死得怎么样了》拿下 1.7K 赞、2.1K 收藏;知乎专栏给出那句流传最广的判词:RAG 没死,死的是 naive RAG。知乎
2026-08:知乎问题"做 RAG 系统最难搞定的是哪部分",高赞回答第一句就是:最难搞定的是 RAG 已经基本上凉透了,这条回答浏览量 68 万。 它贴出 Codex 记忆子系统的拆解:SQLite 调度层 + 专职抽取模型 + Markdown 语义存储 + 主 Agent 自己读文件检索。知乎
2026-09/10:节奏更快——腾讯开源 WeKnora,把 RAG 问答、Agent 推理、自动 Wiki 做成三种模式。小红书热帖推 PageIndex:树状索引、不用向量库、不用嵌入、不用切块,官方在 FinanceBench 自报 98.7% 准确率。10 月 7 日又有公开课热帖称 Garry Tan 把 LLM Wiki 做成了工业级开源项目 GBrain,号称支持十万页级文档、融合知识图谱。另一边,中国计算机学会(CCF)的官方账号还在 9 月 15 日发科普,把 RAG 介绍为大模型精准答题的秘密武器。B站小红书微博
一个容易被忽略的细节:喊"RAG 已死"刷屏的同时,B站那条《2026年最全RAG知识库搭建教程》仍然有 28.8 万播放、1.07 万收藏。技术死刑和教程市场,不能当成同一件事——前者在回答"生产上值不值得",后者在回答"简历上值不值得学",两拨人别互相抄作业。B站
二、"死"派论据:谁递的刀、砍在哪个场景
汇总下来是四条(均有原帖可查,见文末来源):
成本清单。知乎 169 赞、27 万播放的回答《为什么现在 Agent 重新用回 Grep》列得很直白:RAG 平白增加网络延时和 embedding 成本、往用户本地塞一个巨大向量库、往上下文里塞一堆召回垃圾,“用一个几 B 甚至更小参数的 rerank 模型,来决定一个几百上千 B 的模型能看到什么”。结论:代码库场景,除非你有 chromium 那么大的仓库,向量索引的收益盖不住成本。知乎
naive RAG 四宗病。固定切块 + 固定 Top-K + 固定拼接的旧流水线:检索发生在模型理解任务之前,召回噪声大;chunk 把完整语义单元切碎;动态语料(代码、纪要)要持续增量索引,一致性是工程噩梦;不理解"找定义"和"做全局归纳"是两类任务。
替代范式。Codex 式记忆 + Agentic 检索:检索从一个固定前置步骤,变成了 Agent 推理过程中的一个可调度工具。PageIndex 这类新方案更是连切块和嵌入都省了。知乎小红书
低成本替代派。知乎 48 赞的《为什么现在 RAG 越少越少提及了》算了另一本账:一个 skill 文件就是一段文字,GitHub 下载零配置就能用;而 RAG 要搭向量库、付 embedding 调用费、处理增量同步,"能用 tool 解决的,为什么要搭一套 RAG pipeline?"以前工具多了要给工具库建向量索引,现在直接把全部工具描述发给模型让它自己挑——多花一点 token,省掉整套检索基础设施。知乎

但注意杀伤范围:这四条论据的弹药,基本都集中在"代码仓库、个人笔记、本地客户端、动态文档"这些 toC/代码场景。
三、"活"派论据:百万播放的落地帖说的是另一回事
"死"派刷屏的同时,做企业落地的帖子给出的数据是另一个方向:一位做千万级文档知识库的架构师转引 Gartner 报告称 85% 的全球 500 强企业已经部署或正在部署 RAG 系统。同一位作者紧接着给的自我经验更扎心:“80% 左右的 RAG 效果问题都源于数据处理不当”。注意这句话的指向——问题不出在范式,出在工程。知乎
电力行业从业者"卡卡带我飞"晒了两本账(其主回答浏览量 126K,另一条 107 万浏览的问答里是同一批实测):
准确率从 50% 提到 88%,全程零微调:无 GPU、无标注数据。手段按提升幅度排:扫描件高精度 OCR 重做、只人工校验约 20% 关键页;表格用 Camelot 单独提取、独立成块;按条款边界切分对比 512 字硬切,差距 15—20 个百分点;一个 7B 小模型做 query 改写,把"变压器嗡嗡响"改成三条标准术语 query,召回率 35%→80%;按文档类型分六库;加 CPU 就能跑的 bge-reranker,稳定 +7—8 个点;结构化引用 prompt,把幻觉率从 15% 压到 5% 以下。知乎
另一个项目 2000 多页 PDF 直接导入后,70% 的检索结果都是垃圾,花三周处理数据(版本清理、多模态转换)后,“同一套检索算法,数据干净了准确率直接涨 5—8 个点”。知乎
他给的最重一句话:框架对最终效果的影响远不如数据质量,同一个框架,数据干净时准确率 80%,数据脏时 60%——差距比换框架大多了。

评论区还有两条更扎心的反证,恰好打在"死"派软肋上:
小红书评论区里最直白的一条:grep 依赖结构化良好的目录,比如代码。公司文档库、wiki 都没那么干净,做不出一棵良好的树。同类观点在多个帖子评论区反复出现。小红书
另一条 55 赞的回复则顶住了范式之争:只要还有外挂知识库的概念和需求,RAG 就死不了,别指望上下文窗口——只要你不担心容积、折损和 token 消耗,倒是可以试试。
“活"派的痛也真实存在:小红书那条"知识库最难的,不是搭建,是更新”(461 赞)说的是长期运营,而不是范式之争。小红书
四、分歧的根子:吵阵营的人,都在交同一份学费
把牌摊平,这根本不是技术战争,是三道场景题:
语料变动速度。代码库、实时纪要 → 索引一致性是地狱,grep/Agent 现搜现查天然占优;稳定的规程、产品手册、FAQ → 向量库一次建好基本"免费"。
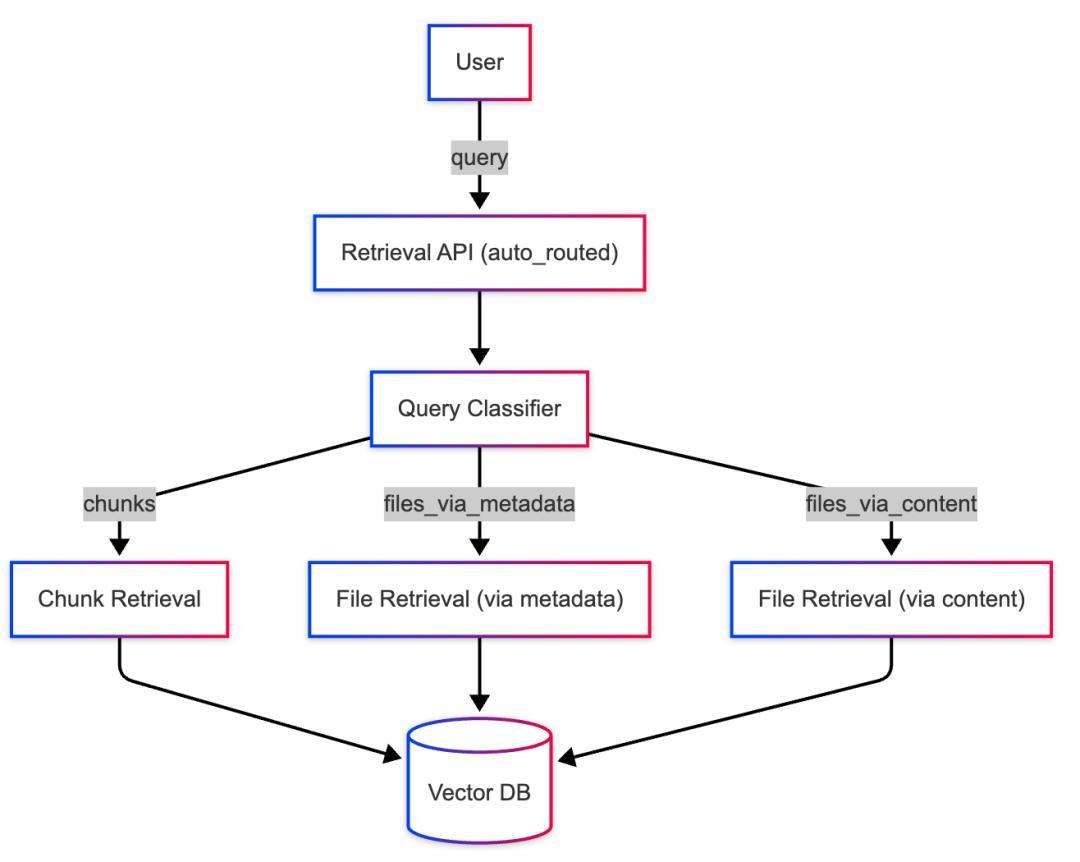
问题类型。“查具体条款、查参数”→ 检索最经济;“整个知识库的核心主题是什么、这几个概念什么关联”→ 切块-召回范式天然弱,GraphRAG、Ontology、树状索引、自动 Wiki 抢的全是这个位置。
模型够不够聪明。grep 派的前提是"给智商正常的模型一个 bash,它自己能找到"。但同一批实测里有人吐槽:60 个不超过两千字的文件,召回都搞不明白,就这还召回千万上亿文件?模型不会查,就得人来搭前置工程。知乎
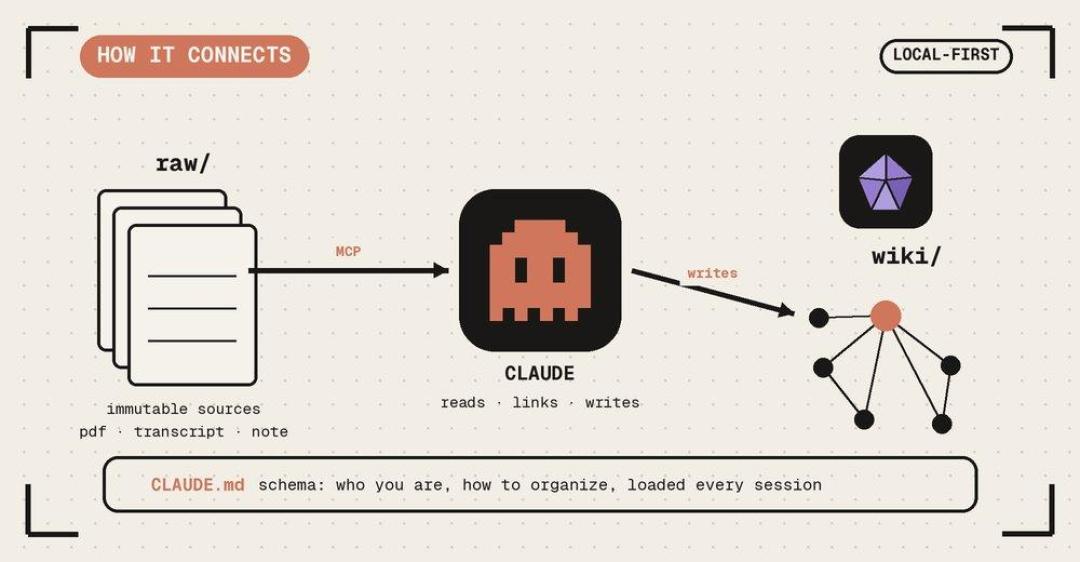
最容易被阵营战忽略的规律:四条路的前半段是同一条路。不管向量 RAG、LLM Wiki 还是 Ontology,清洗乱码、去页眉页脚、按结构切分、版本和权限治理,一样都少不了。Codex 的记忆方案,被拆解它的作者形容为:像上课记笔记一样,一笔一画记下来。Garry Tan 的 2.3GB 库同样是人工整理出来的纯文本笔记。Wiki 派不是不处理数据,只是把"给机器建索引"换成了"给模型编笔记"。换阵营,省不掉这笔共同学费。知乎知乎
五、按场景抄作业:你的情况站哪派
你的情况 | 站哪派 | 可以先不做 | 主要成本(按社区自报口径) |
|---|---|---|---|
企业 FAQ、规程、产品手册问答 | 传统向量 RAG 或混合检索,做到 88% 靠的是工程手段 | 不用跟风迁 Wiki | 数据清洗的人力(千页级文档约 2—3 天起) |
代码仓库检索、本地客户端 Agent | grep/ripgrep + 工具检索 | 本地向量库可以先删 | 多轮检索的 token 消耗与延迟 |
个人笔记、Markdown 多、想要长期复利 | LLM Wiki / 树状索引(PageIndex 一类) | 嵌入调用费可以先省 | 日常"编译整理"的坚持 |
企业文档表格/图表/扫描件多(有从业者转引 2025 年多模态 RAG 综述:30—50% 语义内容在表格图表里) | 任何一派都得叠多模态管道,分类型走三条管线 | 纯文本方案别硬上 | 表格结构化、图形转述是最重的活 |
全局归纳、主题关联类问题 | GraphRAG / Ontology / Wiki 型索引 | 别指望纯 chunk 召回 | 图或笔记结构的维护费 |
想让模型"懂行业语气" | 这时才考虑微调(表达风格、行业术语) | "不知道公司内部事"不要靠微调解决 | 防灾难性遗忘,生产端自报最稳的还是 LoRA、小学习率、混通用数据、replay 这些老办法 |
两个具体避坑(从业者自报):换嵌入模型等于重建索引,库里旧向量全部失效;用 pgvector 存 4096 维向量时注意 HNSW 对 2000 维以上的索引会静默失败退化暴力扫描,排查两天无日志,换 halfvec 才解决。知乎
六、接下来三步
先别删向量库,也别急着加库。拿你自己最常被问的 30 个问题测一轮:到底是"查不到",还是"查到了没读对"?多数项目死在脏数据,不死在范式。落地帖的自报顺序值得照抄:先清数据、按结构切、改 query、加 rerank,最后才动其他参数。
从零起步的个人库,先把纯 Markdown 笔记写起来。这是四派共同的学费,之后不管站哪派都不浪费——这也是"RAG 已死"吵了一年,真正没被推翻的那部分。
设两个观察信号:embedding 与长上下文 token 的价格曲线,以及 Agent 工具调用的成功率趋势。"RAG 已死"每隔几个月就复活一次,是因为模型能力在持续替人省下前置工程;哪天该让模型自己查,按你的场景算账,别按首页情绪。
你的知识库项目站在哪一派?换过阵营的、或者换完发现新坑更深的,评论区聊聊。