HBM不堆高了:英伟达Rubin Ultra从12层回撤改8层,AI存储战争换了计分方式
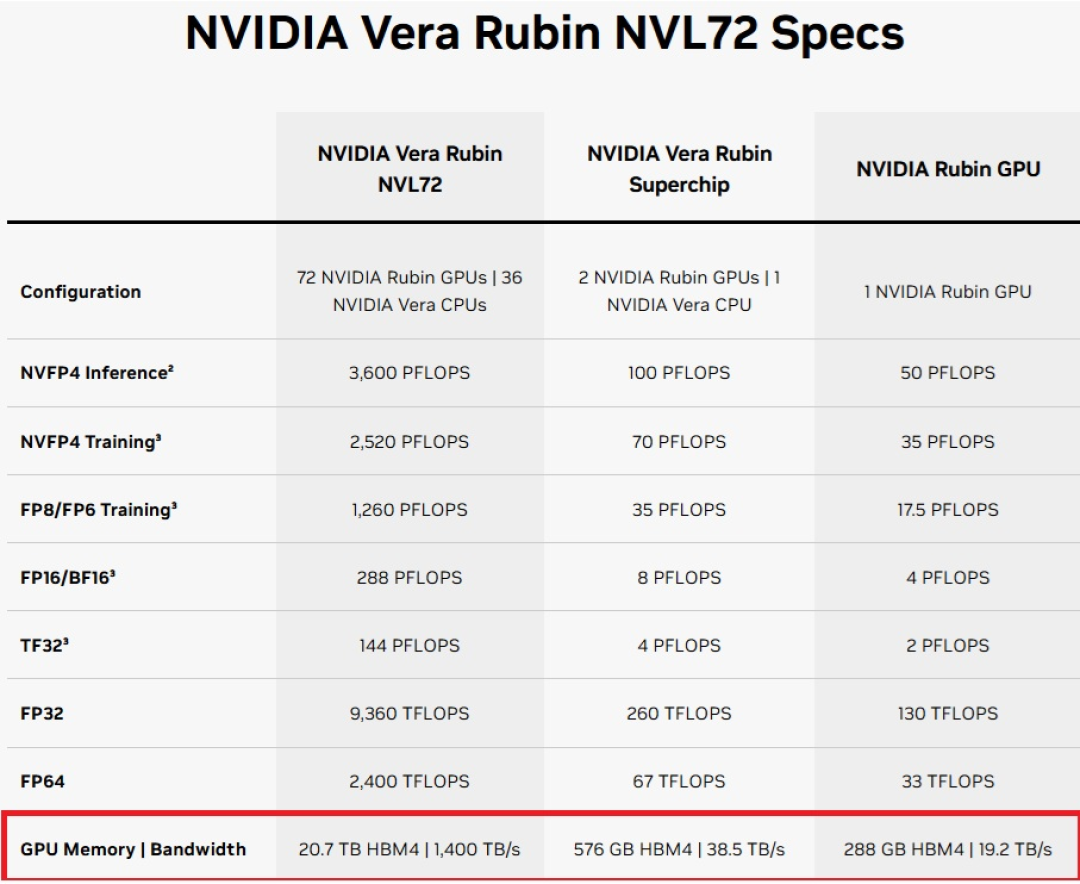
10月27日开始,ZDNet、Wccftech等多家外媒接连放出消息:三星和SK海力士准备从2027年第二季度起,向英伟达下一代AI加速器Rubin Ultra大规模供应8层(8-Hi)堆叠的HBM4。 而Rubin Ultra原定规划是第七代HBM4E的12层方案,单卡HBM容量一度指向384GB。与此同时,英伟达早在9月就悄悄把Vera Rubin平台每颗GPU的HBM带宽规格从22TB/s下调到19.2TB/s,降幅约13%,NVLink 6吞吐量也从3.6TB/s降到3TB/s。华尔街见闻
做集成电路和算力链跟踪的人,第一反应大概率是"英伟达降配了"。但把良率、成本、认证这三本账摊开看,会发现这更像一次对"怎么买到可交付的带宽"的重新定价——堆叠层数不再等于优越性,这个延续十年的技术共识,正在HBM4这一代被改写。
一、降层不是砍容量,是换了一种赚带宽的方式
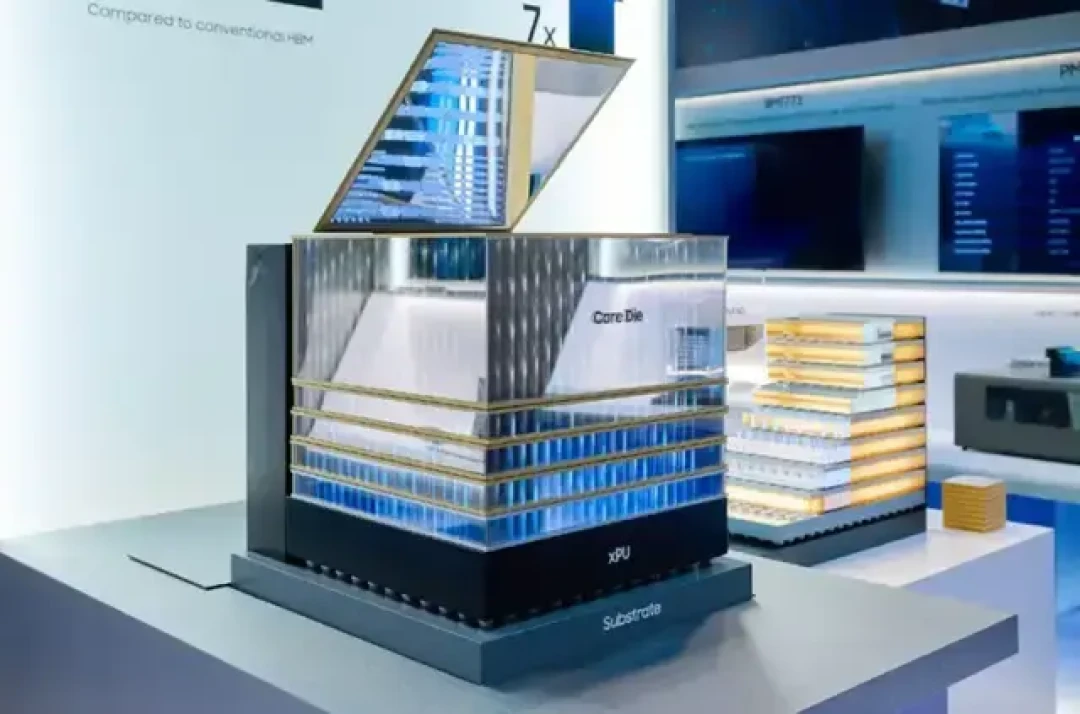
最先被牺牲的是"向上堆"的良率幻觉。HBM4把接口宽度从上代翻倍到2048位,层数每加一层,晶圆键合的缺陷概率就累积一层。做一个粗略的乘法:若单层良率99%,12层堆栈整体良率约88.6%,8层约92.3%;一旦单层良率滑到95%,两者直接跌到约54%和66%,差距拉到12个百分点。 更要命的是换算成"每个良品堆栈要烧掉多少颗DRAM芯片",从12层降到8层削减的芯片消耗是36%到46%,比表面的33%更狠——在DRAM晶圆产能是硬约束的年份,这才是决策者真正看的数字。电子产品世界
第二层逻辑是带宽和层数本来就不直接挂钩。容量近似于堆栈数×每栈芯片数,带宽却取决于堆栈数、接口宽度和引脚速率。在2048位接口和既定引脚速率下,12层降8层让单堆容量少了约三分之一,总带宽可以持平甚至小幅提升,单位容量对应的带宽反而上升约50%。而大模型推理是典型的带宽受限场景:每生成一个token都要重读模型权重和KV缓存,闲置容量不值钱,带宽才值钱。SemiAnalysis框架里那句"瓶颈从$/容量转向$/带宽",说的就是这个。
还有一条藏在认证里的暗线:Rubin GPU原定22TB/s带宽需要约10.7Gbps的每引脚速率,下调到19.2TB/s后门槛降到约9.4Gbps。三星、SK海力士已披露的HBM4速率达11.7Gbps(三星最高13Gbps)、美光超11Gbps,账面都够——但够得从容和勉强,决定的是合格率。降低指标,本质是让更多HBM4能过Rubin的资质认证,把产出曲线买回来。华尔街见闻
二、省下的BOM去哪了:内存账本与网络账本此消彼长
成本端更直白。若坚持12层HBM4E并计入涨价预期,内存可能占到Rubin Ultra整体物料成本的约70%;即便按温和口径,HBM占比也在40%上下。切到8层HBM4后,HBM成本可下降50%以上,内存占总成本比例从约40%降到28%。 但省下来的钱没有消失。在NVL576级别的机架系统里,光模块和Scale-up互联的成本占比从约4%升到12%。英伟达的取舍很清楚:砍单卡堆叠密度,把BOM空间挪给集群互联,用系统级带宽弥补单卡收缩——“单卡堆料"的时代让位给"系统级带宽成本”。电子产品世界
对存储厂商这却不是简单的坏消息。TrendForce指出,8层配置用更少DRAM芯片,能以相同的HBM位输出支撑更多GPU:单卡HBM含量降了,但12层的良率和散热瓶颈一旦解除,GPU出货量抬升,HBM总堆栈数和总比特需求反而可能扩张(Citrini分析师也是这个逻辑)。代价是单堆价值量下降,需要用出货量对冲。有意思的是每比特定价:8层堆栈每颗都要配一颗基础逻辑芯片,成本摊到更少的DRAM层上,TrendForce在不同场合给出的8层对12层溢价口径从5%-10%到10%-20%不等——连卖方口径都没完全对齐,说明这轮定价博弈还在早期。竞争重心已经从"谁堆得更高"挪到"谁能以稳定良率、更快认证节奏大规模交付"。
三、涨价周期没被推翻,反而被换了燃料
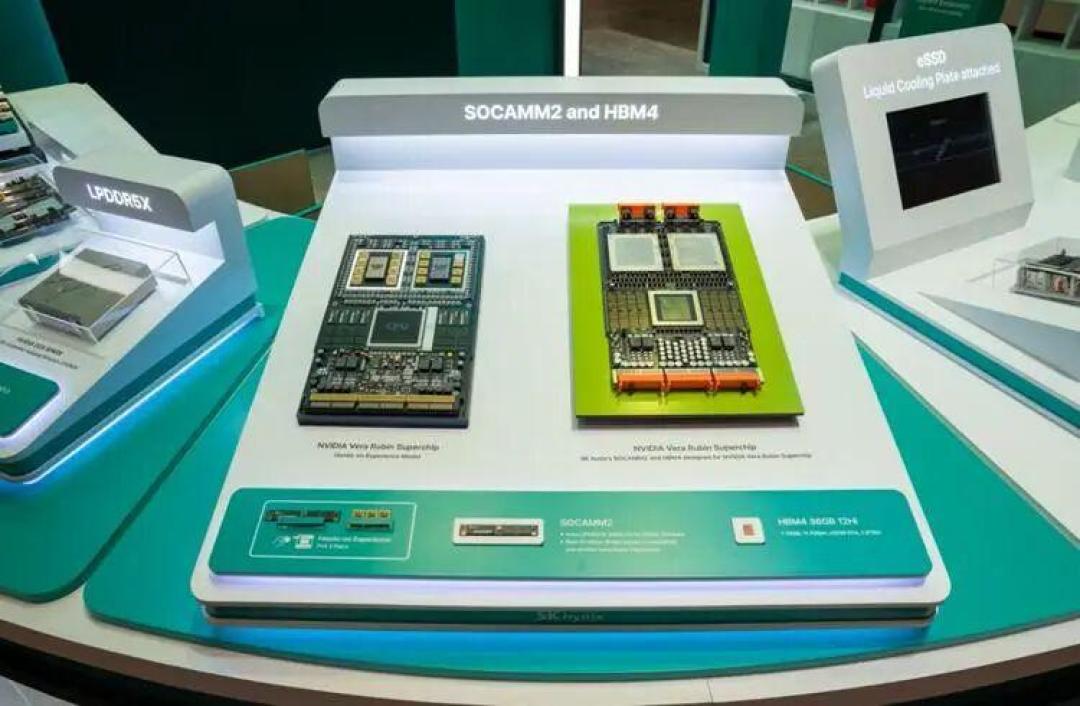
把时间拉回2026年Q4,供需格局对卖方倾斜得更厉害。高盛10月27日TrendForce专家会的信息密度很高:DRAM供给整个2027年维持紧张,涨价周期有望延续到2028年上半年;HBM混合均价2027年同比预计上涨122%,行业收入将增长逾230%、突破2000亿美元。 HBM4高端定价可能超过每Gb 5美元,扩产的约束很物理——洁净室不足、设备交期过长,每家韩国厂商2027年大约只能新增8万至10万片/月晶圆产能,新厂实质贡献要到2028年。三星、SK海力士、美光2027年HBM产能计划分别同比增长50%、67%、52%,增量里相当部分将流向8层产品。长协(LTA)覆盖率已到60%-70%,Google的TPU还在跨代拉动HBM3E需求,HBM4预计占2027年行业收入近60%。三星则对外表示2027年HBM产能已售罄。华尔街见闻知乎
对国产链,眼下的定位要冷静:TrendForce判断中国HBM供应商2027年合计份额不足2%,与头部在良率上差距明显。 黄仁勋虽表态对采购长鑫存储内存持开放态度。 但真正可能提前改变棋盘的变量不在HBM堆叠本身,而在DRAM底层器件——长鑫那条4F2路线之争,第四节展开。华尔街见闻知乎
四、下一代战场不堆层数,堆"位置"和"散热"
既然垂直堆叠的良率天花板肉眼可见,五家玩家各自把牌押在了不同位置:
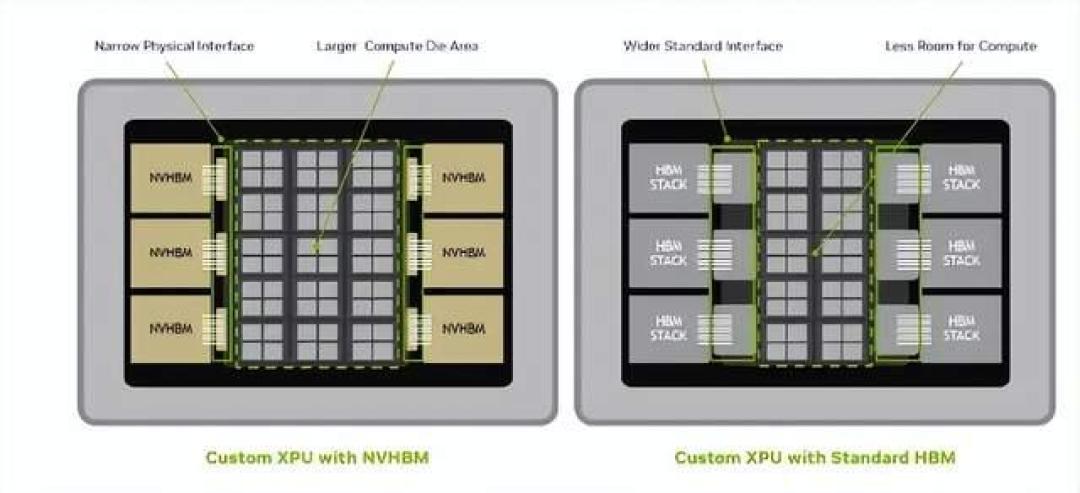
NVHBM(英伟达):今年8月发布白皮书,把内存控制器从GPU搬进HBM堆栈底部的基础裸片,基础裸片交给台积电3nm代工。 官方指标:带宽最高+30%(理论约5.2TB/s)、功耗最高-15%、XPU可用面积最多释放25%。AWS的Annapurna Labs是最早客户之一。私有接口,只适配英伟达体系。全球半导体观察
iHBM(SK海力士):承认散热先于一切,在D2D PHY发热核心区嵌入一体化冷却元件,热阻降30%以上,沿用已量产的MR-MUF工艺、客户导入门槛低,计划从HBM5起应用。知乎
vHBM + 3D DRAM(美光):10月21日研讨会同时押两线——把HBM垂直叠到GPU正上方,以及在晶圆上"种"多层存储阵列的真3D DRAM,美光选择继续迭代6F2平面DRAM,同时把长期密度跃迁的重心放在3D DRAM上。
zHBM(三星):FMS 2026上展示概念模型,目标是性能约HBM5的8倍、密度超10倍、能效3倍、热阻砍半——但仅完成概念验证,未送工程样品,热串扰是公认瓶颈。
4F2 vs 6F2(长鑫 vs SK海力士路线分歧):长鑫冲垂直环绕栅新结构,10月10日上海第四届集成芯片和芯粒大会上,长鑫总裁曹堪宇披露自研VSG垂直环绕栅的4F2 DRAM方案,计划2026年底推出基于这套架构的DDR5 RDIMM产品,专利族超300件。 SK海力士则强调"技术开发时间表和商业化落地时间表要分开看"。
还有一条被拒的询价暴露了底线:OpenAI和Anthropic曾向存储厂商问价4层产品,遭到拒绝——8层已是当前制造经济性的实际底线,HBM4代际内继续降层空间很小。 真正的再跃升要等HBM5和混合键合成熟(SK海力士已把混合键合大规模导入推迟到HBM5),届时"堆叠层数"这个维度本身可能被重新定义。电子产品世界
五、三类读者各拿一张地图
半导体行情跟踪者:别把"降层"读成"存储见顶"。这轮涨价由供给约束+定价权推动,8层方案解决的是GPU交付瓶颈,量价关系是"单堆ASP降、总需求可能升",继续观察2027年HBM4E的实际成交价和韩厂新增产能爬坡。
IC学生和工程师:技术树的考纲变了。垂直堆叠、混合键合、先进散热(D2D PHY区域热阻)和基础裸片定制,会替代"制程数字游戏"成为下一轮人才和专利的密度区;数字/模拟之外的封装与器件方向权重在上升。
泛科技读者:以后看到"内存从12层改8层",先问带宽成本和出货量,再下"降级"结论。
观察清单(接下来看什么)
三星、SK海力士8层HBM4对英伟达的单独认证进度——认证节奏直接决定2027年交付曲线;
Rubin Ultra在NVL机架里8层HBM4/8层HBM4E的实际配比,以及2027年下半年拉货强度;
长鑫2026年底VSG 4F2 DDR5 RDIMM是否如期交付;
TrendForce口径的5%-10%与电子产品世界引述的10%-20%每比特溢价之争,哪个被成交价验证;
HBM5代混合键合与iHBM/vHBM/zHBM中至少一条路线在2027-2028年的工程样品进展。
HBM的故事讲到这里换了一章:比的不再是谁能把塔堆得更高,而是谁能用更低的价格成本、更高的交付确定性,把带宽送到每个机架。对做产业、做投资、做技术的三类人来说,计分板换了,旧地图确实该更新了。