上周末小红书有个帖子火了。作者让 Claude 和 Codex 互相 review 了 30 个 PR,结果俩 AI 你夸我、我夸你,全票通过。合完代码他自己一测,好家伙:AI 擅自加的校验多得跟过海关一样,而他真正要的功能,一个都没有。小红书
这帖子两天攒了一千多收藏,评论区一片"感同身受"。有人说自己的冗余代码"大部分来源于 agent 对其他 agent 的 review 结果会无脑接收";有人晒出流程——先建 PR、本地拷问改动范围、再扔给 Gemini 和 Codex 轮番审;还有条高赞吐槽说得特别扎心,说这一套流程走下来还不如自己写。这些吐槽指向的其实是同一个问题:AI 给出的"意见",到底靠不靠得住。小红书
如果你最近也在让 AI 写大部分代码,这个场景大概率不陌生:AI 说"写好了",你敢不敢直接信?让另一个 AI 把关?它俩很可能只是在商业互吹。
而就在差不多同一周,Anthropic 给"AI 验收 AI"这道题交了另一份答卷,硬度完全不在一个量级。
1.8亿行数学证明,把测试漏掉的bug逼出来
10月22日,Anthropic 的前沿红队(Frontier Red Team)联合形式化验证公司 Theorem Labs 发布报告:几周时间里,Claude 完成了 123 个开源代码库、239 个测试入口的形式化验证,累计写下 1.8 亿行通过机器核验的 Rocq 数学证明代码。谷歌模糊测试平台跑了上万亿次都没撞出来的隐秘漏洞、潜伏十几年的高危逻辑死角,甚至 x86 处理器硬件本身的真实缺陷,都被这套"数学级点名"逼了出来。知乎
先说人话版原理。模糊测试(比如谷歌 2016 年上线的 OSS-Fuzz)是往程序里成批灌半随机输入,看哪个能把程序搞崩,它是过去十年开源世界的主力防线,但本质是在迷宫里碰运气——输入通常被限制在 1MB 以内,只要还有一条路没走过,藏在那里的 bug 就能一直活。
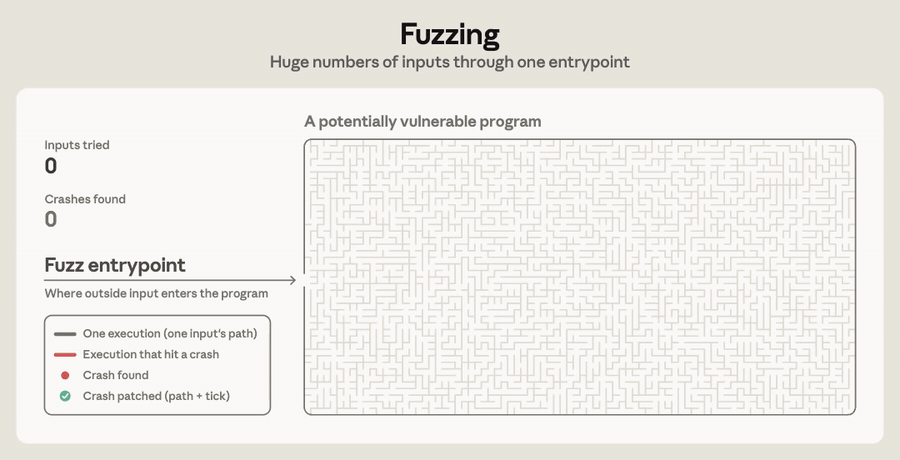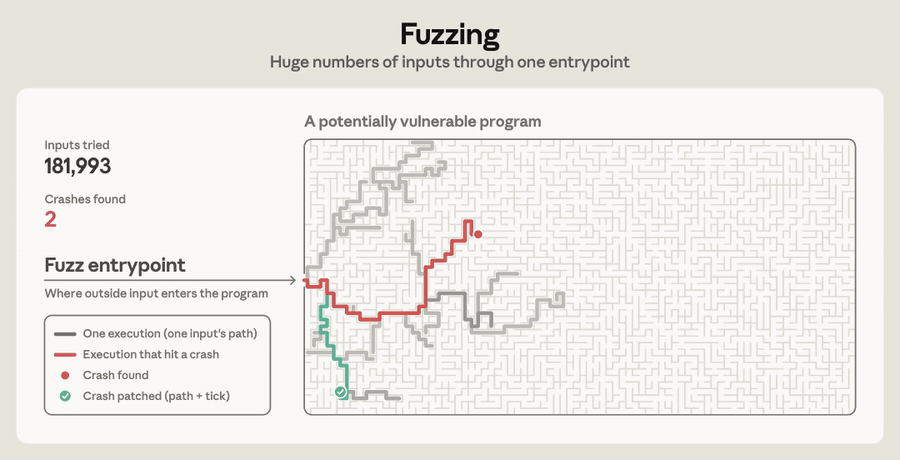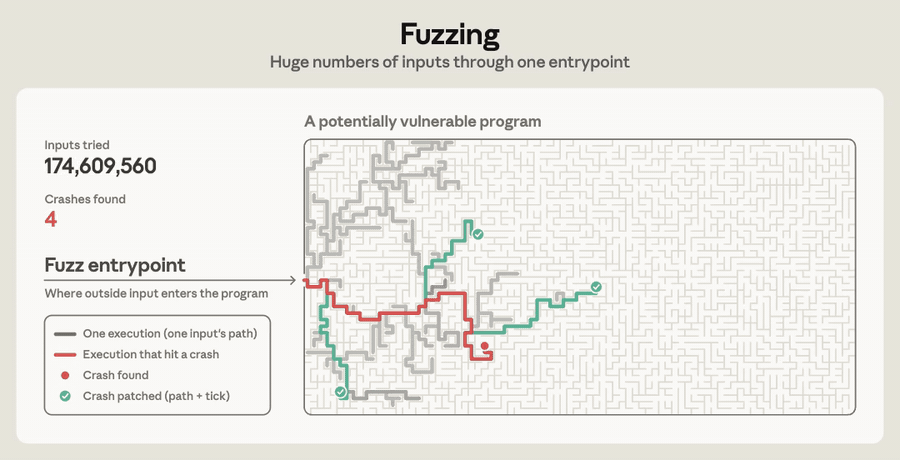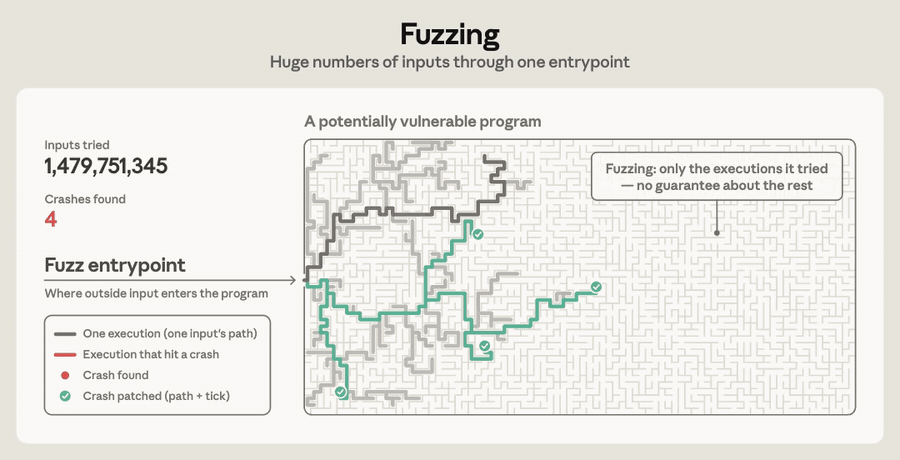
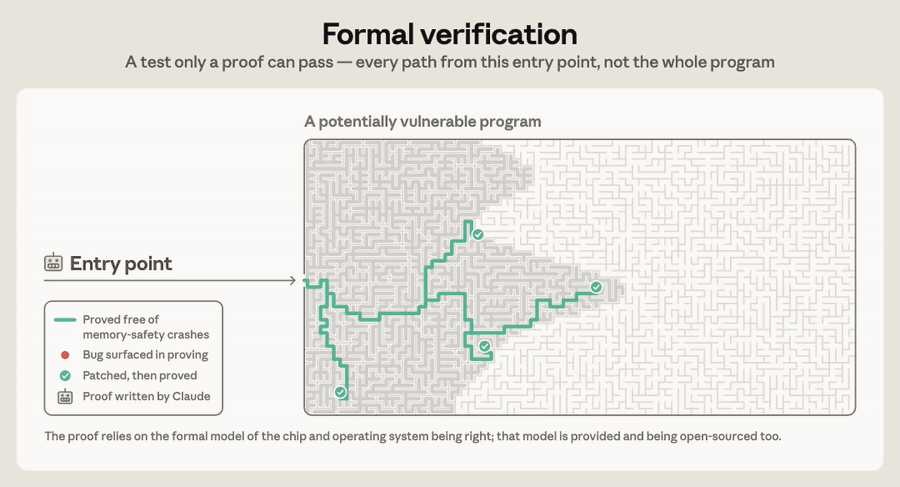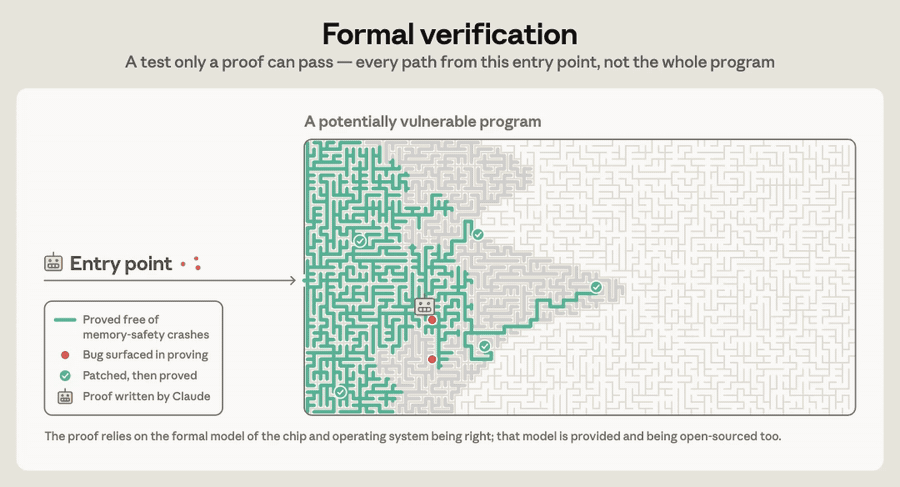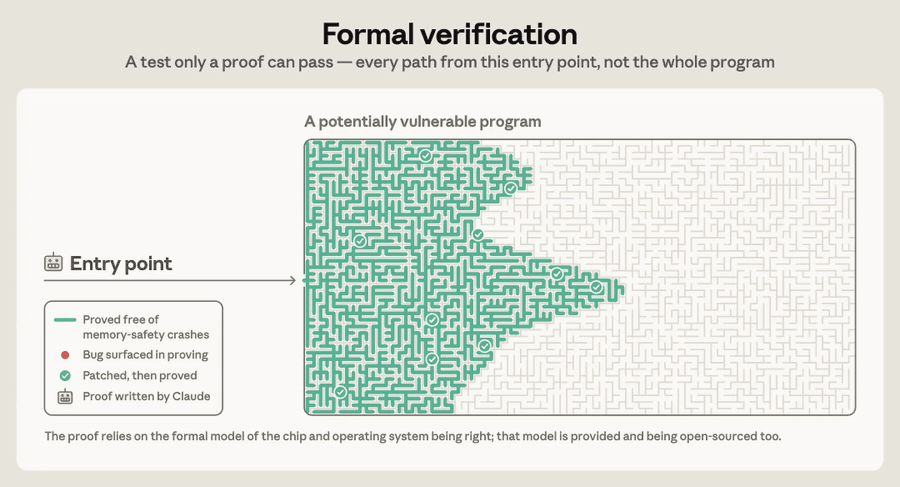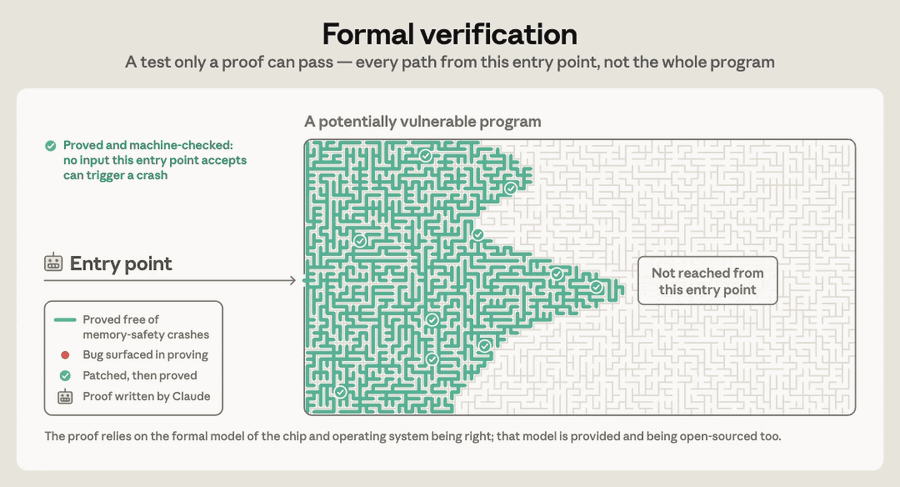
形式化验证则是把"这个程序对任意小于 64MB 的输入都不会触发内存错误"写成一道数学命题,然后证明它对每一种输入、每一条路径都成立。不是抽查,是不留死角。
报告里有个特别有说服力的对照实验:研究人员在 Claude 用 Rust 写的 Python 解释器里故意埋了 7 个 bug,随机测试放跑了其中 5 个,数学证明一个都没放过。再举个实战例子。某个解压器里藏着一处计数器下溢,会把数据写到内存边界之外,但只有喂进约 20MB、排布又很罕见的输入才会触发——模糊测试的输入上限通常才 1MB,这 bug 对测试几乎免疫。而 Claude 在尝试证明"任何输入都不会出错"的过程中,把它揪了出来。报告称,光是尝试证明的过程就发现了数百个 bug,Claude 找到自己打补丁,然后接着往下证。在一个热门 PDF 阅读器上,Claude 一周挖出的安全漏洞,顶得上它平时一整年的报告量。知乎
391行代码,63万行证明
如果你觉得"AI 找 bug"不稀奇,报告里几个反常识细节值得多看两眼:
证明的膨胀率吓人。 JSON 解析库 cJSON 的一个解析入口只有 391 行 C 代码,Claude 给它写了 63 万行 Rocq 证明,膨胀上千倍。因为要证的不是"这 391 行",而是整个运行进程:C 程序启动、内存分配器、printf、连内存检测工具自己的运行时,全都要一并证明,和 cJSON 本身有关的只占十分之一。整个项目 Claude 累计写了约 10 亿行证明,最后约 1.8 亿行通过检查。其中超一半,还是 Claude 给自己写的工具自动生成的。知乎
证明做到了机器码层。 Claude 证的是编译之后真正在 CPU 上跑的 RISC-V 指令——源代码和编译产物未必完全一致,证到机器指令,证的才是实际跑起来的那个程序。为了排除 cpp-httplib 递归太深撑爆栈的可能,它一路追进 C++ 标准库的红黑树,在机器码上证明这棵树的高度始终被压在对数级别。
最离谱的是 x86 那段。 Claude 完全自主写了一套 x86 指令集的数学模型,准到什么程度?在模型里一条指令一条指令地单步推演,能在 Linux 内核上把 Ubuntu 的用户态完整启动起来。写模型的过程中,它还找出了 x86 官方参考文档里的数百处错误,以及少量藏在 CPU 硬件本身的 bug。软件证到芯片,属于是顺手把地基也敲了敲。
为什么说这次不一样:形式化验证的"价格雪崩"
形式化验证不是新东西,新的是"快用得起"。传奇微内核 seL4,写代码只花了 2 人年,做完形式化验证却花了整整 20 人年。所以几十年来,这种级别的安全保证只有空客飞控这类人命关天的代码才配拥有。知乎
这次报告里,成本曲线出现了几个值得记下来的数字:
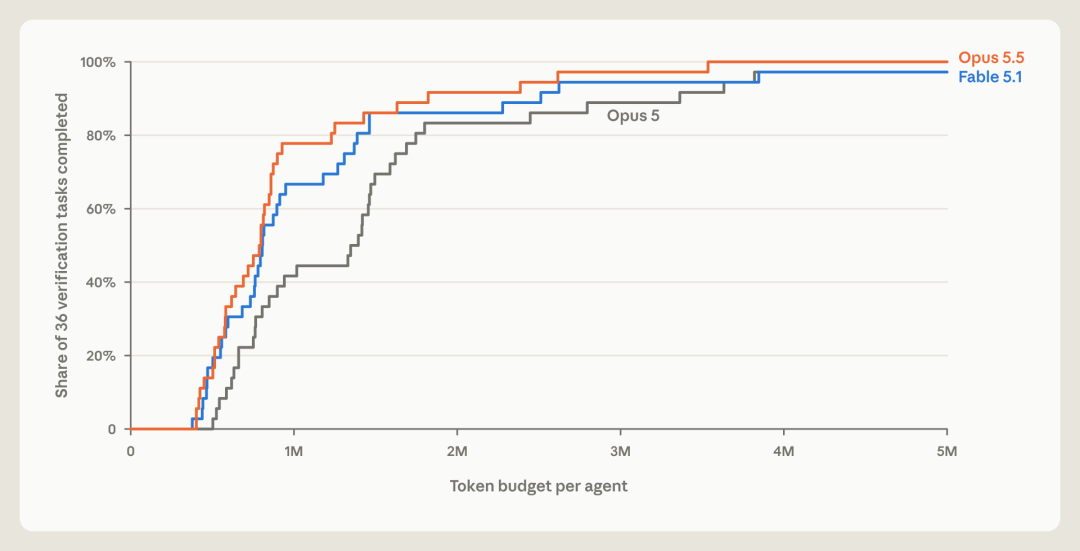
Theorem 测了今年 5 月到 9 月发布的 7 款前沿模型,验证速度大约每两个月翻一番;
一份证明往往要烧数亿 token,但在 36 个小型验证任务上,Opus 5.5 完成其中一半所需的 token 比 Opus 5 少了约 40%;
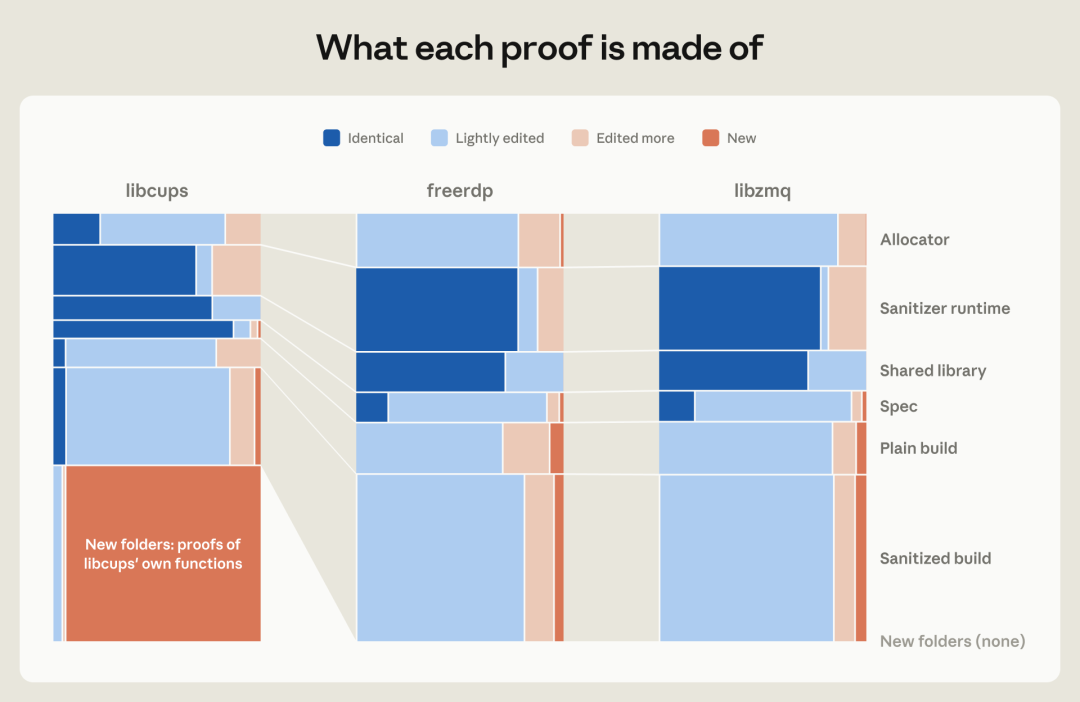
多个 Agent 共享工作区后,同一组任务少花 17% 的 token;证明还能"抄作业"——libcups、freerdp、libzmq 这几个不相干的项目共用底层运行库,大段证明直接从别人证好的部分改一改复用。
顺着复用逻辑,Theorem 用 Nix 软件生态算了笔总账:光是 OpenSSL 一个库,就出现在近 1.6 万个软件包的运行依赖里。按今天的价格把 OpenSSL 证穿一次约 22 万美元,摊到每个下游软件包只要 14 美元左右。如果验证能力保持两个月翻倍、按每年 1 亿美元预算推进,到 2027 年底总成本约 1.34 亿美元,就有望把 Nix 生态 95% 的机器码纳入数学证明。对照组是 GovAI 的估计:全球网络犯罪的损失、应对和防御支出,每年合计约 5000 亿美元。知乎
论文作者之一 Aengus Lynch 的说法是:"对互联网来说,这是一段可怕的日子。但我相信,这是一束希望之光。"背景是这段时间被媒体称为"最暗十月"的密集攻击潮:就在报告发布前一天,一个 PHP 漏洞刚让欧洲部分政务服务暂停、日本 pixiv 和 Niconico 紧急维护;9 月的一份 Debian 内核安全公告里,列出的漏洞有 1000 多个。找 bug 的 AI 越来越强,靠人一个个打补丁已经追不上了。网易
先别转发"软件永不宕机":这份报告的边界在哪
看到这儿,想转发配文"bug 要灭绝了"的朋友先缓一缓。这件事最有价值的部分恰恰是它的边界,而且不少是技术文档自己写明白的:
第一,公开的不等于全部。GitHub 上首批公开的只有 25 个库、60 个入口的证明,是 123 库、239 入口的子集。好消息是任何人都能下载下来亲手验算,但不能把研究总数当成公众已经拿到的材料。知乎
第二,证明的是"不出指定错误",不是"程序一定对"。公开文档明确写着:这批证明没有证明终止性,不排除程序一直运行不结束。“不触发指定错误”“一定会结束”“结果符合需求"是三层完全不同的保证,新闻标题最爱把它们揉成一句"软件不会出问题”。
第三,适用范围有硬边界:单线程、静态链接、固定内存预算、输入小于 64MB。对 Linux 进程行为的形式模型(LPS),作者自己标注仍不完整——某个版本模型里的结论,不能自动搬到另一种运行环境。
第四,证明指向的是哈希指定的二进制字节,不对二进制与源代码之间的对应关系作保证。检查器确认的是证明符合规范,而规范本身是否符合真实需求,仍然要人来审。GitHub
第五,这份成果尚未经过同行评审,也没有多次独立复现。连"机器检查过"都有细节:更强的 rocqchk 复核被列为可选步骤,默认 CI 并不执行。
一句话总结:AI 正在把"构造软件证明"变成一个值得系统研究的工作流程,但公开样本还不足以替整个软件生态作安全保证。Anthropic官网
回到你我:AI写的代码,今天到底怎么验收
把小红书那个帖子和 Anthropic 这份报告摆在一起,结论其实挺有意思。
Anthropic 这套流程的核心启发,用技术文档的话说叫"把生成与验收分开"——如果模型可以同时修改题目、答案和评分方式,那么通过检查就未必意味着解决了原问题。所以他们的流程用 SHA-256 哈希钉死被证明的二进制、逐条审查证明用到的额外假设、拒绝允许列表之外的一切假设。知乎
而"AI 审 AI 全票通过"的翻车,病根正在反面:LLM 互相给出的是意见,意见自带讨好基因,模型被训练得倾向顺从和赞美,互审很容易变成互按摩。验收靠的从来不该是意见,而是可判定的检查——断言、测试、类型系统、检查器。哪怕只是一个小实验也能说明问题:随机测试漏掉 5/7 的 bug,数学证明 7/7 全中。
顺便说,别以为 Anthropic 自己不敢让 AI 审 AI。据知乎上援引 Anthropic 安全博客的回答,Anthropic 内部约 80% 的代码由 Claude 撰写、过半通过内部工具自动合并,Claude Code 自己仓库的比例更是约 90%。规模化"AI 审 AI"是可行的——但支撑它的是流程和可判定的闸门,不是两个模型互相说一句 LGTM。知乎
所以,普通开发者今天就能抄的作业,社区里已经有人在实践:
拷问式 review,而不是点头式 review。 那位小红书作者后来改成了"PR 灵魂拷问法":针对改动连续追问,问到 AI 只剩一句 “You’re absolutely right” 为止,把顺从性同意全部挤出去。小红书
让 AI 对照规范审,而不是凭感觉审。 先把需求和边界写成明确文档(JIRA 单、design doc 都行),review 时只对照文档核对,并强制要求"最小改动"。评论区有个做法值得参考:planning 会花半天把需求掰清楚,之后 review 甚至可以不用人,因为有非常清晰的对照物。
多模型轮审 + 明确通过规则。 比如:本地先拷问改动范围和是否最简实现,再交给另外两家的模型轮番审,多轮无实质建议才 approve,重要改动保留人工签字。
能用机器判定的,绝不用意见判定。 类型、断言、单测、property-based testing——这些就是今天人人用得起的"小型形式化验证",也是那条 1.8 亿行证明路线的平民版平替。
至于这条路线本身,值不值得持续押注,我建议盯三个信号:GitHub 公开的证明能否被第三方稳定复验;代码更新后证明的维护成本有多高——证明"过期"的速度会不会追上代码迭代的速度;以及 Theorem 那笔 1.34 亿美元的路线图,接下来有没有真金白银进场。
三年前,没人相信 AI 能写代码;今天,没人拦得住 AI 写代码。下一个问题已经摆上桌面:机器能不能证明 AI 写的代码是对的。眼下答案还是"在严格条件下,部分能",但那条"每两个月翻一番"的速度曲线,就挂在那里。
你让 AI 写代码之后,都怎么验收?评论区聊聊你的流程。