把 KV Cache 从显存挪到 SSD,容量问题看起来解决了,延迟问题才刚开始。能挂起的会话多了,长文档问答也不用因为显存不足提前退出。
可上线后,投诉常从另一头来——会话恢复要等,负载一高,前端就像打字机卡住。
问题通常不在 SSD 不够快。一份正在 Decode 的 KV 被换到远端,每生成一个 Token 都可能要等一次存储往返;GPU 不是慢一点,而是把存储队列搬进了生成路径。
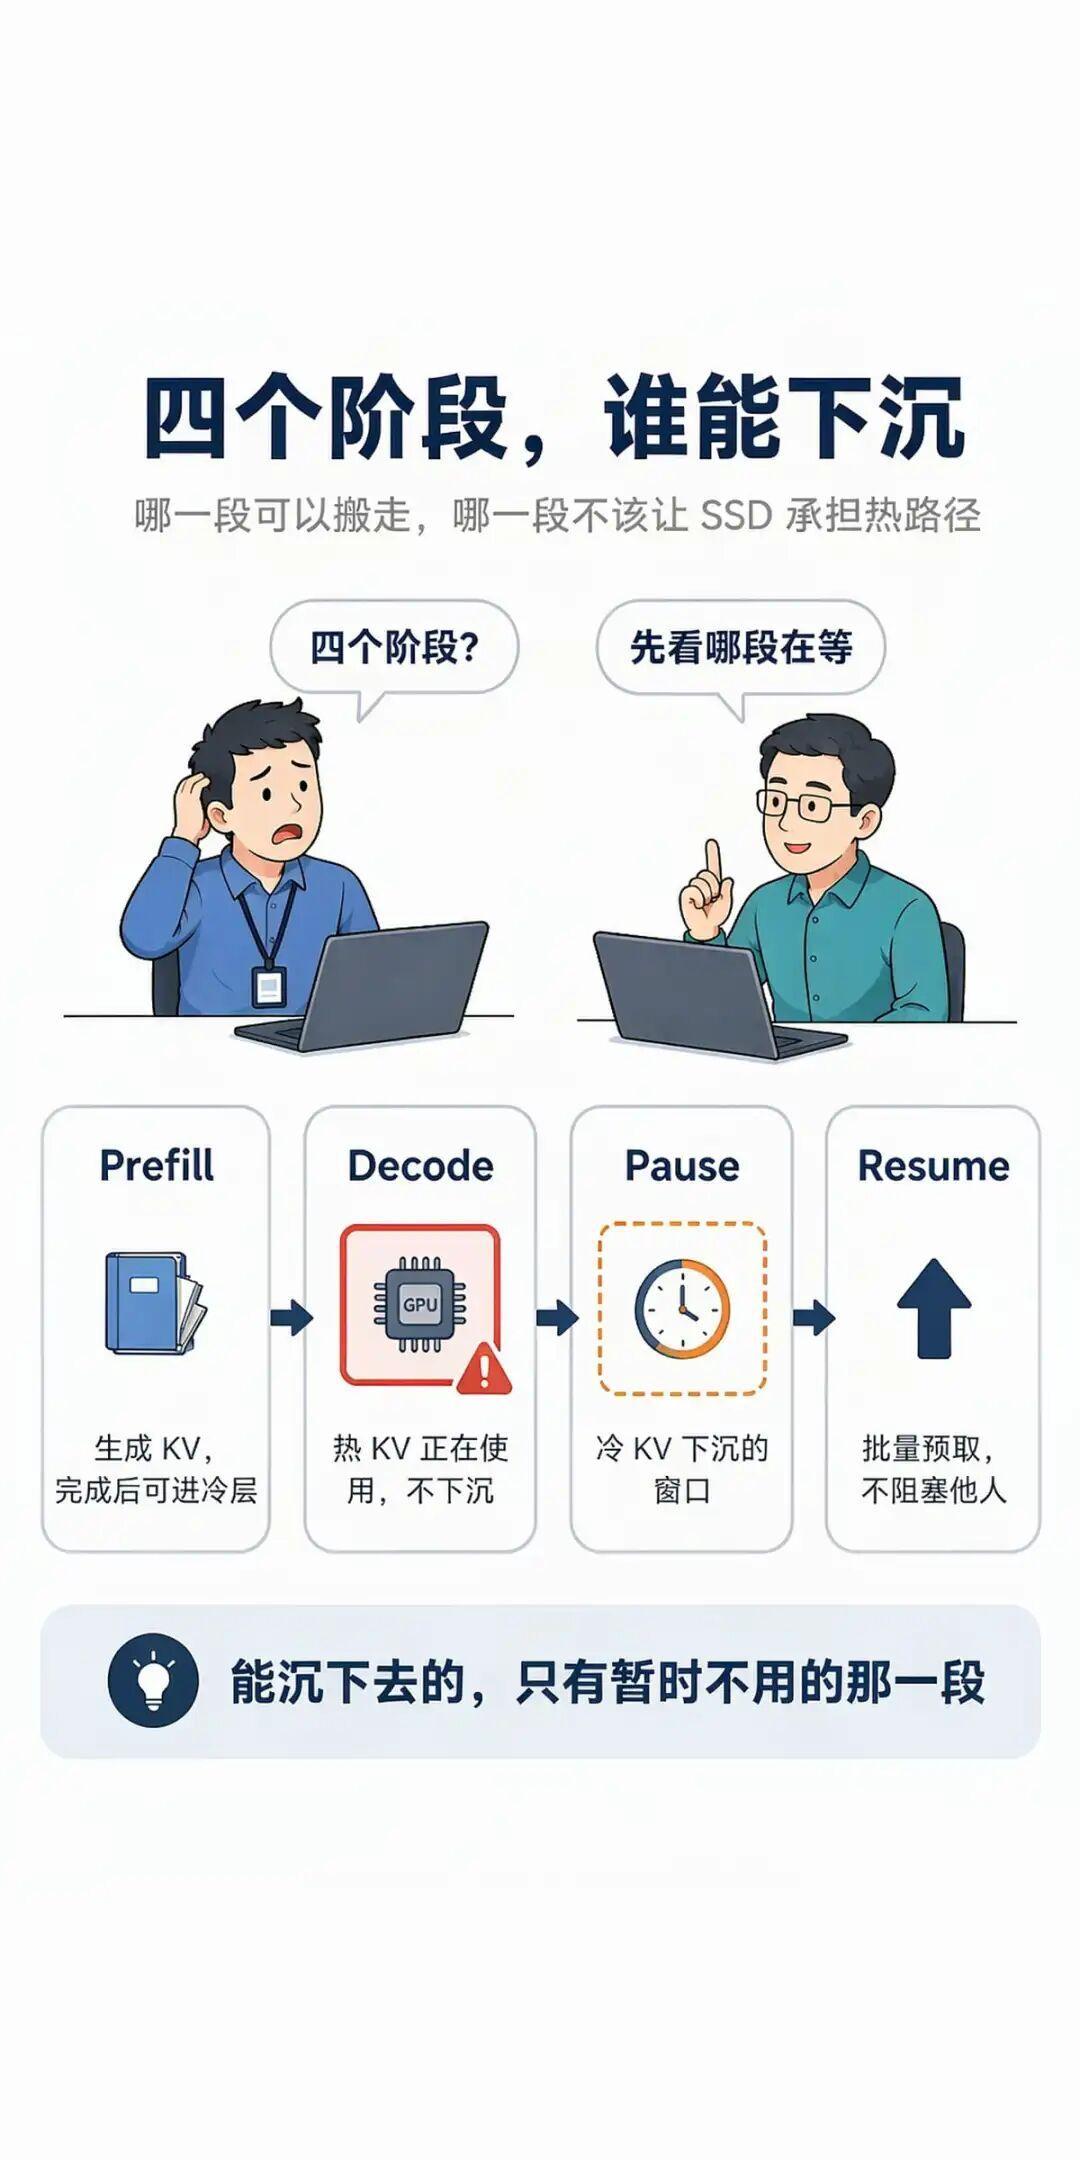
所以判断标准只有一条:换入的时间,能不能小于重算的时间,并且不打坏其他请求的尾延迟。能,才叫分层;不能,只是换了个地方排队。知乎
先算体积。按 32 层、8 个 KV 头、每头维度 128、FP16、3.2 万 Token 的上下文估算,单个序列的 KV 有效载荷约 4 GiB。
再算时间:首 Token 预算 2 秒,扣掉排队、调度和 Prefill,真正留给搬运的可能只有 200 毫秒。
4 GiB 摊到 200 毫秒,需要约 20 GiB/s 的“每请求有效带宽”。
这是单个恢复请求的下限,还要在 P99 上成立,扣掉队列、小块读放大、网络往返和多租户争抢。这也解释了为什么同一套方案,有人说很值,有人说完全没用。知乎
他们很可能是在不同代际的机器上做判断:一边是算力涨得快、重算越来越便宜,一边是 PCIe、RDMA、全闪这一侧改善得慢。
两边一比,offload 的收益就不是一个固定数。
SSD 在推理栈里其实只做三件事。第一类是冷数据层,承接“写完要隔一阵才读”的挂起会话;如果只挂几秒,主机内存往往更合适,路径更短。
第二类是共享层,把一段系统提示词的 KV 复用到多个节点、多个请求;真正的门槛不在性能,而在多租户能不能共享、模型版本和 tokenizer 是否严格一致、内容更新后旧 KV 怎么失效。
第三类是恢复层,进程重启、节点迁移、版本切换后不必从头再算,验收指标是恢复时间,不是带宽。
三类用途混在一起谈,就会得出“SSD 有时行有时不行”这种没有信息量的结论。
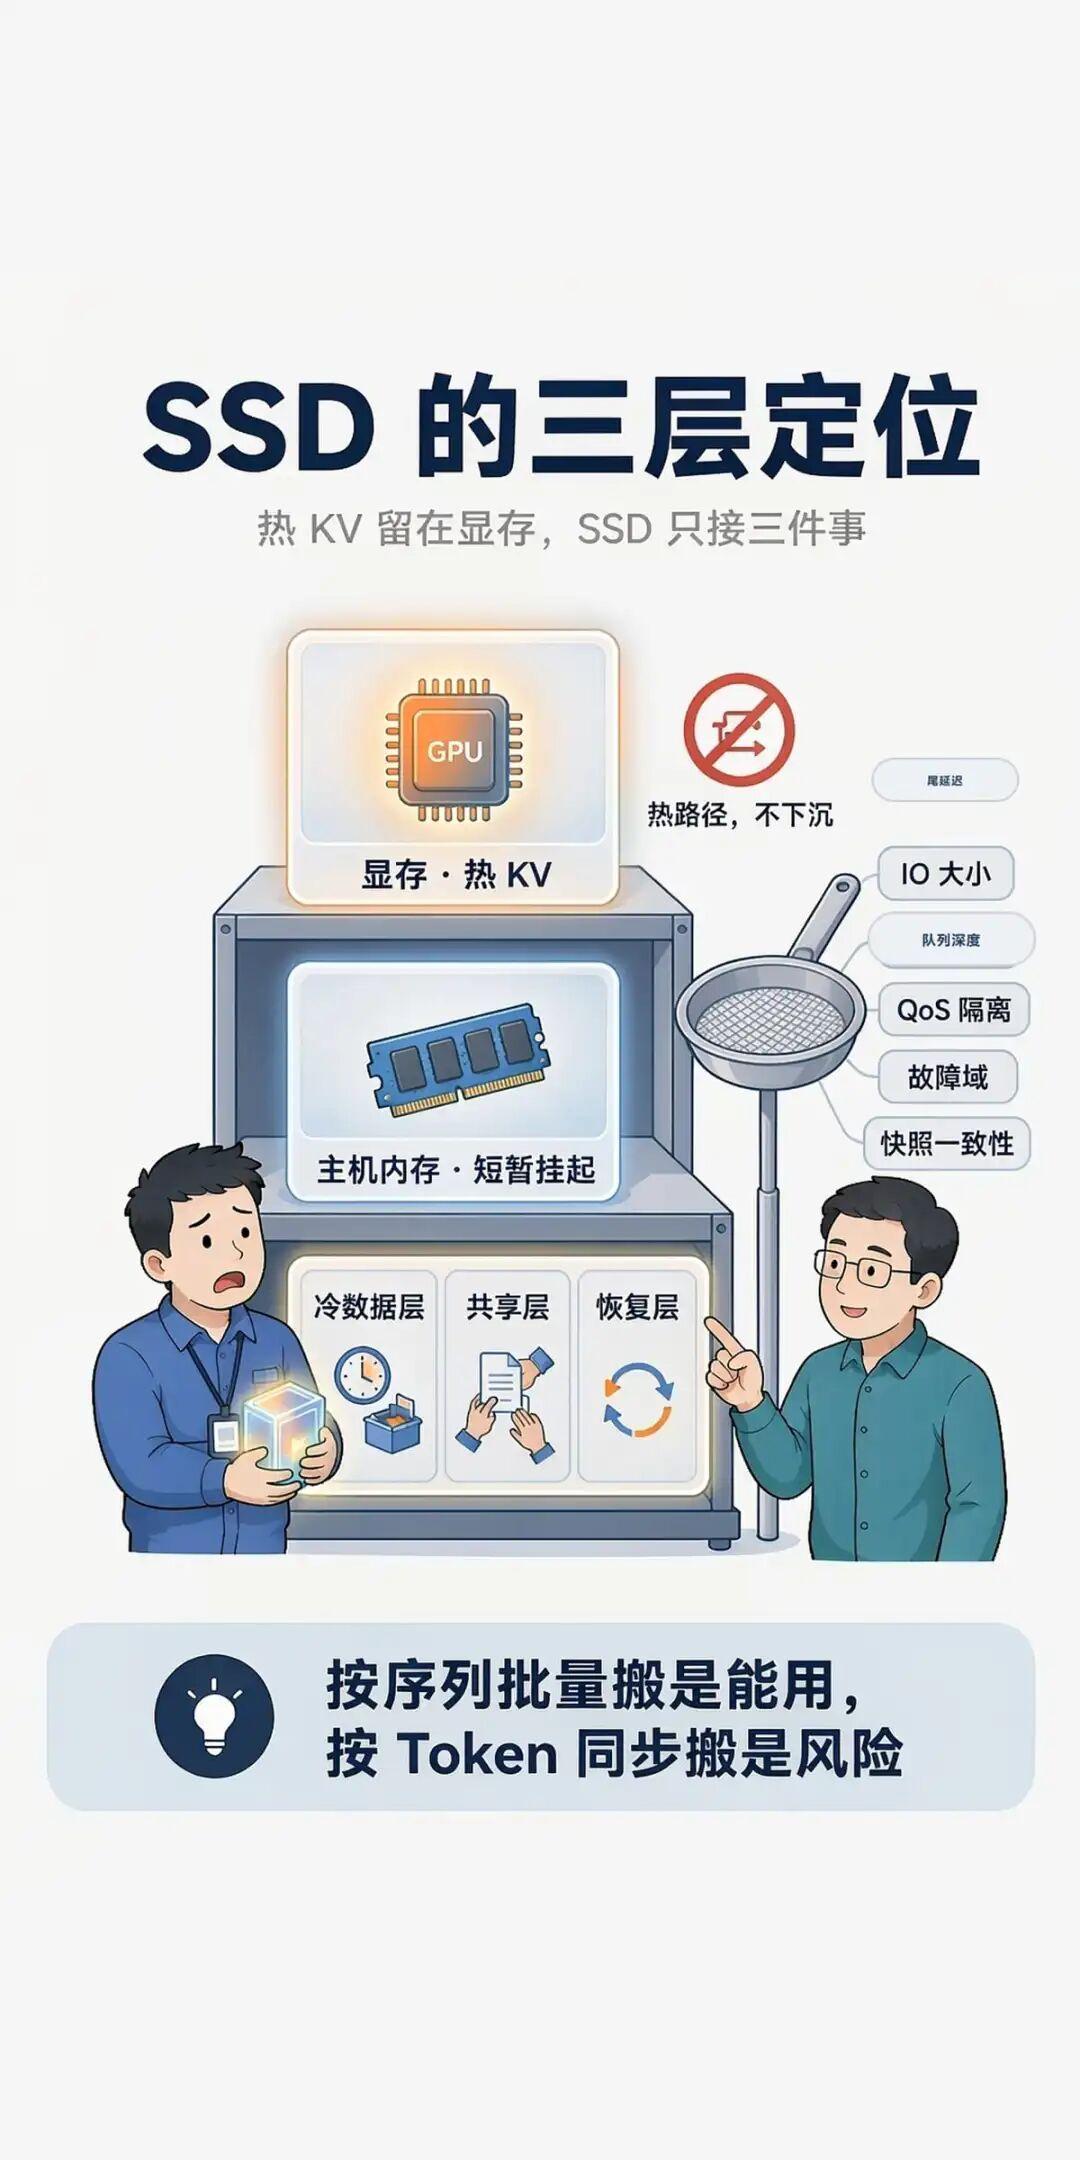
落到工程上,先看一条筛子:按序列批量搬,是“能用”的前提;按 Token 同步小块搬,是强烈的风险信号。前者更接近批量 IO,后者容易把 GPU 的每一步都挂到存储队列上。
再往下看六件事:IO 大小、队列深度、尾延迟、QoS 隔离、故障域、快照与一致性。
多租户共用一个池,一个租户的恢复风暴会不会打穿别人的 SLA;节点故障后,KV 是重算、降级,还是直接报错。这些都比“盘有多快”更接近真实答案。
这也是本地盘和远端存储的分水岭。本地 NVMe 路径短,但容量和故障域绑在单机上;一旦跨节点共享,RDMA、NVMe-oF、拥塞控制和 QoS 都会进入同一条不等式。
网络省下的不是一次搬运,而是决定这份 KV 到底能不能被当成“可换入”的数据。
存储侧的软件栈也在跟着改。GDS 原本让 GPU 直接读写 NVMe,但 KB 级细粒度 IO 要经过文件系统和内核上下文切换,带宽低、延迟大。
uGDS 把 IO 发起搬到用户态,绕开主机内存,batch 请求一次提交、乱序完成。
它的下一步,正是条带化 SSD 和 NVMe-oF 这类远端分布式存储;实测 KV 缓存吞吐最高到 GDS 的 2.63 倍,端到端 TTFT 缩到原来的 37.3%。知乎
这也是“存储网络”在这轮变化里最容易被忽略的地方。过去它负责把冷数据从仓库搬到计算节点,带宽和容量是主指标;现在 KV Cache 直接挂在推理主路径上。
网络要回答的是另一个问题:这份 KV 能不能在 SLA 允许的时间内,按正确的粒度、以可接受的尾延迟搬回来。
远端方案让会话数变多,但首 Token 和尾延迟超出业务目标,它就是失败的方案。容量不是目的,能履约才是。知乎