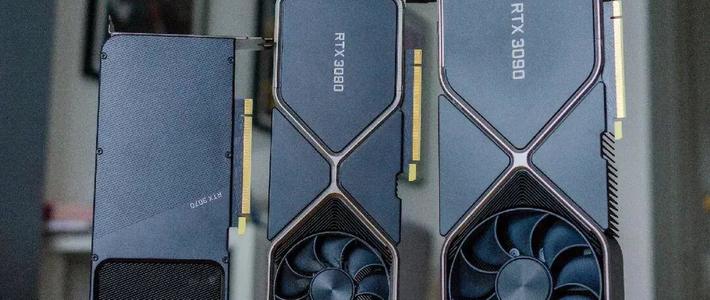
这两天本地AI圈的群聊又被一张GitHub表格刷屏了。10月18日上线的开源内核模块 gpu-unlock,宣称把 NVIDIA 30系显卡的 FP/BF16 指令发射速率解锁到"专业卡水平"。一周时间,仓库star干到近3000,B站相关视频8小时播放破8000、收藏数(368)反超点赞数(220),知乎凌晨还挂出了新提问。标题清一色"30系春天"“算力翻倍”,仿佛手里的老卡白捡一截性能。GitHub知乎
但把README、issue报告和社区实测拼在一起看,这个补丁的真实收益比标题窄得多,坑也比标题多得多。而更现实的连锁反应已经出现在闲鱼上:有用户发帖说自己的3090从去年入手价五千左右涨到了九千上下,“丐版4080 16G已经突破首发价”,有人在评论区直接留言"帮大伙看过了,已经涨了"。要不要装、要不要趁双11收货,都得先把数字算清楚。哔哩哔哩
"翻倍"翻的是哪笔账:指令发射速率,不是你的出字速度
先说这个补丁到底动了什么。gpu-unlock 的做法是在 NVIDIA 官方驱动绑定显卡之前,由内核模块写入两个速度选择器寄存器(SS0 置 0x88888888、SS1 置 IMLA4),再做一次FLR复位,然后让原封不动的官方驱动正常绑卡。它既不是UEFI小程序,也不是魔改驱动——技术路线沿袭自当年解锁挖矿限制器(CMP)的那批工具。它解锁的是 GA102/GA103/GA104/GA106 这几颗核心上 FP/BF16 FMA 指令的发射速率,也就是矩阵乘加这类计算"喂数据"的速度。GitHub
3090 Ti 在 450W、8192³ 稠密 GEMM 下的官方口径数据(FP32累加、五次取样中位数):BF16 从 87.50 提到 157.41 TFLOPS,TF32 从 42.58 提到 82.61,FP16 从 87.46 提到 118.39——发射速率层面确实接近翻倍。知乎
问题来了:本地跑大模型的人最关心的"每秒出多少字",恰恰基本不归它管。LLM 的逐token解码阶段是显存带宽瓶颈,矩阵单元空转等数据的常态不会因为你解锁了发射速率就改变。所以社区实测给出了两种都成立、但常被混着说的口径:issue报告里 LLM 的 prefill(长文喂入)阶段提速 14%–36%,矩阵密集的扩散模型、FlashAttention 也在受益名单里;而B站那条106赞的省流评论说的是另一头——日常生成"几乎没提升"。两个口径不矛盾:翻倍的是算力上限,能摸到多少取决于你的负载是不是矩阵瓶颈。跑ComfyUI出图、喂长文档的人有肉吃;纯粹等模型一个字一个字往外蹦的人,体感变化接近没有。多位报告者还确认了一点让强迫症安心的细节:解锁前后模型输出 bit-identical,一个字都不会变笨。GitHub哔哩哔哩
分卡收益表:有人白捡七成性能,有人解锁完仍是半速
README 收录的社区兼容性报告按卡汇总,BF16 GEMM 增益大致是这样:
RTX 3060 12G(GA106):约 +80%
RTX 3070(GA104):+73%–81%
RTX 3080 10G(GA102):+70%–73%;改装20G版(PCI ID 10de:2206):+56%–59%
RTX 3090(GA102):+25%–67%,方差极大的原因在功耗——最低那档+25%出自被锁在225W的卡
RTX 3090 Ti(GA102):+68%–80%
RTX 3070 Ti:本模块未测,但同一解锁在 Windows 的 UEFI 移植版上跑通过
GA103(3060 Ti 用的核心):至今零报告
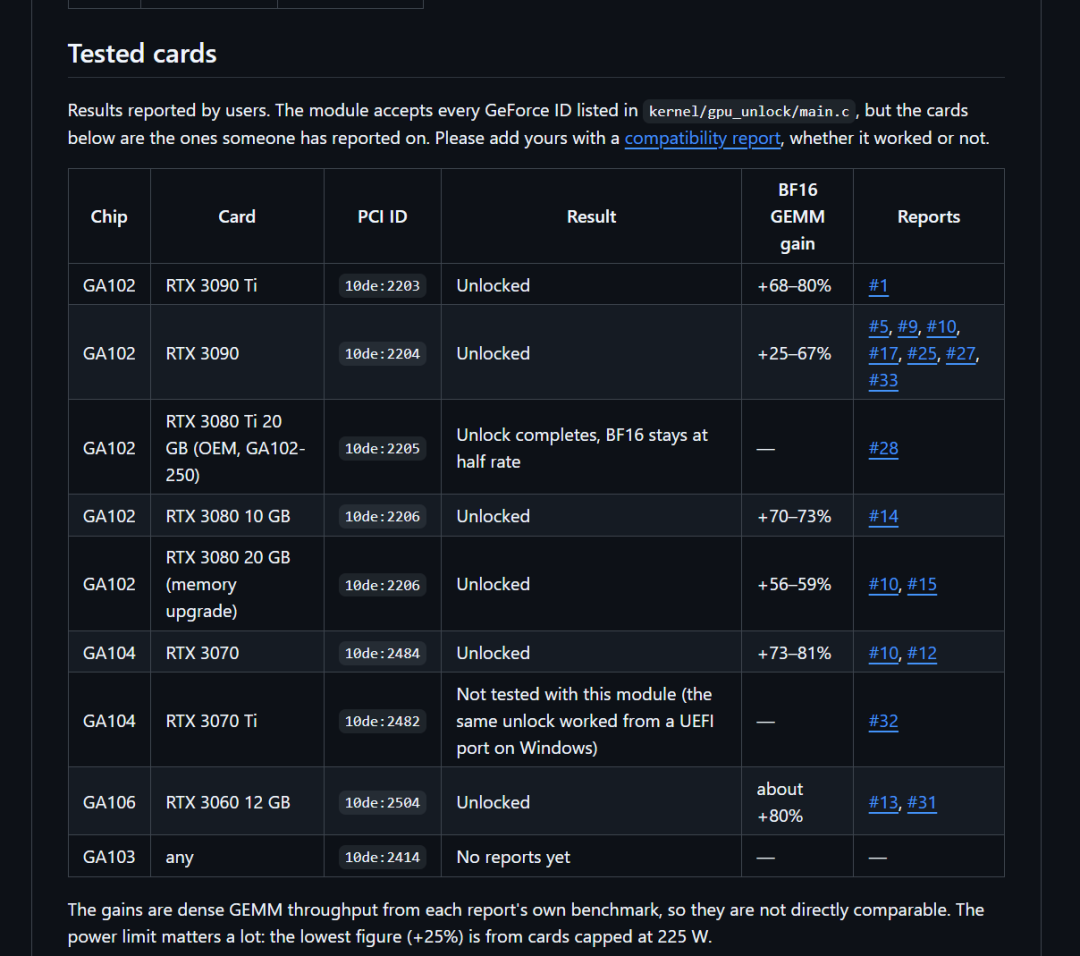
真正值得抄进购机避坑清单的是反例:一张 OEM 版 3080 Ti 20G(GA102-250,PCI ID 10de:2205)完整走完解锁流程、运行时寄存器验证也确实保持住了,BF16 依然是半速——无效。同一张纸上的型号,芯片步进不同就是两种命,这条目前只有一例报告,但它说明"30系=免费提速"这种一句话结论根本立不住:收益要以你自己的卡的具体版本实测为准,issue里那些各家自测的数字口径互不相同,横向对比只能看个大概。GitHub
装不装,是三道选择题不是性能题
第一道是系统。gpu-unlock 本体是 Linux 内核模块,装法走发行版包(Arch/Debian系/Fedora系都有installer),核心动作是往内核启动参数加 gpu_unlock.targets=all 或指定PCI地址,卸载即回退。它照顾到了不少边角场景:显示卡也能解(开机过程中会短暂黑屏一小段);支持单机最多四卡、vfio-pci直通给虚拟机;挂起唤醒后会自动重新解锁,但休眠(hibernate)不管。Windows 用户目前只有早期移植:一个 EFI 引导器项目、一个134 star的3090移植指南(还带"免复位启动"的韩国用户笔记),成熟度都远不如主线,评论区喊"等待一键工具"的大有人在——建议观望。哔哩哔哩哔哩哔哩
第二道是负载。拿它当出图卡、长文预填充卡、多卡小服务器的,值得折腾一次,毕竟解锁不收费,输出也不变。纯聊天、跑INT8量化模型为主、或者本来就不开长上下文的,这项解锁解决不了你的瓶颈,犯不着为它重装系统。
第三道才是真金白银:双11前的二手价。补丁带来的"30系免费提速"预期正在被市场消化——上文那批涨价截图全来自用户转述,不是盘价数据,但方向感已经出来了;再叠加内存涨价、显卡囤货这些老话题,"现在收3090"等于在为一个已被公开的解锁红利付溢价。真要这个窗口补卡,反而把上面的反例利用起来:避开 GA102-250 这类半速步进和来路可疑的改装/翻新版(B站评论区刚有人晒了四卡4090魔改卡开机缺3G显存的翻车现场),能实测的让卖家现场跑一遍BF16 GEMM再付钱。
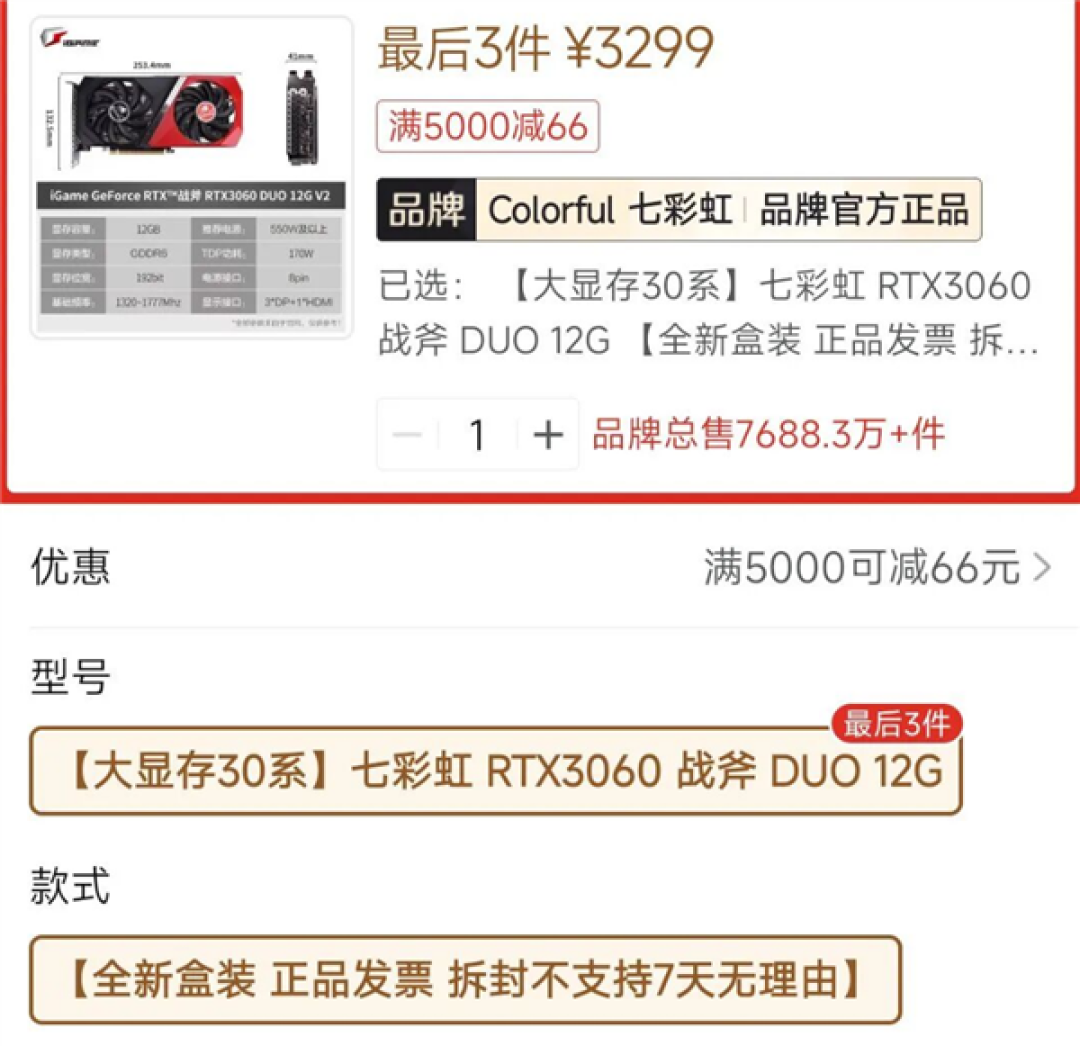
已经持卡在手的人倒是可以反过来看:这个补丁给手里的30系续了一截性价比,双11真正该捂紧钱包的是"为了解锁去买解锁过的卡"这个念头本身。
接下来盯什么
三个信号值得放进观察列表:GA103 的第一份实测报告什么时候填进表格(3060 Ti 用户占着30系保有量的大头);Strata、llama.cpp 这些本地框架跑解锁后的端到端数据会不会出现——现在所有数字都还是 GEMM 口径,离"你的日常任务快了多少"还隔一层;以及最现实的一条:NVIDIA 后续驱动会不会在初始化路径上把这套选择器写回去,毕竟它现在依赖的是"抢在官方驱动绑卡前动手"的时间差。
老卡玩家这两年见惯了"等等党胜利"的剧本,这次难得轮到软件侧直接给硬件发糖。只是糖的真实克数,得按你的系统、你的负载、你那张卡的具体步进来称——表格里 +80% 和"仍是半速"同时存在,才是这个补丁完整的样子。