214GB大模型家用能跑吗?手把手教你算清硬件账
09-01 17:08
精选参考来源


精选参考来源
1. 腾讯混元推出Hy4 preview轻量版 权重从1.5TB压缩至约214GB
网易 2026-09-01 00:00:00
2. 腾讯混元Hy4开源:770B参数49B激活1M上下文,首个递归自我改进闭环,开源三巨头一周内轮番出牌

知乎 2026-08-28 00:00:00
3. 大模型本地部署瓶颈:显存容量、显存带宽及核心影响因素完整解析

今日头条 2026-08-25 00:00:00
4. 腾讯混元Hy4 preview轻量版发布:1.5TB模型压缩至214GB,异构设备可联合推理

新浪财经 2026-09-01 00:00:00
5. 腾讯混元Hy4预览轻量版开源压缩至214GB
网易 2026-09-01 00:00:00
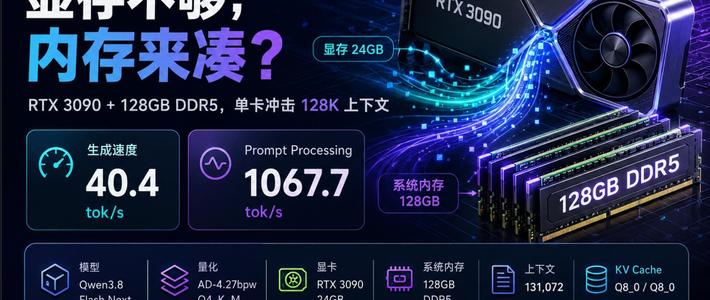
6. 24GB 显存 + 128GB 内存,塞下Qwen3.8 Flash 94GB 大模型:MoE 把消费级显卡玩出新花样
知乎 2026-08-28 00:00:00
7. 我刚在GB10上实测了Qwen3.8的27B NVFP4版,结果有点打脸自己的预期。 参数更小,速度却只有老模型的五分之一。 之前这台机器跑的是Qwen3.6 35B-A3B,MoE架构,总参数35B但每次只激活3B。实测生成速度47到64 tokens/s,日常当风控助手完全够用。 昨天换上Qwen3.8 27B稠密版,同样NVFP4量化,权重15GB上下,128GB统一内存装着毫无压力。结果一跑:短代码解释4.5 tok/s,中文写作13.2,长代码生成7.6。 第一反应是哪里配错了。查完才想明白:GB10的内存带宽就273GB/s,稠密27B每生成一个token要把15GB权重完整读一遍,理论上限也就18 tok/s。而MoE每步只读3B激活参数,带宽压力小一个量级。 教训很朴素:在带宽受限的统一内存机器上,决定速度的是激活参数量,不是总参数量。稠密"小"模型未必比MoE"大"模型快。 不过也没急着换回去。它今天的活儿是白天的情绪摘要和交易风控veto——几十秒出一个结果的场景,慢点无所谓,跑了一天没掉链子。真正吃速度的对话式任务,得重新掂量要不要把MoE请回来。 统一内存的正确打开方式:不是装最大的模型,是按任务选架构。
今日头条 2026-08-27 00:00:00
8. 新模型越多,DGX Spark 越保值? 新模型越多,DGX Spark 反而越保值?MoE 降低了部分算力压力,却把显存带宽和多机互联的重要性推得更高。Apple、AMD Halo、Xiaomi AI Cube 都在追,但 DGX Spark 的定位还没那么容易被替代。 #DGXSpark #MoE #AI硬件 #本地大模型 #个人观点

抖音 2026-08-28 00:00:00
9. 跑DGX Spark试Qwen3.6 35B,nvfp4和bf16差别挺大。nvfp4快,显存省,能多开几个并发;bf16慢点,但复杂推理稳。 不过别太纠结精度,MoE架构激活才3B,4bit量化该聪明还是聪明。省下的显存不如去跑大模型。 到底选哪个,看你拿来干嘛,写代码和聊天敏感度完全不一样。
今日头条 2026-08-26 00:00:00
10. moe‑l2 破 80 Star:小显卡跑大 MoE,感谢每一条真实反馈
知乎 2026-08-29 00:00:00
11. 腾讯混元Hy4轻量版压缩至214GB,性能惊人提升

搜狐 2026-09-01 00:00:00
12. 腾讯混元新一代旗舰 MoE 模型 Hy4 preview部署实测
今日头条 2026-08-29 00:00:00
13. 腾讯混元开源7700亿大模型Hy4:如何安装、使用、哪些人需要?
今日头条 2026-08-31 00:00:00
14. 深度协同:燧原科技全面支持腾讯混元Hy4 preview
今日头条 2026-08-28 00:00:00
15. 希奥端计算:ARM与RISC-V双路并行,瞄准AI推理服务器CPU增量市场
今日头条 2026-08-26 00:00:00
16. Qwen3.8-Flash-Nextext 大模型本地部署与费用分析
今日头条 2026-08-27 00:00:00
17. 刚刚,腾讯姚顺雨再交卷,开源Hy4 preview

微信公众号 2026-08-28 00:00:00
18. 阿里开源 Qwen3.8-27B 本地实测:性能很强,但 Agent 适配仍待补课
微信公众号 2026-08-27 00:00:00
19. 腾讯混元Hy4 preview轻量版发布:1.5TB压缩至214GB!本地轻松部署

站长之家 2026-09-01 00:00:00
20. 个人高配电脑本地跑大模型:硬件门槛、开源模型、Token 算力深度解析
CSDN博客 2026-08-28 00:00:00
21. 3步搞定!普通电脑也能跑大模型的秘密武器
GitCode 2026-04-25 00:00:00
22. 770B模型免费用两周,混元Hy4开源了
今日头条 2026-08-28 00:00:00
23. 128GB统一内存,本地部署AI大模型的“平民神器”来了
今日头条 2026-08-27 00:00:00
24. 128GB统一内存加持,本地跑大模型的平民硬件来了
今日头条 2026-08-29 00:00:00
25. 【腾讯混元Hy4 Preview技术解析】770B稀疏旗舰如何把百万上下文推进真实生产力
CSDN博客 2026-08-30 00:00:00
26. 腾讯混元推出Hy4 preview轻量版 权重从1.5TB压缩至约214GB
新浪财经 2026-09-01 00:00:00
27. 腾讯混元新一代旗舰 MoE 模型 Hy4 preview部署实测
今日头条 2026-08-29 00:00:00
28. 3 张卡到底能不能跑大模型推理?从 vLLM、llama.cpp 到 TensorSharp 的多卡真相
腾讯云 2026-08-29 00:00:00






-
 亲密炒菜中途疲软、核心不稳?七个凯格尔运动,让你找回自信108 44
-
 在闲鱼12万卖掉特斯拉!当天手牵手过户,比贱卖给车商爽多了114 134
-
 洁柔艺术油画抽纸测评|美的不像话!颜值能打,更扛得住娃!230 43


已收藏
去我的收藏夹