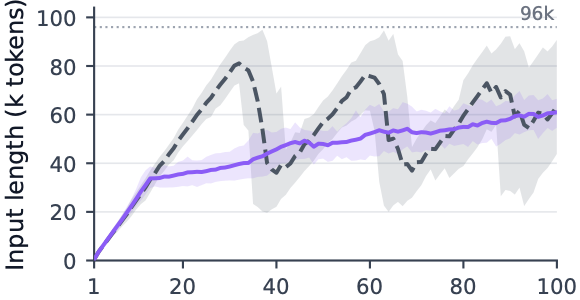
做 Agent 的人大概都见过这样一块账单面板:一个搜索型 Agent 跑到第 60 轮,输入长度爬到 90k token,「cache read」那一栏的金额一轮比一轮高,而「output」那一栏几乎没动。你以为是模型在思考,其实是系统在反复把一份越来越长的缓存从显存里搬进搬出。
这个 10 月,围绕这块面板发生了至少四件事。OpenAI 在 10 月 20 日的 API changelog 里把提示缓存的保留时长做成 12 小时选项,写入价从输入价的 1.25 倍涨到 2.5 倍。一篇叫《Cache Engineering for Agents》的论文在知乎被拆成账单讲,一份成本构成里 KV cache 读取占到了总 API 成本的 82.4%,「82.4%」这个数字开始流传。另一边,「Codex 要取消上下文压缩」的传言在社区刷了一轮,有人把相关 PR 全翻了一遍,结论是方向没错、但「即将取消」说早了——截至 2026 年 10 月这还是默认关闭的实验功能,原来的压缩代码没有被删。而 DigitalOcean 的无服务器推理提示缓存,也在 10 月底宣布正式可用。知乎知乎知乎
四件事指向同一个问题:Agent 时代计费的主体已经不是生成,而是缓存。而我们对「省钱」的直觉,还停在上一代。
反直觉之一:压缩省 token,但可能把成本压反
「上下文太长?压一压」几乎是每个做长任务 Agent 的人的第一反应。问题是,前缀缓存命中的前提是请求前缀逐 token(逐字节)一致——vLLM 的 Automatic Prefix Caching、SGLang 的 RadixAttention、Anthropic 和 OpenAI 的 prompt caching,原理全是前缀匹配,一个都躲不过。
知乎上有个被反复转的生产案例:有开发者做了双源对账——推理服务内部的 cache 计数器(cached=118898、suffix=1759)和客户端 usage 字段(cacheReadTokens=118898、inputTokens=1759)逐字段一致,两个独立会话复现出 99.6% 和 98.5% 的命中率;而一旦后台压缩介入、前缀变了,命中率断崖式下跌,问题标题里那个「从 99% 打到 10%」就是这么来的。这是单个团队自报的案例,不是普适测量,但它把杀伤路径说清楚了:真正的坑不在「你主动压」,而在「没人盯着的后台压缩路径」也会顺手改前缀。知乎
《Cache Engineering for Agents》给出了更狠的数字:在 GPT-OSS-120B 上,只保留最近 12 轮工具回复的「截断」方案,成本反而是全上下文基线的 1.85 倍。原因和上面同一条链路——历史前缀一改,后面所有已缓存的部分全部作废,必须整段重新 prefill,省下来的读取量抵不过重算的开销。摘要路线同样不便宜:48k 阈值触发摘要,成本只降了约 7%,精度先掉 5 个百分点。论文那张精度—成本平面把取舍摊得很明白:摘要阈值从 48k 抬到 96k,点就沿着「更贵更准」的方向移动。知乎
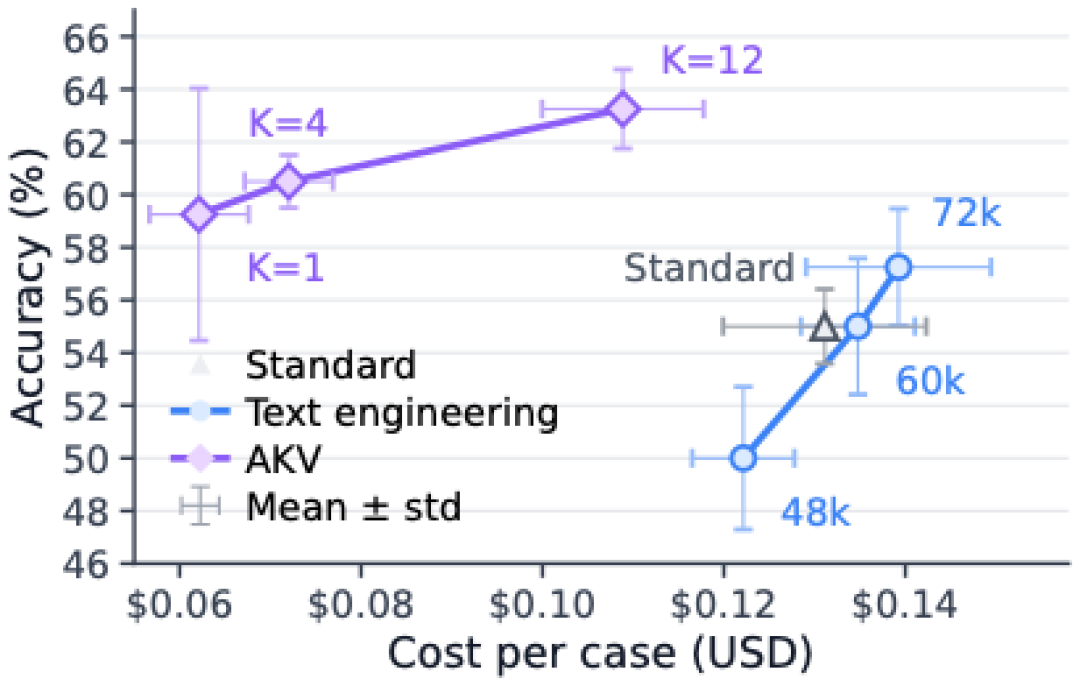
也就是说,截断和摘要动的都是「轨迹文本」,而文本一变,KV 缓存前缀作废。这不是哪一家平台的 bug,是前缀匹配这种机制的物理性质。
反直觉之二:命中价便宜一半,架不住它量最大
摊开论文的计价表看就更清楚了:GPT-OSS-120B 的 cache-miss 输入是 0.150 美元/百万 token,cache-hit 输入 0.075,输出 0.600;MiniMax-M2.7 是 0.300/0.060/1.200。命中的价格确实便宜一半甚至 80%,但 Agent 的轨迹天然单调增长,第 60 轮的一次请求要把前 60 轮的缓存全部读一遍,而输出往往只有几百 token。便宜的东西乘以累积线性增长的量,仍然是大头,这就是 82.4% 的来路。真正烧钱的东西不是生成,而是把历史缓存反复读出来再送进注意力这件事本身。知乎
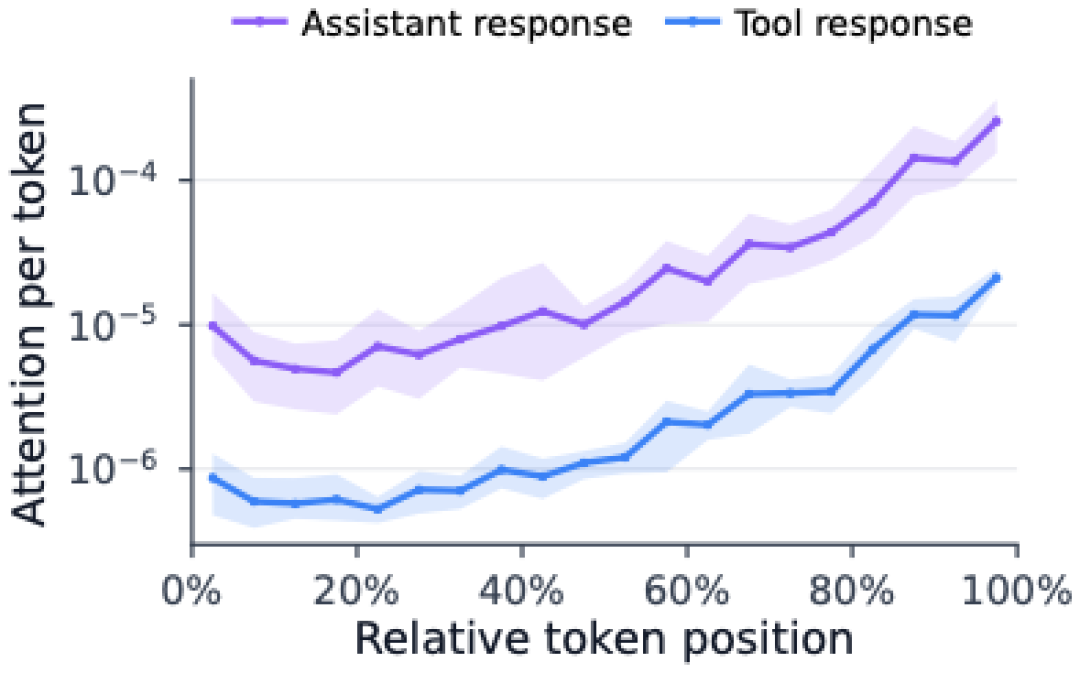
顺带一提,这篇论文在记账上做得克制:repos 的 key 旋转本可以在服务端本地完成、不算钱,但作者仍然按 cache-hit 单价给自己计费,故意高估开销。这种细节让后面的对比可信:他们的 AKV 引擎做到成本降 27.7%、精度还涨 1.7 分,靠的不是换个记账方式,而是真的不重算。知乎
反直觉之三:默认缓存,可能比不缓存还贵
OpenAI 这次改价把一件事摆到了台面上:GPT-5.6 开始,默认缓存并不总是省钱。新计费是三段式——每个输入 token 要么按未缓存价、要么按读取价、要么按写入价算。文档里对 12 小时 TTL 的原话是「does not guarantee that every request reuses stored KV tensors or has lower latency」:它首先是计费承诺(12 小时内命中,就按读取价收你钱),而不是「KV 真存了 12 小时」的存储承诺。知乎
拿它做个请求间隔的算术(解读作者也强调了:这是按价格页估算、没跑真实账单):
请求很密,间隔都在 30 分钟以内:命中会续期,30m 默认缓存一直有效,12h 只会让第一次写入多花 1.25P,纯亏,别开。
请求稀疏,两次之间超过 30 分钟但都落在 12 小时内:用 30m 缓存,每次来都已过期、每次都要重付 1.25P 写入,等于一直在为一个从没命中过的缓存买单;用 12h,第一次 2.5P,之后每次 0.1P。
一个 10 万 token 固定前缀、gpt-6.1-sol、工作日每小时调一次共 8 次的场景,就是后一种。更细的做法是按块设置:只让最稳定的那一段(系统提示、工具定义)走 `“prompt_cache_breakpoint”: {“mode”: “explicit”, “ttl”: “12h”}`,其余保持 30m。核账单时记住拆解式:普通输入量 = input_tokens − cached_tokens − cache_write_tokens,别把 cache_write_tokens 和 ttl_30m/ttl_12h 字段重复相加;顶层 instructions 和 additional_tools 里放不了显式断点。
反直觉之四:压缩最阴的坑不是丢信息,是「静默」丢
另一个 10 月刷屏的案例给所有上压缩的人提了个醒:Hermes-agent 的生产事故里,上下文压缩引擎(约 2650 行的 context_compressor.py)对超过 500 字符的工具调用参数只留头部 200 字符——致命的不是丢了内容,而是截断后的 JSON 依然合法,`json.loads` 能过,下游 API 不报错,日志里什么都没有。同一个 fleet 里,9 条和 19 条消息被静默改坏;旧逻辑追加的 `…[truncated]` 标记还会被模型从历史里原样粘回写入文件,直接制造 SyntaxError(PR #83735 修掉了标记可复制,但 200 字符截断本身没删)。Agent 没报错、退出码是 0,文件却是坏的——它把被截断的历史当成事实继续执行。
这位作者给了一条成本最低的自检命令:跑一个超过压缩阈值的会话,让它编辑一个参数超过 500 字符的文件,读回来检查两件事——文件里有没有截断标记、能不能通过语法检查。 出现标记而 Agent 没报错,说明你的压缩器正在制造静默损坏。知乎
现在真正在解题的人,分三条路
把 10 月的动静排一排,会发现「压缩 vs 缓存」之争已经不太被当作立场之争,因为工程解已经分头落地:
缓存工程路线:论文的主张是别改文本、改缓存——把活跃 KV 当成可编程对象,用 append/drop/repos 三个原语操作。三列对照图里能直接看出差别:全上下文保留全部缓存、上下文工程删前缀文本导致保留段重算、缓存工程保留全部文本、只把选定 KV 从后续注意力里摘掉(Drop 只做集合差,保留条目连位置编码都不变,所以不触发重算);repos 则是对 RoPE 做一次旋转,把 key 从位置 p 搬到 q、value 原样不动。知乎
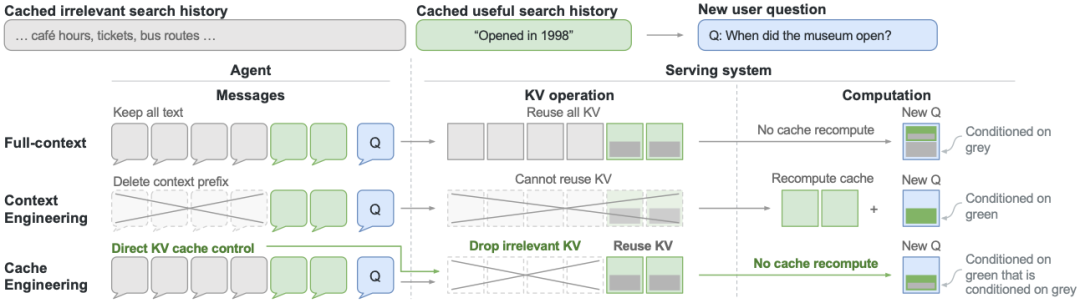
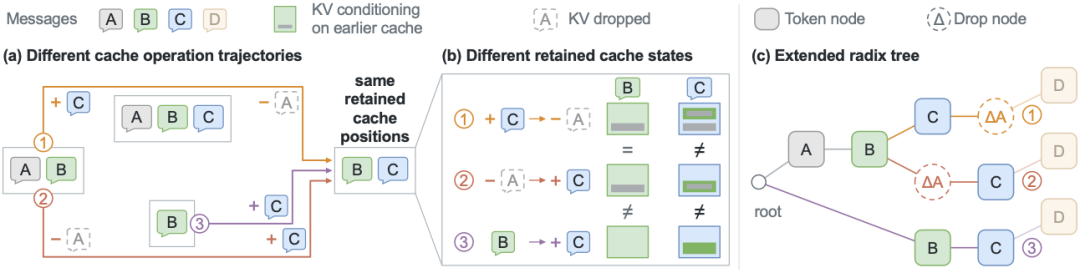
代价是系统复杂度:它要求一个请求的 drop 不能改变其他共享前缀请求的输出分布,引擎只能按操作历史分叉缓存版本——「相同的 token 前缀」不再唯一决定缓存状态。论文图 5 构造了三条都保留 B、C 的轨迹:先 append C 再 drop A 与先 drop A 再 append C 两种顺序下 B 的缓存一致、从 B 单独起步则不同,而 C 在三条轨迹里全都不一样,因为它计算时能看到的 A、B 各不相同。
中间件路线:开源的 Headroom 在工具结果进入模型之前做结构化压缩、本地保留原文按需找回,接入方式给了 Python、TypeScript SDK、本地代理和 MCP Server,对着 Claude Code、Codex、Cursor 这一票编程工具。一个人 + AI 的 ZyWork 实录用的是三层递进——工具结果过两轮只留 meta 头加前 8 行、真要完整原文让模型用 offset/limit 分段重读。B站上「98K 压到 7.6K」的实测和 ISSTA/FSE 的论文(AttnCompress、AgentDiet)也在同一个问题上:压缩之后,丢的信息怎么找回来。知乎知乎
平台与模型路线:DigitalOcean 上了缓存亲和路由,把命中率从 30% 多提到 90% 以上(GLM-5.3 从个位数提到 88%–95%,Kimi K3 前缀复用长提示下 92%+;注意这是厂方 10 月测试口径,实际结果可能不同),Agent 请求里超过 90% 的输入 token 本来就是已处理内容,缓存输入费用最高降 90%、首 token 延迟最高降 80%。DeepSeek 开源 DeepInfer 时公开了自己的做法:KVCache 全部放在独立的 3FS SSD 集群里,设计目标是保留 72 小时以上。V4.1-Flash 则挂着「1M 上下文 + 437 倍 KV 缓存压缩」继续往模型侧压。三家设计取向也分出来了:OpenAI 在往 Anthropic 的「显式控制 + 写入溢价」靠,可预测;DeepSeek 走「后台全包、价格压到最低」,省心。知乎知乎哔哩哔哩
底层翻车也没停:Cloudflare 复盘的 GLM-5.3 事故里,155 次响应把其他客户的内容带了进去——根因正是多租户共享的分页 KV Cache:模型宣称支持 1,048,576 token 的窗口,那台推理机的 KV 池实际只装得下 681,280,页面复用又不提前清零。工程上讲,模型说自己支持一百万 Token,不代表当前这台推理服务器真的给它留够了缓存空间。知乎
一张分流清单:先对账,再动手
结合这个月所有案例,给正在纠结「要不要开压缩、要不要换缓存配置」的中重度 Agent 开发者一个顺序——别先改代码,先改账单读法:
拆账单构成:把 cache_read、cache_write、未缓存输入、输出四项分开看。如果 cache read 占大头(82% 不是个例,是结构),你的优化对象是缓存工程,不是压缩率。
量请求间隔:密集会话保持默认短 TTL;稀疏长会话按 OpenAI 那张三段价目表算写入溢价,只给最稳定的前缀块上显式长 TTL;别为从没命中的缓存付 25% 写入费。
审压缩器改不改前缀:逐字节 diff 一下压缩前后的请求前缀;把系统提示、工具定义、历史消息的「头部稳定性」当成契约来测,特别审计没人盯的后台自动压缩路径。
给压缩设底线:列出所有会写盘/执行的工具,检查参数是否被压缩器触及;截断标记必须不可执行、不可复制;每次压缩后跑一次语法/Schema 校验。丢得起的是工具输出的正文,丢不起的是参数和规格。
值得继续盯的信号:Codex「永久缓存」等传言以官方文档为准(目前文档里只有 TTL 计费口径);Codex 的 experimental_mode(换新窗口 + 外部笔记)什么时候敢默认打开;AKV 这类缓存工程原语会不会被 vLLM/SGLang 吸收进主线;以及——如果平台侧缓存越来越便宜,你手里的压缩中间件还值不值得多一跳。
最后留个讨论题:你的 Agent 账单里,「读缓存」和「生成」的占比是多少?如果 82% 这个数字在你身上也成立,你打算先动压缩器,还是先动缓存配置?评论区晒一下你的四项拆分。