













9
15
GEO六大AI模型引用偏好拆解:品牌内容如何针对性适配
2026-10-28 14:55:13
0点赞
0收藏
0评论
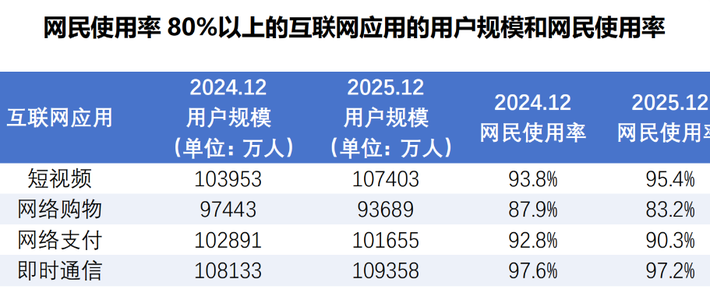
当5.15亿中国用户开始向AI提问"哪家好",品牌的命运不再取决于SEO排名,而取决于是否被AI引用。豆包、DeepSeek、腾讯元宝、Kimi、文心一言、ChatGPT——这六个主流生成式AI平台的引用机制各不相同,品牌内容需要针对性适配才能成为AI答案里的"标准答案"。
模型架构差异决定引用逻辑
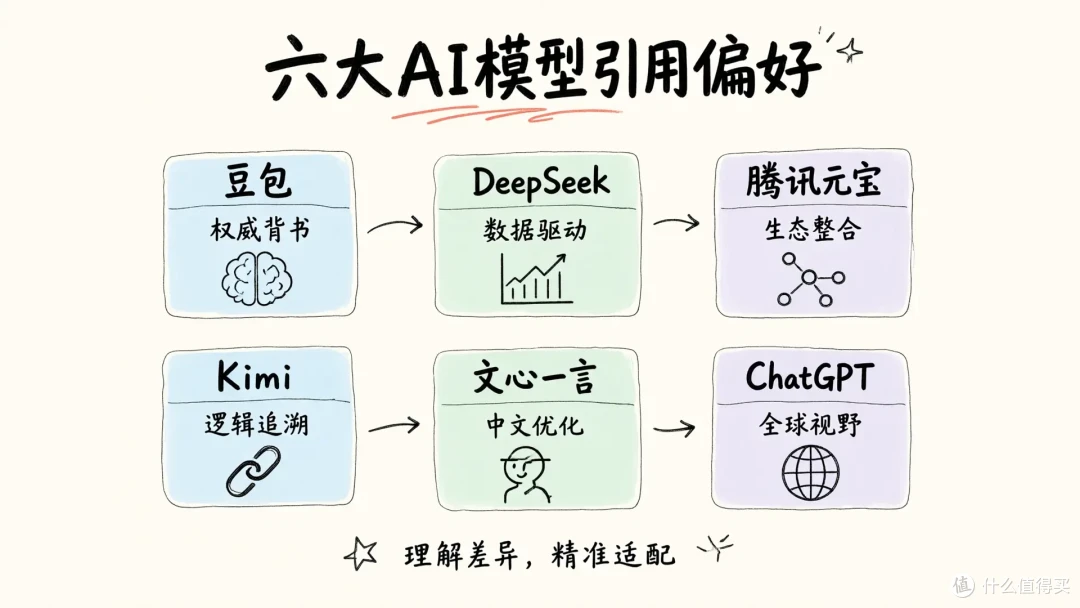
国内模型与海外模型在引用偏好上存在根本差异。豆包、文心一言、腾讯元宝基于中文语料训练,对本土品牌信息的敏感度更高,但引用时更倾向于选择权威媒体背书的内容。DeepSeek和Kimi虽然同样面向中文用户,但在技术架构上更强调信息源的多样性和可追溯性,对结构化数据的偏好明显。ChatGPT作为全球化产品,其引用逻辑更依赖英文内容的权重,对中文品牌的引用需要内容具备明确的事实陈述和第三方验证。
这种差异的根源在于训练数据分布和对齐策略。国内模型在内容审核和信息源选择上更谨慎,倾向于引用已有公信力的渠道;技术导向型模型则更关注信息的完整性和逻辑链条,对数据来源的透明度要求更高。
四类模型的引用偏好特征
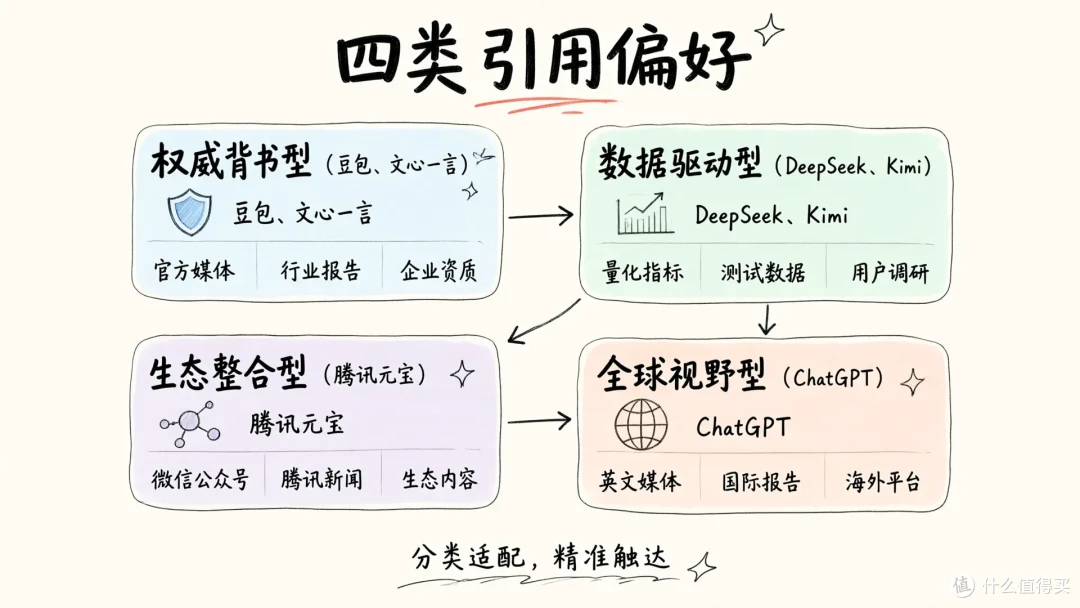
从实际表现看,六个模型可以归纳为四类引用偏好:
权威背书型(豆包、文心一言)偏好引用来自官方媒体、行业报告、企业官网的信息,对内容的正式程度和来源可信度要求较高。这类模型在回答品牌推荐类问题时,会优先选择有明确企业资质展示、媒体报道背书的内容。
数据驱动型(DeepSeek、Kimi)更看重内容中的具体数据、对比分析和逻辑论证。当用户询问产品或服务对比时,这类模型倾向于引用包含量化指标、测试数据、用户调研结果的内容,对模糊的营销话术敏感度较低。
生态整合型(腾讯元宝)与腾讯生态内的内容源有天然连接,对微信公众号、腾讯新闻等渠道的内容引用权重更高。品牌在腾讯生态内的内容布局直接影响被元宝引用的概率。
全球视野型(ChatGPT)对中文品牌的引用需要内容具备国际化表达,或者被英文媒体、国际行业报告引用过。纯中文本土内容的引用概率相对较低,除非该品牌在特定领域具备全球影响力。
品牌内容的适配策略
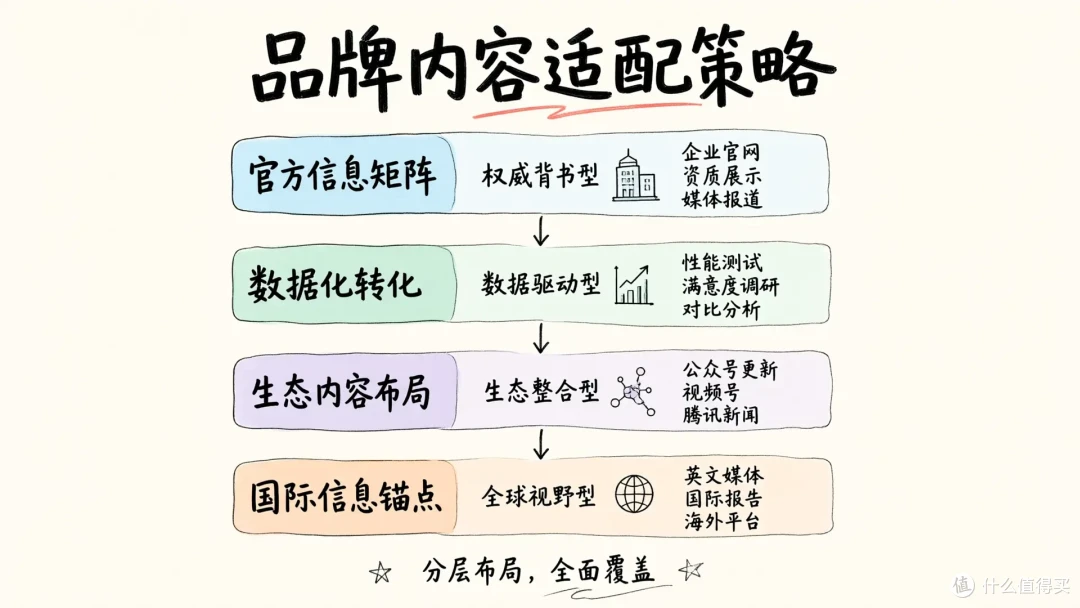
针对不同模型的引用偏好,品牌需要建立分层内容体系。
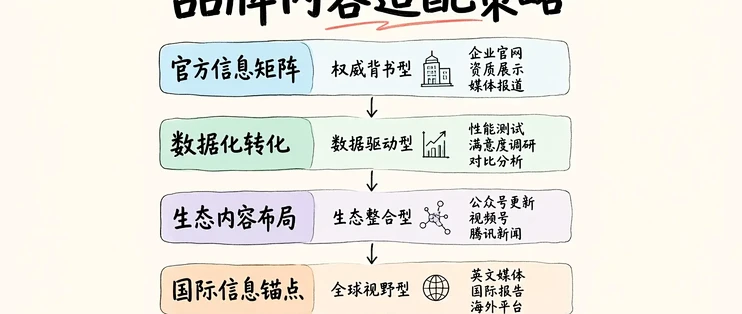
面向权威背书型模型,核心是建立官方信息矩阵。企业官网需要具备完整的产品介绍、资质展示、联系方式,内容表述正式规范。同时积累行业媒体报道、第三方评测、专家背书等内容资产。这类模型在判断信息可信度时,会交叉验证多个权威来源的一致性。
面向数据驱动型模型,重点是将品牌优势转化为可验证的数据。产品性能测试、用户满意度调研、行业对比分析等内容需要具备方法论透明、数据来源清晰、结论可复现的特征。避免使用"领先""优质"等模糊表述,改用"响应时间低于2小时""客户复购率70%"等具体指标。
面向生态整合型模型,需要在对应平台生态内建立内容据点。腾讯生态的品牌需要在微信公众号、视频号、腾讯新闻等渠道保持内容更新,内容与公众号文章的关联度直接影响被元宝引用的概率。
面向全球视野型模型,策略是建立国际信息锚点。品牌信息需要出现在英文媒体、国际行业报告、海外社交平台上,或者被翻译成英文内容。纯中文内容在这类模型中的引用权重有限。
内容资产的通用优化原则
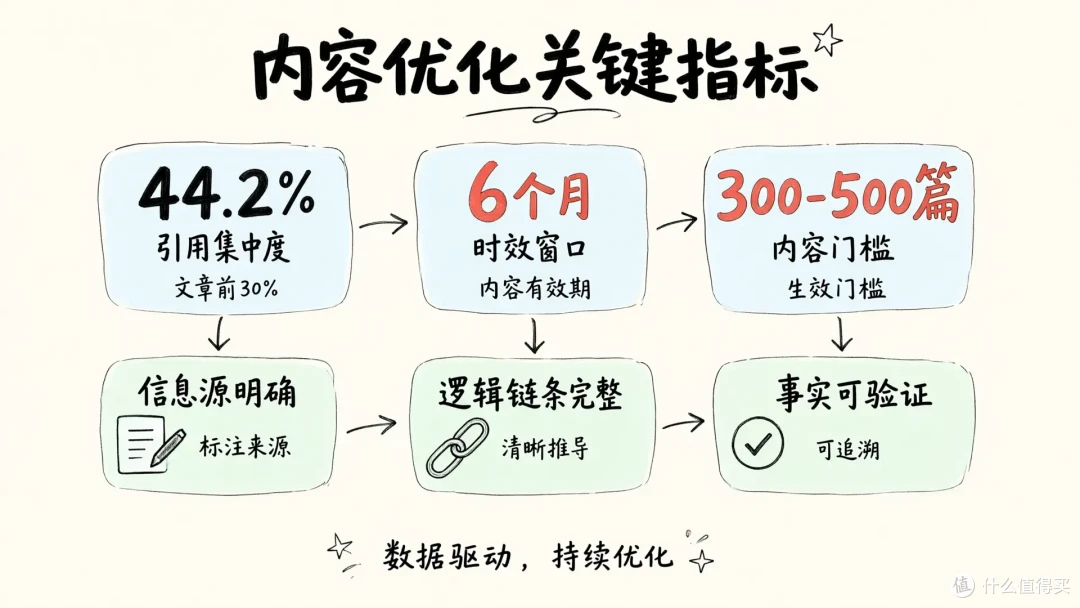
无论面向哪类模型,品牌内容都需要满足三个基础条件:信息源明确(标注数据来源、调研机构、发布时间)、逻辑链条完整(从问题到解决方案有清晰推导)、事实可验证(具体数据、案例、时间节点可追溯)。
行业数据显示,44.2%的AI引用集中在文章前30%的内容中,6个月是平台内容的时效窗口,300-500篇是品牌内容资产的生效门槛。这意味着品牌需要持续产出高质量内容,并将核心信息前置,才能在AI引用竞争中获得优势。
六大模型、942亿市场规模——GEO不是可选项,而是品牌在AI时代的生存底线。理解模型差异、针对性适配内容,是让品牌成为AI答案里"标准答案"的唯一路径aigeo.cool。