「手册」比对话更费钱:这周四份省Token实测,和三种省回原点的方式
国庆那几天,圈里吵的还是账单:档位、限额、薅羊毛薅不动。这周一过,风向突然变了——Anthropic官方成本指南被逐条搬运,Pi连着发了三个版本,好几个UP主和独立开发者不约而同晒出同一类东西:实测数字。而且几份互不认识的实测,最后都指到了同一个反常识的地方:token不是烧在你跟AI说的那些话上的,是烧在你每次开口前,顺手塞给它的那一叠东西上的。
如果你这个月账单看着肉疼、但说不出钱具体漏在哪,这周的信息密度值得花十分钟看完。下面按「四份实测→一笔账→三种翻车→谁装谁等」来过。
一、四份实测,四个入口
1. MCP工具手册:10979 → 162
独立开发者activeing123把自己的OpenClaw挂接MCP的请求载荷抓了下来:工具定义(俗称「工作手册」:每个工具叫什么、能传什么参数、有啥坑)一共10979个token。 关键在机制——不是用到才发,是每轮对话都重发一遍。你以为AI在干活,其实它每次开口前都在重背说明书。知乎
更反直觉的是:他把「手册」里的描述文字压缩了一遍,实测一个字节都没省下来。原因很简单:标准MCP协议要求客户端在握手阶段拉取全量工具定义,问题出在「怎么发」,不在「存成什么样」。他换的思路是「只发目录」——平时每个工具一行名字加一句话,真要调用时才回填完整Schema:每次对话的常驻开销变成162个token,省98.5%。另一篇同作者的实测里,255个工具的全量Schema压进System Prompt,改造后省下71,348个token,幅度99.2%。 他还特意补了一个口径:162是「平时」的成本,真要调试某个工具的那一刻,那一页还是得发。省的是常驻,不是按需。知乎
2. 自建Coding Agent:同一任务比Claude Code少58.7%Token
知乎作者「许哥做AI」自己写了个Coding Agent,和Claude Code跑同一个真实任务,条件尽量对齐:结果Claude Code平均158.4万token,他的Agent平均65.5万,少58.7%。 两边都把任务做完了——253个测试,0失败。知乎
有意思的是差距来源:两边的Model Call次数没拉开,真正拉开的是每次调用装了多大上下文——23.7K对56.7K,2.4倍。 他的做法就两条:先读代码结构(函数、类型、符号在哪)再决定读哪个文件,别整文件往嘴里塞;以及把「完整状态」和「每次喂给模型的上下文」分开存——做过什么、读过什么都记着,但不必每次重新给模型看一遍。知乎
作者自己先泼了冷水:只有1个任务、3次重复,且这个任务恰好吃「代码结构导航」的红利。这58.7%目前只够证明方向有效,不够证明普适。
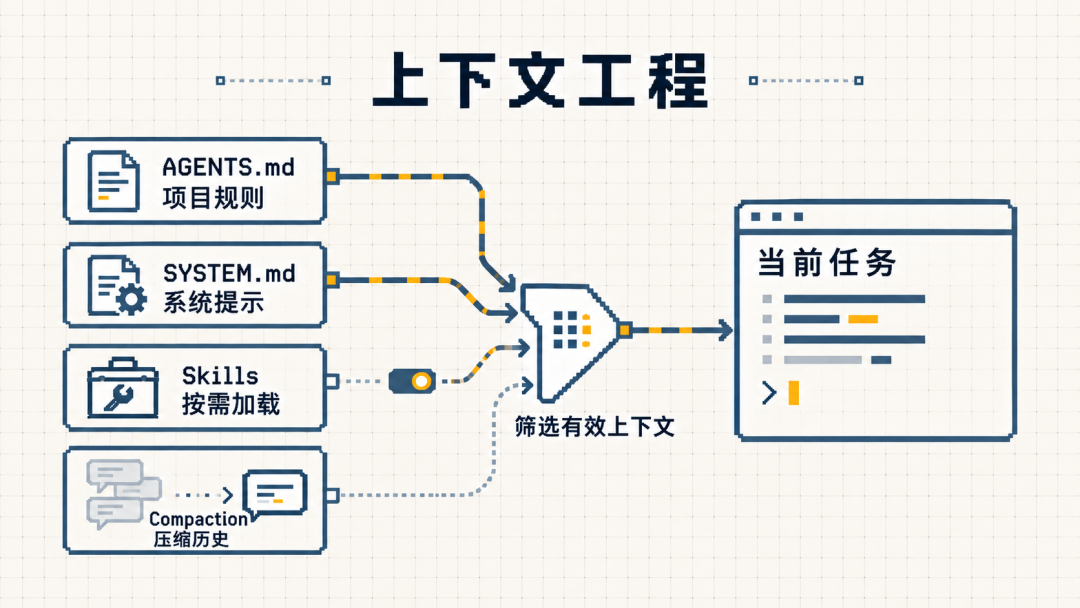
3. Pi 1.0:codemode系统提示词5300→3300,20工具首请求省72%
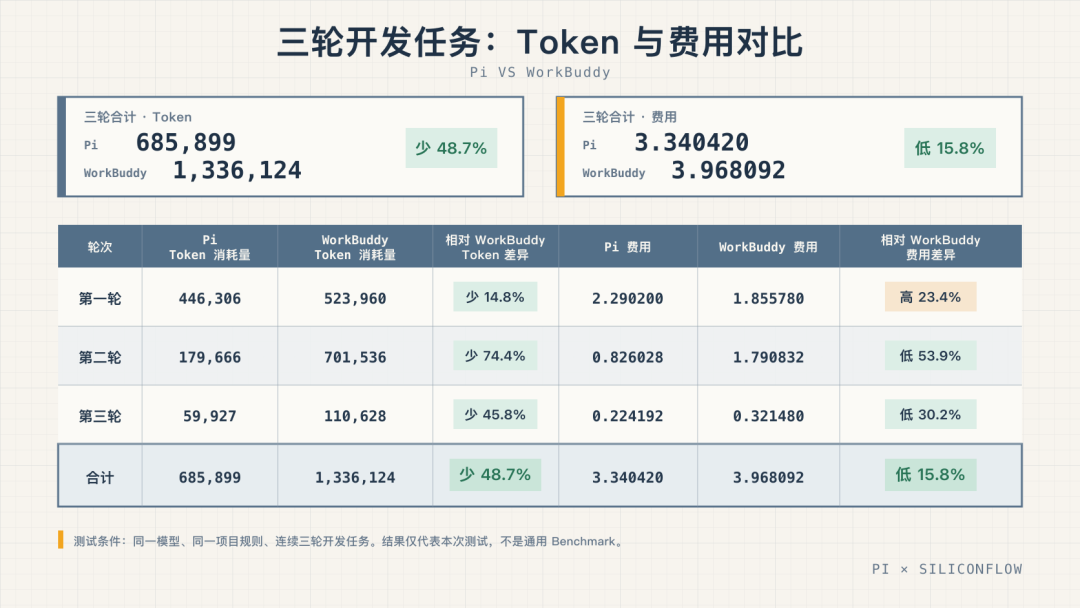
GitHub上10万星的那个极简Agent Pi,10月4日一口气发了1.0.0/1.0.1/1.0.2。社区梗是:它以前把「不做MCP」写进README,现在不但做了,还做成了默认。B站两个实测视频对完release notes,对钱包最相关的三条是:codemode把系统提示词从5300瘦到3300。 MCP工具分四档曝光,没被调用的工具一个schema token都不进请求;实测20个工具挂载时,首个请求省72%。哔哩哔哩哔哩哔哩
升级注意:全屏默认和`–provider`报错行为这两条会改变现有习惯;另外那个pi-durable还是实验性质。
4. 人设省Token:711K → 138K(这份先别信)
B站UP主「AAA私人终端厂家直销」在做roleplay coding插件时发现:同一个任务、质量基本一致的情况下,DeepSeek-Flash官方极简模式吃711K token,换成「硬邦邦」人设只要约138K,中间档「万机之神」约300K,「鲸鱼娘」约389K。 人设居然影响token消耗——这直接踩在社区共识之外,评论区吵得最凶的就是这条。哔哩哔哩
但注意证据强度:单任务、单次对比、限一个模型、作者自己也说「没想到」。这份应该当成「值得你自己拿真实任务测一测的假设」,不是结论。
二、为什么省的是这些地方:一笔官方口径的账
把上周疯传的Anthropic成本指南(「老金」那篇逐条搬运的原文)和本周这几份实测对起来,账就清楚了:
一个Agent任务是个循环:读对话→调工具→读结果→再来一轮。每一轮都要把到目前为止的整段对话重发一遍。官方案子:上下文从20K涨到120K、跑40轮、平均每轮发70K,账面280万输入token——你的对话明明从没超过120K。知乎
影响账单的就四个变量:轮数、每轮发的上下文、单价、输出(含thinking)。缓存读取只要输入价的1/10到1/20,而一个输出token是一次缓存读取的100倍。
对照本周四份实测:砍手册常驻、砍每轮上下文、瘦系统提示词——全部命中「每轮发的东西」这一项,所以数字才这么好看;而人设那个711K→138K,动的可能是模型消化提示词的效率,属于另一个维度的事。
顺手记两条能保命的细则:改effort会清缓存,所以档位要在任务断点改,别问一半来回拨;摘要压缩约10轮才回本,快干完的项目别压——调试到一半压缩,可能正好丢掉唯一关键的那行日志。
基准线:官方企业平均是每个开发者每个活跃日约13美元,90%不超过30。 你的数明显高出,就翻出对应会话看是哪一步多花的。

三、三种「省回原点」的方式
实测数字越好看,越要把反面摆出来。「省 token 省过头,一次重试就全赔回去了」这个标题之所以这周刷屏,是因为它真实发生过太多次:
省到任务失败:每一种省法都可能让模型少看它本该看的东西。一次重跑的花费大于前面省下的总和。动手省之前,先给模型一个能自查的办法(一个跑得动的测试、一次构建、一个调接口的脚本)——能自己验证才能早停错,这是省轮数的根,不是加effort。
省在常驻、亏在配置:接这类网关/目录式方案,等于在工具链里塞进新失败面。同作者的三个现成坑:Node版本差一个小版本装不上、列工具超时写死1500毫秒在慢机器上永久卡住、key写成明文触发401。而且这类社区项目才两百多颗星,别按成熟产品预期它。改完第一件事不是看省了多少,是像那位作者一样先测「还好不好用」:让模型调个最简单的工具、回一句固定的话,确认选择的路径没变。
信了不该信的样本量:58.7%是1任务×3次,711→138是n=1。证据覆盖到哪里,结论就只能说到哪里——这两份实测的价值是给出「该量什么」的方法,不是给你省钱的保证书。
四、谁该装、谁该等
按你现在的工具栈对号入座:
Claude Code / Cursor + 挂了5个以上MCP的:本周优先级最高的一件事不是换工具,是量一下你的手册有多厚——抓一次请求载荷,或跑`/usage`看会话开局开销。第一刀砍最懒的:把不用的工具卸了。确认要长期挂几十个的,再去试目录式网关,保留原配置以便回滚。
大仓库、长会话、天天重复读文件的:Pi 1.0值得开个分支试;不想离开Claude Code生态的,先照抄「结构先行+State≠Context」两条思路,在CLAUDE.md里引导它先列符号再读文件,不用等任何新工具。
DeepSeek-Flash等国产模型用户:人设省token当彩蛋测,别当生产力换;官方极简模式711K那格如果在你这也复现,值得换个人设重跑一遍看看稳定性。
管团队账单的:先立基准再谈省——每人每活跃日13美元上下是官方均值,把明显超标的高消耗会话翻出来,看是轮数失控还是每轮超重,前者修任务拆分,后者查工具和上下文。
先等的:pi-durable(实验性质)、没有权限说明的第三方网关项目、以及任何「一套人设/一句咒语全模型通用」的说法。
今晚睡觉前可以做一件十分钟的事:开个真实任务,量三个数——开局塞了多少token的工具定义、平均每次模型调用带多大上下文、这单任务一共跑了多少轮。这周之后,省token的新玩法只会更多,到时候每篇你都拿这三个数去对:它到底动的是哪个变量。
动「每轮发的东西」的,通常真省钱;只动「单价」的,先去看账单细则;什么都不动只换话术的,划走。