三百页的扫描合同摆在桌上,需求只有一句:把里面的报价表整理成 Excel。上传到在线 OCR?客户名单和底价都在里面。手动敲?三天。
这类活儿以前只有两个选项:把文件交出去,或者熬人。现在多了第三个——把模型装在自己电脑上。
10 月 27 日,百度开源了 Unlimited OCR 2。总参数 3B,每次推理只激活 500M。新智元
官方演示里,它把《哈利·波特》七部、3623 页一口气读完,用了一小时半,平均 1.5 秒翻一页。上一代的极限还停在 40 多页。量子位新智元
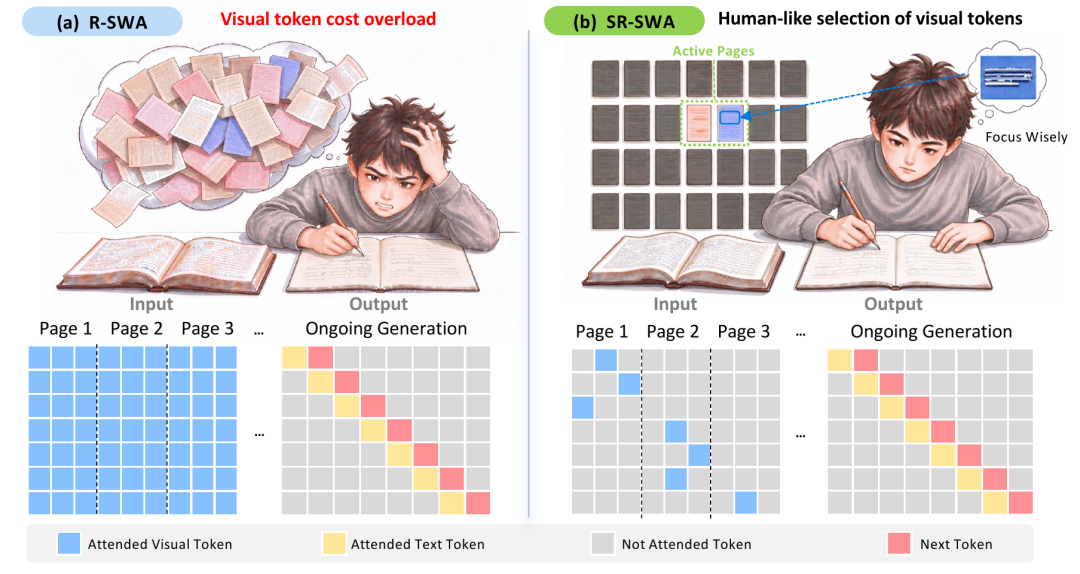
真正让这件事成立的不是参数,是两处抠门。解码时每一步只看固定数量的视觉 token,文档再长,单步开销也基本不变。读整本时按块推进,相邻块共用一页,只保留这页的缓存和上一段的尾巴。
百页测试里,峰值 KV 缓存从 47GB 压到 1.77GB,省了约 96%。量子位
听起来像发布会话术,量子位做了次笨办法测试:丢进 884 页英文《指环王》,42 分 56 秒跑完,平均 2.9 秒一页。抽查第 600、750 页,文字和原文对得上;全书还标出 466 处跨页合并。量子位
硬件配置没写,只能算一次单点实测,但至少证明“整本书一次过”不是 PPT。
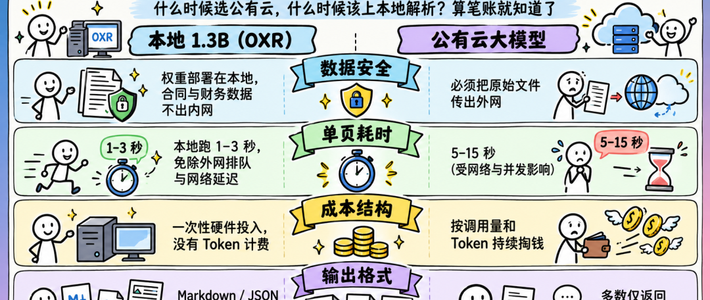
同一周,另一个国产小模型 OXR 也在圈里传。1.3B,SigLIP2 加 Qwen3-0.6B,单卡 24G 就能拉起来。官方给的串行解码是 557 token/s,差不多一秒一页。刘聪NLP甲木未来派
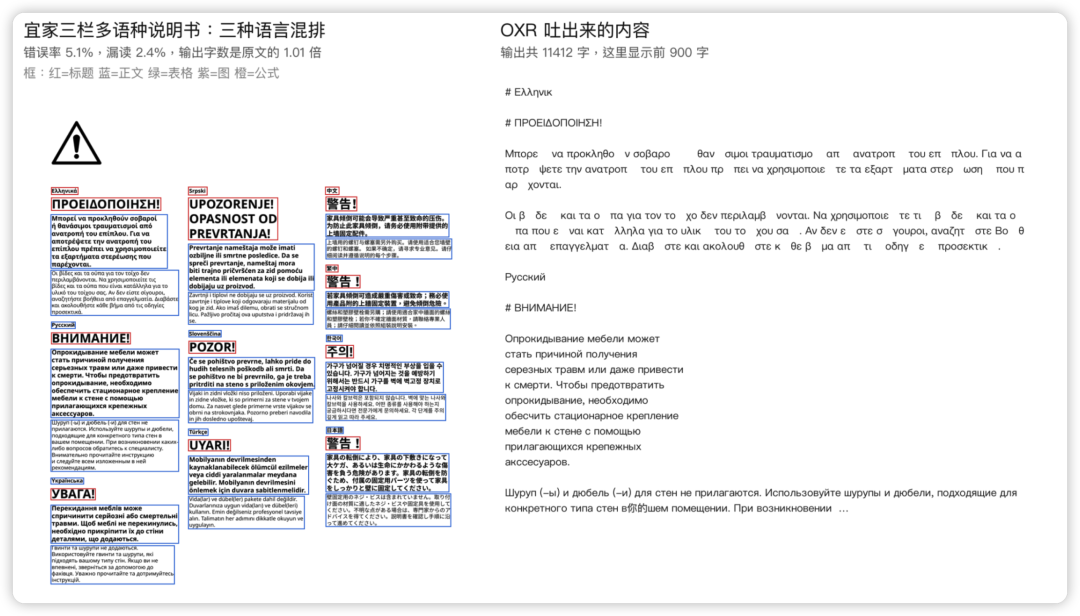
它不拼页数,拼的是版面:多栏、合并表头、公式、代码块,连化学结构式都能直接吐成 SMILES 字符串。
于是熟悉的一幕来了:两家都说自己第一。
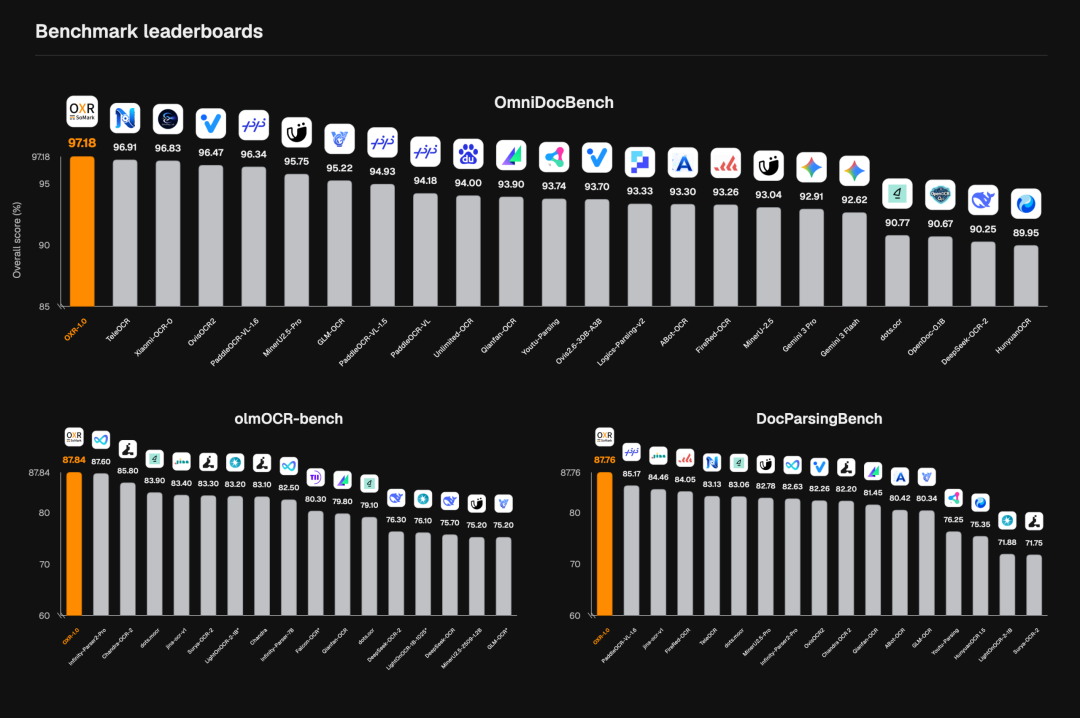
百度的 84.59 和 77.06 出自自家技术报告,长文档那一项用的还是团队新建的 MarathonDocBench。OXR 说自己在 OmniDocBench 等三个榜排第一。量子位甲木未来派
公开的 OmniDocBench v1.6 上,中国电信 1.2B 的 TeleOCR 拿过 96.87。魔搭社区
几个模型都不大:OXR 1.3B,TeleOCR 1.2B,Unlimited OCR 2 也只有 3B。本地文档解析过了可用线,但“第一”取决于谁搭的台子、比的是哪一版。按标题选模型,等于掷骰子。
更该看的是坏消息。
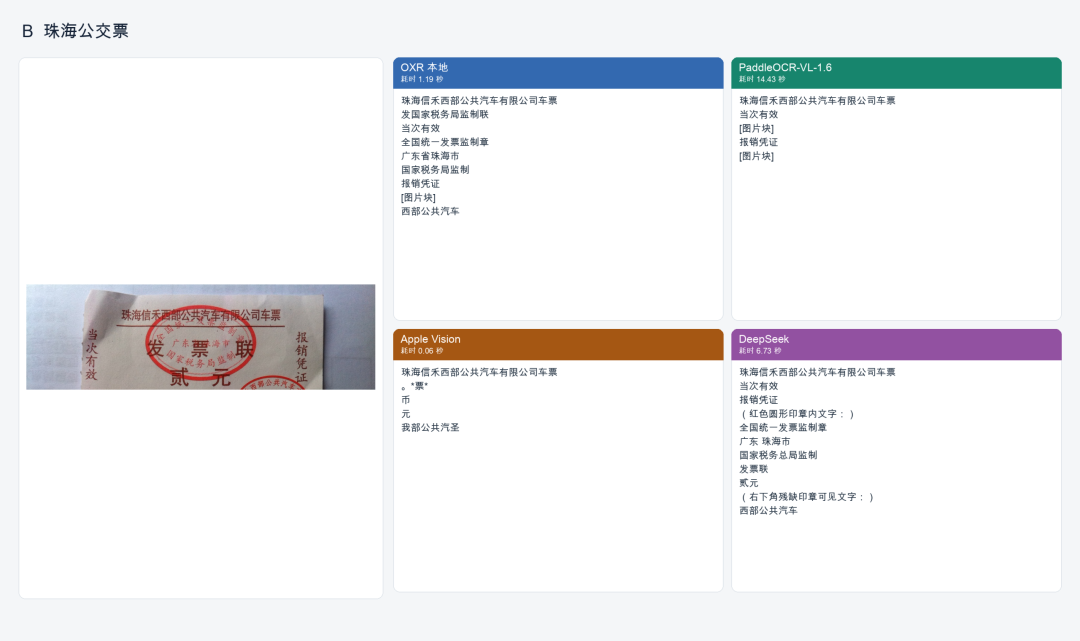
做 OCR 测评的刘聪拿 18 个真实场景轮着测:生僻字大面积认错,跨页的连续表格 OXR 会断成两张,竖版排版反而不如 PaddleOCR 稳。刘聪NLP
褶皱厉害或者红章压住字,模型会重复输出。
甲木把同一页弯到不同角度:45° 以内能用,60° 开始整行漏字,70° 以上大半页读不出来。这些失败跟模型大小关系不大,问题在输入端:拍歪、反光、压章,像素先烂了。甲木未来派
部署也有暗礁。官方给的部署方式是 Transformers 加定制版 SGLang;基准是在 A800-80GB 上跑的,这个数不会写在海报上。梦回1874
模型卡里的分块示例是 10 页一块。块切得越小越省显存,跨块上下文丢得越多。
“任意页数”和“跨页表格不断”,本身就是一对拉扯。
8GB 卡能不能跑,取决于切多小、量化到什么程度,别把演示里的 3623 页当成默认参数。
它适合的活儿其实很具体。
手里是整本标书、年报、内部合同,打算转成结构化文本进本地知识库的人,值得拿 20 页最难的文档试一次。重点看两处:跨页表有没有接上,标题层级有没有乱。
只处理单张票据、手机截图,Umi-OCR 这类轻工具就够,没必要上 3B。
古籍和生僻字多的材料,先别抱期望。照片皱得厉害,先重拍、做梯形校正,比换模型有用得多。
回到那摞合同。
真正决定你今晚加不加班,可能不是哪个模型拿了第一,而是扫描件有没有拍正、跨页的报价表有没有人核一遍。