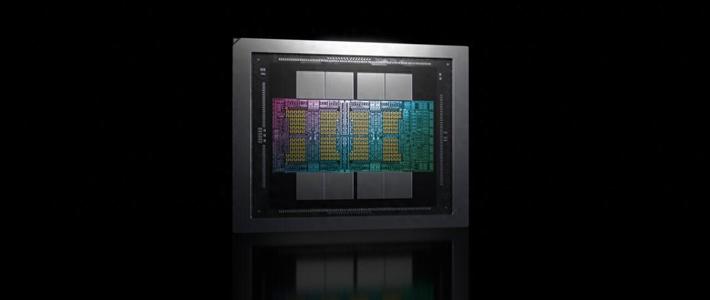
11月16日,在芝加哥举行的超算大会SC26上,英伟达正式发布Rubin HPC:单颗GPU搭载超过5万个CUDA核心,创下英伟达GPU产品线的核心数纪录,同时引入稀疏数据加速和第七代NVLink互连。 这颗芯片预计要到2028年才上市,而目前详细参数一个都没公布。华尔街见闻彭博速报卓世科技
此Rubin非彼Rubin:这是给超算新开的一条产品线
标题里的"Rubin"容易让人联想到那颗跑大模型的旗舰GPU,但Rubin HPC和它不是一回事。英伟达的官方口径是,它是Vera Rubin平台新增的一款GPU,专门面向科学、工程和数据分析工作负载。 作为对照,今年7月英伟达宣布全面量产、被超过300家合作伙伴部署的,是主打AI训练与推理的那颗Rubin。 同一代平台正式拆出两条GPU产品线,这大概是SC26上比核心数本身更值得注意的变化。华尔街见闻36氪
为什么宣传的是CUDA核心,而不是算力峰值
这颗芯片的设计逻辑和普通AI卡明显不同。科学计算里的大量工作——稀疏矩阵运算、模板计算、排序、归约——主要落在通用CUDA核心上,而不是服务稠密矩阵乘法的Tensor核心;单纯堆核心也解决不了问题,关键是别让几万个核心排队等数据。英伟达给Rubin HPC的定义正是让数据移动与计算能力保持平衡,通过加速这些科学计算高频操作来提高整体效率。华尔街见闻
5万核有多夸张,缺口就有多大
参照系可以借媒体给的对比来建立:消费级旗舰RTX 5090为21760个CUDA核心,工作站卡RTX PRO 6000 Blackwell为24064个,Rubin HPC的规模是它们的两倍以上。 但同样要清醒的是,目前公布的只有核心规模和互连代际,显存容量、带宽、FP64双精度算力、功耗和价格全部缺席。驱动中国卓世科技
真正的主角:智能体加仿真的科研循环
按英伟达的说法,AI智能体正在变成科研流程的一环:提出假设、调用仿真工具验证、再依据结果调整研究方向,仿真越快,单位时间内能筛选的候选材料、分子结构和设计方案就越多。硬件之外的配套是CUDA-X工具链的落地案例:在事件视界望远镜(EHT)项目里,射电天文数据的关联处理原本需要一个多月,GPU加速后被压缩到8分钟。华尔街见闻
英伟达同时把科学计算的底座做成了整机生意:面向HPC的Vera CPU机架级平台,预计2027年初起由戴尔、HPE、联想和超微电脑供货。 这一届SC26又恰逢CUDA发布20周年,官方称其开发者已达千万量级——英伟达显然想把二十年攒下的软件生态,整体搬到智能体时代的科研流水线上。华尔街见闻
所以,Rubin HPC眼下更像一份精确到2028年的路线图:纪录性的核心数、针对稀疏负载的定向设计、明确推迟两年的交付节奏。值得盯的节点依次是完整规格披露、2027年初Vera CPU机架供货、以及2028年上市后实测的能效与客户名单。在那之前,"超5万CUDA核心"证明的是英伟达对科学计算市场的重视程度,还不是一颗可以下单的产品。