上周全网都在转同一场实测:海外博主把25万Token的长文本喂给RTX 5090,32GB显存的单卡直接"爆仓",降速到每秒1.5字;而整机功耗才385瓦的M5 Ultra Mac Studio靠统一内存全程吃下,每秒25字,反超15倍。哔哩哔哩
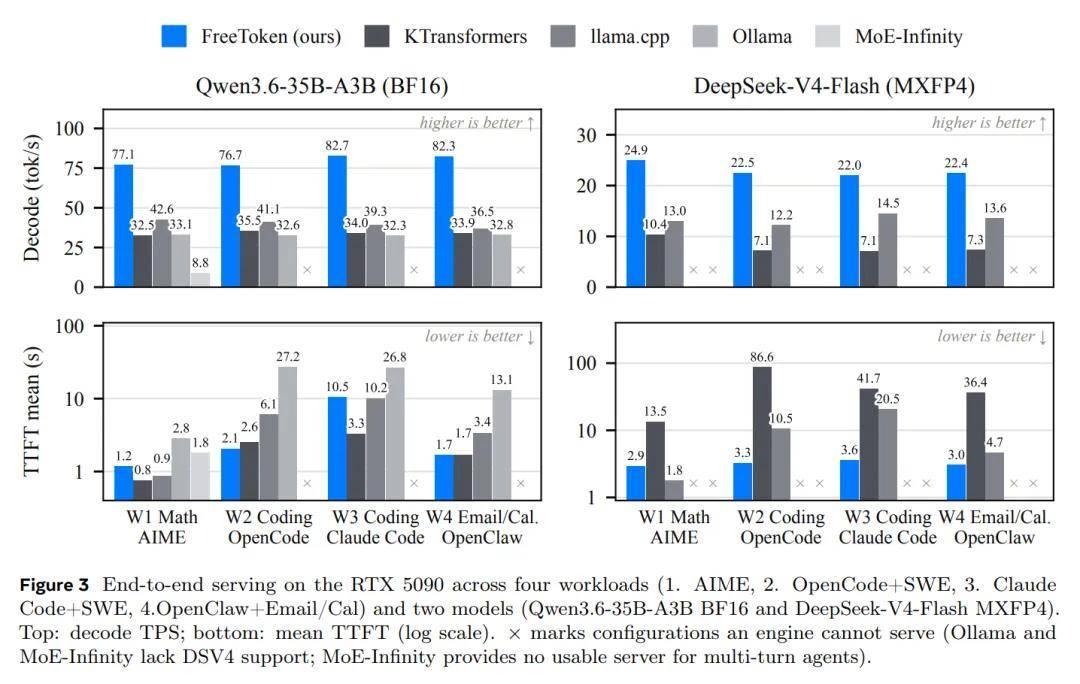
评论区瞬间炸锅:"游戏卡不配玩AI了?"先别急着挂闲鱼,这笔账要摊开算——而且记住,这是一次实测,不是一条定律。
22万机器到底买到了什么
512GB版M5 Ultra Mac Studio开订了,定价$22,299,而能塞进去的最强开源模型,按基准跑分大约相当于四五月份的Claude。哔哩哔哩
钱买的是容量:GLM-5.3、DeepSeek V4.1 Flash、Kimi K3这些全量级开源模型第一次能整塞进一台机器,光内存从256GB升级到512GB就要多加$11,500——单独一个内存选项就敢要价$15,500。够强,但别指望它追平最新云端旗舰。哔哩哔哩
15倍不会告诉你的三个真相
1. 15倍只在长文本成立。日常短对话和代码补全,5090的算力和显存带宽依然是碾压级;对比过四台本地设备的知乎博主结论很直接:M5 Ultra的GPU算力也就和DGX Spark一个档位。而Mac的短板在预填充,首字延迟慢近一倍是绕不开的体验账。一次喂整个代码仓库的Agent任务,感受最明显。知乎哔哩哔哩
2. 一台机器一次只伺候一个人。多任务并发会抢内存带宽,体验掉得很快,这不是服务器。哔哩哔哩
3. CUDA的墙还在。LM Studio、oMLX、TensorFold、Splash这些引擎确实把Mac的路铺好了,但如果你重度依赖vLLM、SGLang这一档企业级推理栈,Mac更像会聊天的书房,不是车间。知乎
PC阵营的反击
同期另一场实测给出了完全不同的性价比曲线:16GB显存加64GB内存,热点专家和注意力缓存放显存、其余权重不硬塞,100B级MoE照样能跑——真正卡脖子的是内存,整机投入只有Mac的十分之一。痛处也明牌:84GB的量化模型加载完,浏览器多开几个标签页一触发换页,速度从40 tok/s直接跌到个位数。评论区还有第三派:两台256GB Mac组RDMA集群,性价比完爆单机512GB。预算到了这个段位,大家开始拿集群当省钱方案。知乎哔哩哔哩
到底买不买,三句话
预算1-2万、主要玩100B级MoE、能忍速度 → PC+大内存+llama.cpp/Strata,显存不是瓶颈,内存才是。知乎
一个人用、要跑K3这个级别的全量模型、常有超长文本任务 → M5 Ultra 256GB起步,$15,500的内存溢价先别碰,等模型真装不下再说。
团队共享、要训练微调、要企业级吞吐 → 数据中心卡+vLLM,个人工作站赛道别硬凑。
15倍的反超是真的,但"苹果掀翻英伟达"的故事,得等你自己的首字延迟账单寄到才算数。