有人晒过一笔本地跑大模型的体验:这台机器的本地上下文最多到二百五十六K,云端已经把一百万当标配,贴一篇长文档,第一个字要等四分半,而这些短板加钱也消不掉。另一边,晒配置的帖子里,211、1750这样的数字并不少见。这两边可以都没有说谎,因为它们测的根本不是同一段时间。哔哩哔哩
等第一个字,看的是“读”的速度
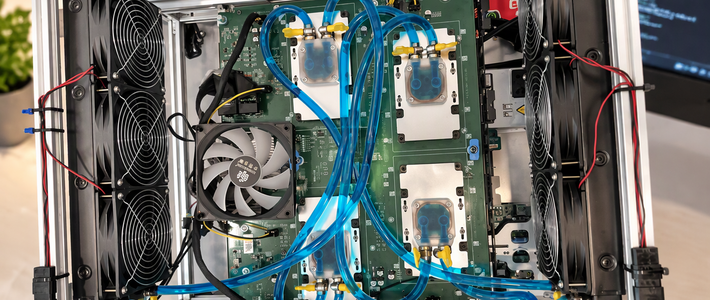
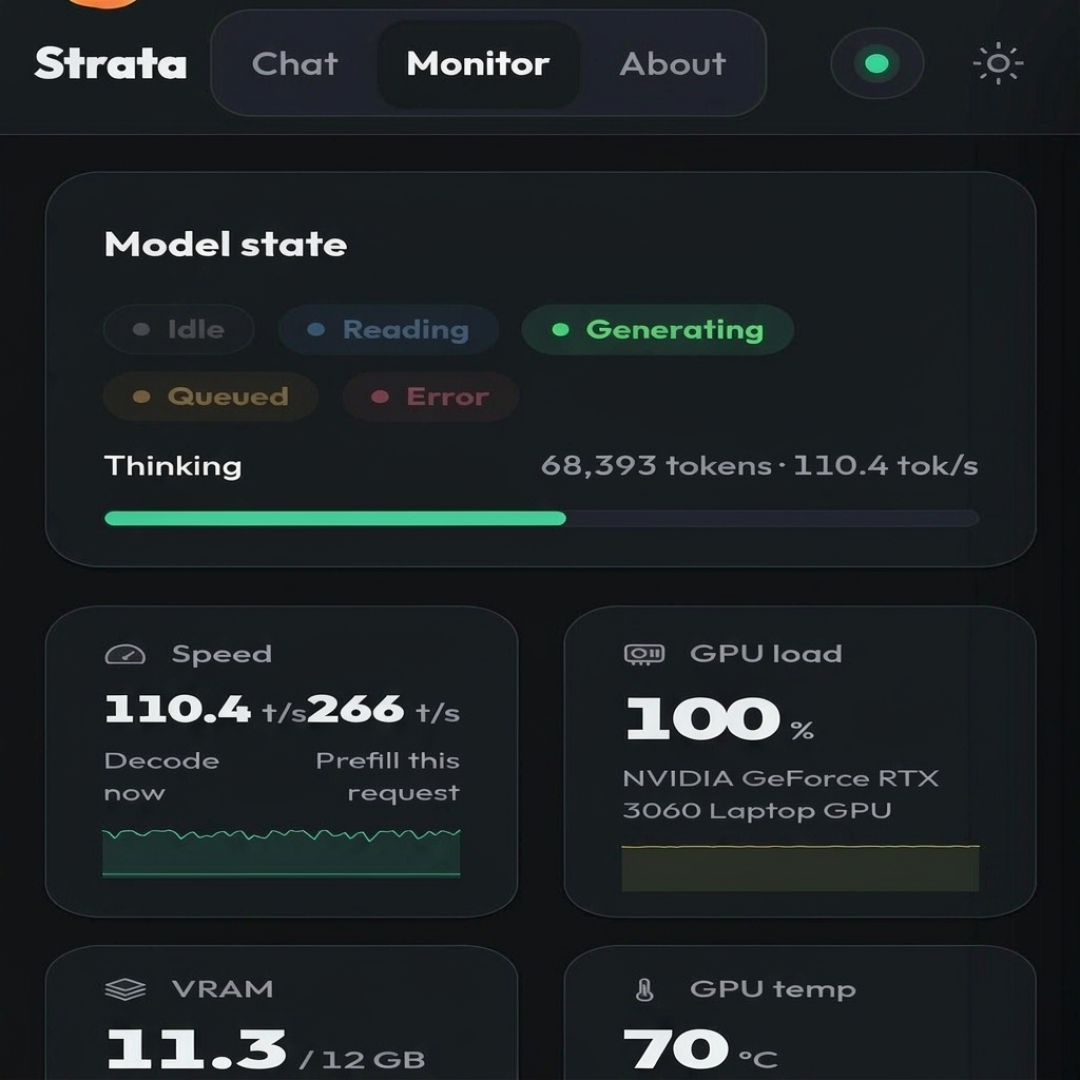
知乎用户yy shi晒出一台2000元出头的X99平台:E5处理器、笔记本版3060加128GB DDR3,用Strata跑iq3_s量化,预填充最高700,输出平均55到65。读能到700,写只有55,同一台机器上差出十倍。原因不复杂:读输入可以整段并行处理,写输出只能逐字生成,每出一个字都要把模型参数重新读一遍。所以你贴进去的内容要全部被读完,第一个字才会出现,文档越长等得越久,这时候输出tok/s再漂亮也用不上。知乎
速度数字多半带着没写出来的前提
就算只看输出速度,它也是建立在机器空闲上的。知乎用户郑世录在64GB内存、16GB显存的机器上实测:71.5GB的IQ3_XXS能跑到45–50 tok/s,换成84.3GB的IQ3_S,加载完只剩4.4GB余量,开几个浏览器标签就开始换页,速度从40 tok/s掉到个位数。他自己的总结是写得长就是慢:一次输出1794个token的任务,花了317秒。知乎
还有一些数字干脆不带前提。小红书用户俺老孙来Yeah花11999元攒了4张V100,自报跑Qwen3.8-27B到211 token/s、上下文262k,噪音55分贝。评论区马上有人追问“长上下文不降速度么”,也有人问多少bit、用的什么上下文——这些条件,原帖的数字里都没有。B站一期多卡实测里,R9700四卡方案报出16并发解码达1750,多并发优势显著。但1750是16路合起来的数字,摊到每路只有一百出头。小红书哔哩哔哩
所以看评测、抄配置单之前,把“速度”拆开问三件事:贴你最常处理的长文档,第一个字要等多久;按你平时的上下文长度,单路输出实际跑多快;晒出的数字是在什么量化、多少并发、多大内存余量下测的。平时以短问答为主的人,评测里的tok/s有参考价值;天天贴长文档、扔整个代码库的人,等待主要发生在“读”的那一段,而那一段,多数晒出来的数字没有告诉你。