如果你这一个月刷到过"DeepSeek终于能看图了,多模态能力接近Opus-4.8,价格还和最便宜的Flash一样"这类说法,并且正打算把手里截图识别、图表读数这摊活儿切过去,建议先停一下。这个模型上线刚满一个月,官方口径、实测表现和价格规则里各有几个容易被标题带偏的点。我把知乎、微博上的公开信息翻了一遍,按能力、价格、接口三本账拆给你看。
第一本账:能力——"接近Opus-4.8"说的是哪一项
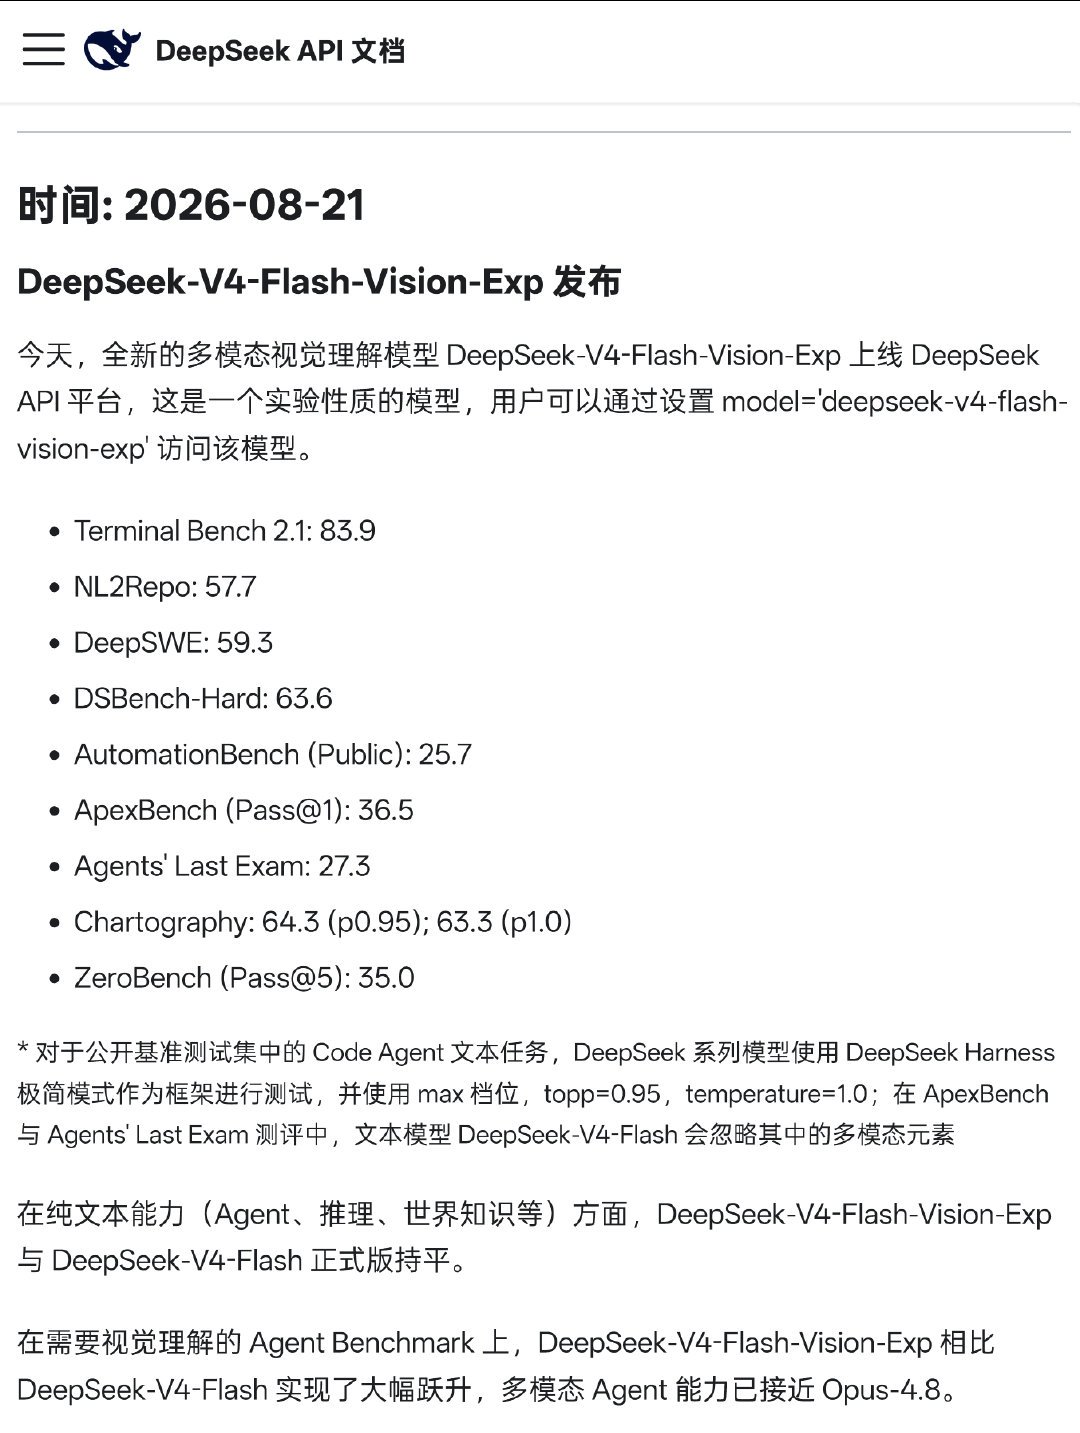
8月21日,DeepSeek在API平台上线了实验性质的多模态视觉理解模型,调用名 deepseek-v4-flash-vision-exp。 先明确两个定位:它只做"看图理解",不做图片生成。 "实验性质"意味着接口已经开放,但官方确认的能力和个人实测体验要分开看。微博知乎
官方解读给出的基准成绩是:Terminal Bench 2.1 为 83.9,Chartography 为 64.3,AutomationBench 为 25.7。 官方文档页同时还列出了 DeepSWE 59.3、Agents’ Last Exam 27.3、ZeroBench 35.0。在纯文本能力上,它与 DeepSeek-V4-Flash 正式版持平,微博上关注多模态的博主也确认"纯文本没缩水"。知乎
而"接近Opus-4.8"这句话,专指多模态Agent基准上的表现,不是"DeepSeek视觉综合能力约等于Opus-4.8"。 这两个说法的差别,决定了你该对它抱多大期待。知乎
实测端的信号比较克制。博主karminski-牙医用自己写的AI电竞教练框架测了它:让模型分析CS2录像、指出玩家的问题。一个关键限制浮出水面——它不支持视频输入,只能靠视频抽帧变通,同场对比的另一个模型也被迫用抽帧方式跑。 他还专门测了"最佳输入图片配比",说明一次喂多少张图、怎么喂,效果差异不小。另一位博主用推特上流行的"半片青柠画人体姿势"case测了它的图像理解。 这类测试拼出来的共识大概是:识图是及格了,但离"看懂之后可靠地做事"还有距离。微博微博
第二本账:价格——一个月内调了两次,图片按token计费
DeepSeek的计费规则这一个月变动很频繁:8月17日起取消统一计费,改成峰谷定价,高峰时段价格是空闲时段的两倍。 9月10日12:00起Flash系列再次调价,除输出外回归8月17日之前的价格,这次调价覆盖的模型里明确包括 deepseek-v4-flash-vision-exp。 也就是说,视觉版的价格跟着Flash系列一起坐了一个月的"过山车"。知乎知乎
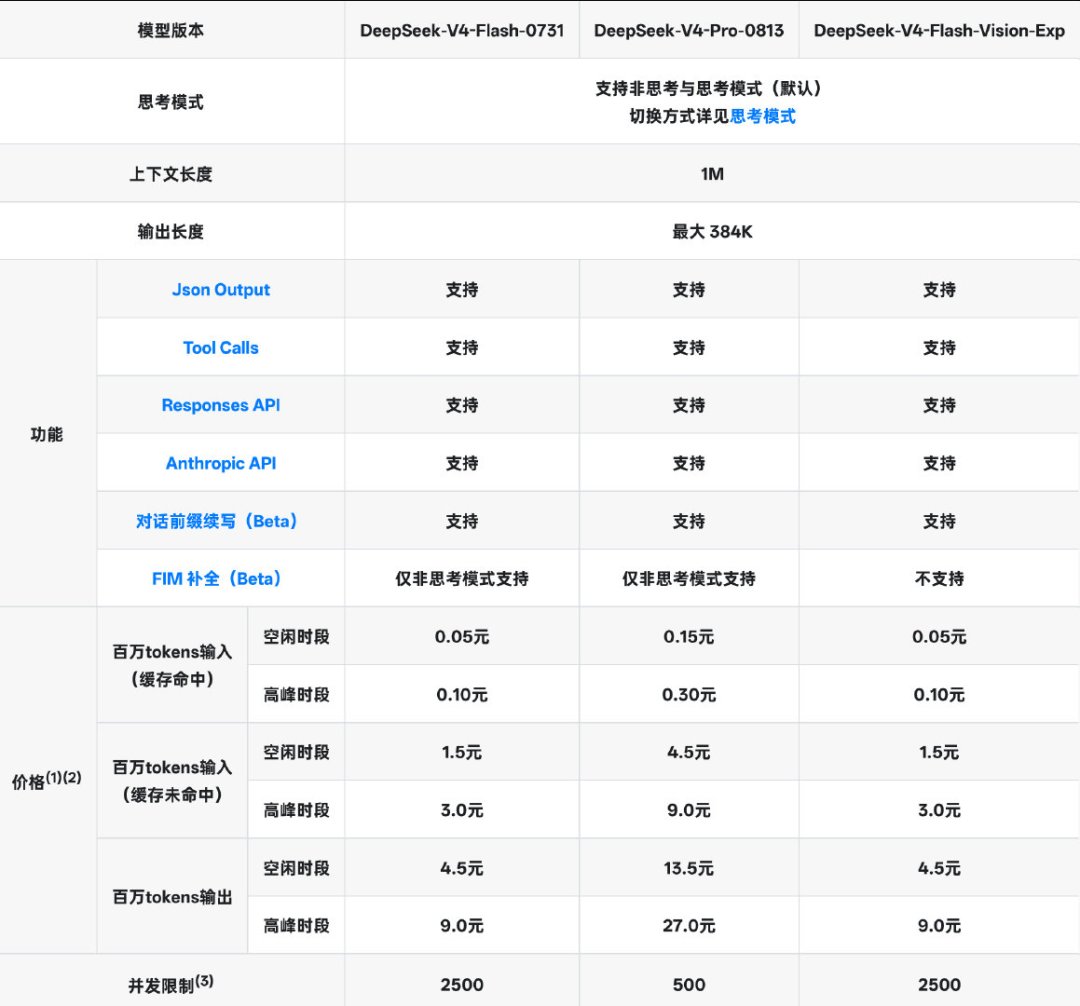
价位上,V4 Flash档输出价大约在每百万tokens 4.5~9元之间浮动,看时段和缓存。真正的大头在缓存:命中0.05元、未命中1.5元,差30倍。 把不变的system prompt和长文档固定放在请求最前面,比纠结选哪个模型更能省钱。知乎
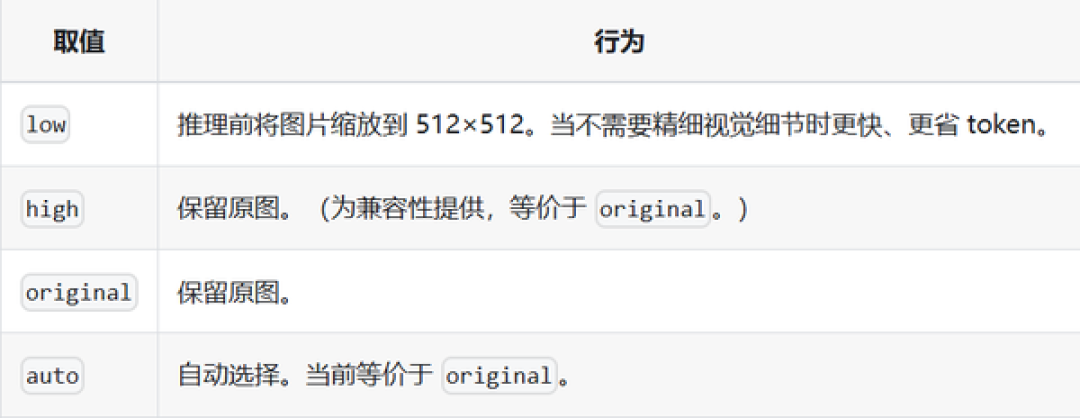
视觉任务还有一个容易被忽略的成本点:图片不是免费的,会按尺寸换算成token,和文本一起计费。 官方接口的detail参数有 low、high、original、auto 四档——low会在推理前把图片缩到512x512、最省token,original保留原图精度。只是想知道"这张图里有什么",low够用;要读截图小字、表格数字,才需要保留原图。但注意,大图被缩小后小字更难识别,成本和效果不是"图越大越好"的单向关系。多模态任务的token大头往往在图不在文,切流水线前最好先拿自己的真实图片跑一次账单。知乎
第三本账:接口——三种传图方式和几个会返回400的坑
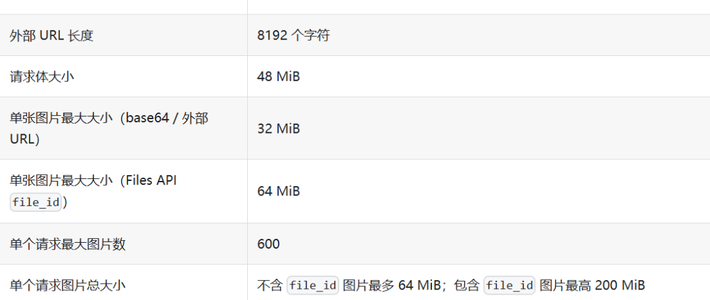
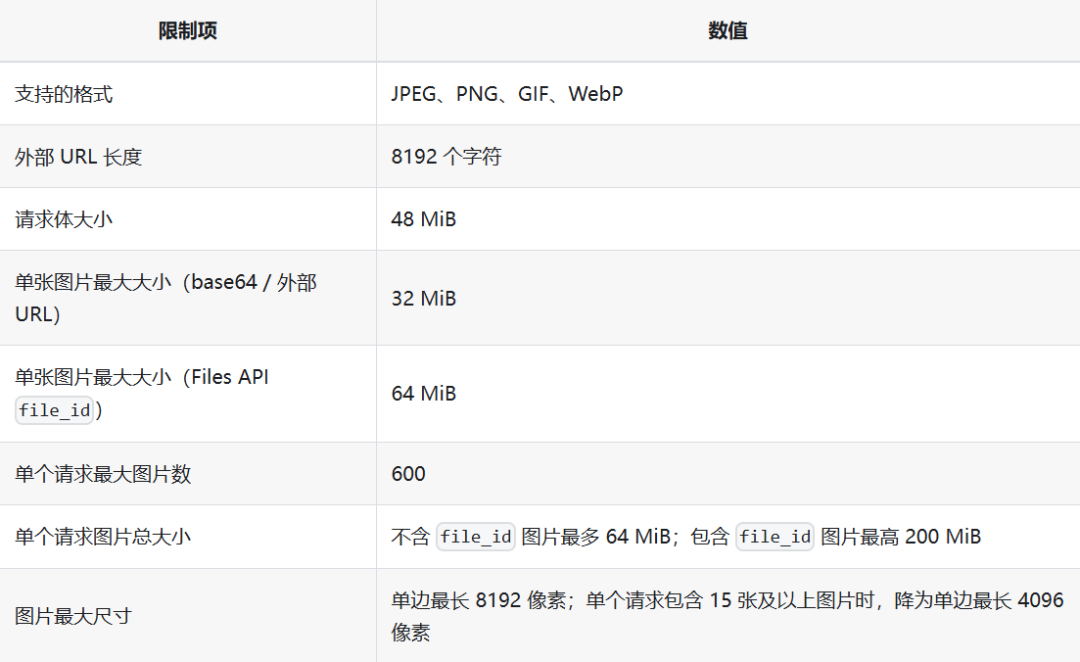
传图有三种方式,适用场景不同:本地图片转Base64嵌入请求,写脚本快,但受请求体大小限制;传公网URL,DeepSeek服务器自动下载,但URL最长8192个字符、单图最大32MiB、下载必须在60秒内完成。 走Files API先上传再引用file_id,同一张图要反复分析或图片太大时更合适,单张上限64MiB。从官方文档的限制表看,图片格式支持JPEG、PNG、GIF、WebP,单个请求最多能带600张图,单边最长8192像素,超过15张图时会收紧到4096像素。知乎
几个实测会踩的坑:图片只能放在user消息里,放进system或assistant消息直接返回400。 文件格式按实际内容判断,把PNG改名成.jpg没有用;它不支持视频输入,视频任务要自己抽帧。好消息是接口兼容OpenAI对话格式,DeepSeek还提供Anthropic兼容端点,从Claude迁移的团队改个base_url就能跑。知乎知乎
9月的新变量:V4.1 Flash来了,视觉版还停在实验档
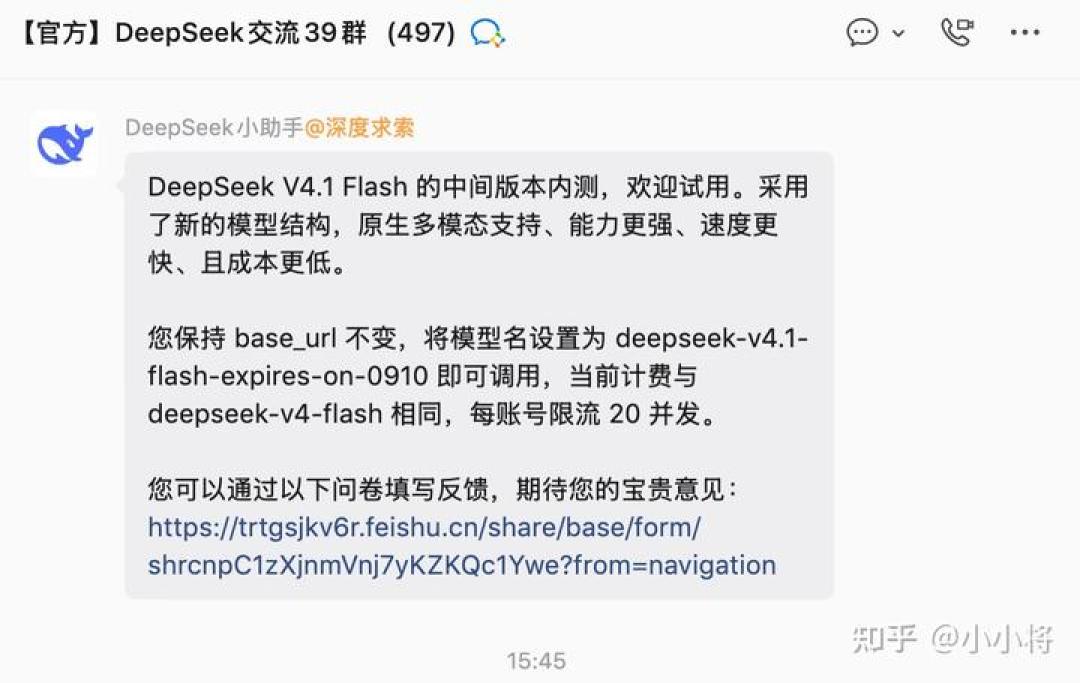
9月10日,DeepSeek又发布了V4.1 Flash,知乎上有用户实测其输入缓存命中率约为99.23%。 第三方聚合平台甚至打出了五折。 值得注意的一条线索是:流传出的内测公告截图显示,V4.1 Flash的新模型结构将"支持原生多模态"、base_url不变、内测期计费与v4-flash相同、每账号限流20并发——如果落地,视觉能力下一步可能直接并入主线模型,而不是继续挂在exp分支上。知乎知乎
另外V4.1 Flash上线后,知乎出现了"输出大量Hmm"的讨论,用户的判断是更像推理链或思考标记漏进了输出。 这提醒你,连正式版都可能带bug上线,实验版更要谨慎。知乎
所以谁该现在切,谁该再等等
分三档说:
想做多模态Agent、截图分析、图表读数的个人开发者:可以现在就试。接口是标准OpenAI兼容格式,价格在Flash档,试错成本低。
有视频理解需求的:不行,得自己抽帧或者看别家。
打算接生产环境的:建议再等等。实验版标签、一个月两次调价、Hmm bug前科,三件事叠加,至少先小流量灰度。
后续值得盯三个信号:V4.1系的"原生多模态"什么时候正式开放、vision-exp会不会转正、以及Hmm这类输出bug的修复节奏。对完这三本账再动手,比看着"接近Opus-4.8"的标题就切流水线,稳得多。