这周装机圈的信息流被一条"黑科技"刷屏了。9月21日快科技报道,AMD公布了一项叫"四面体笼子"(Tetrahedral Cage)的光线追踪研究成果:在自家Radeon RX 9070 XT上实测,大规模动画场景的光追加速结构显存占用从约80GB压到1.7GB,缩减97.8%,折算下来就是标题里那个"暴降47倍"。一周之内,B站冒出好几条"80G砍到1.7G"的视频,知乎相关问题被顶上硬件区,微博聚合号整齐划一地打出"只需2G显存等效80G"——一副"从此A卡玩家不用再焦虑显存"的阵势。快科技
但恰好是这条传播最广的结论,错得最离谱。先把机理账对完,你才知道该不该为它改自己的装机计划。
机理账:它砍的不是你爆的那块显存
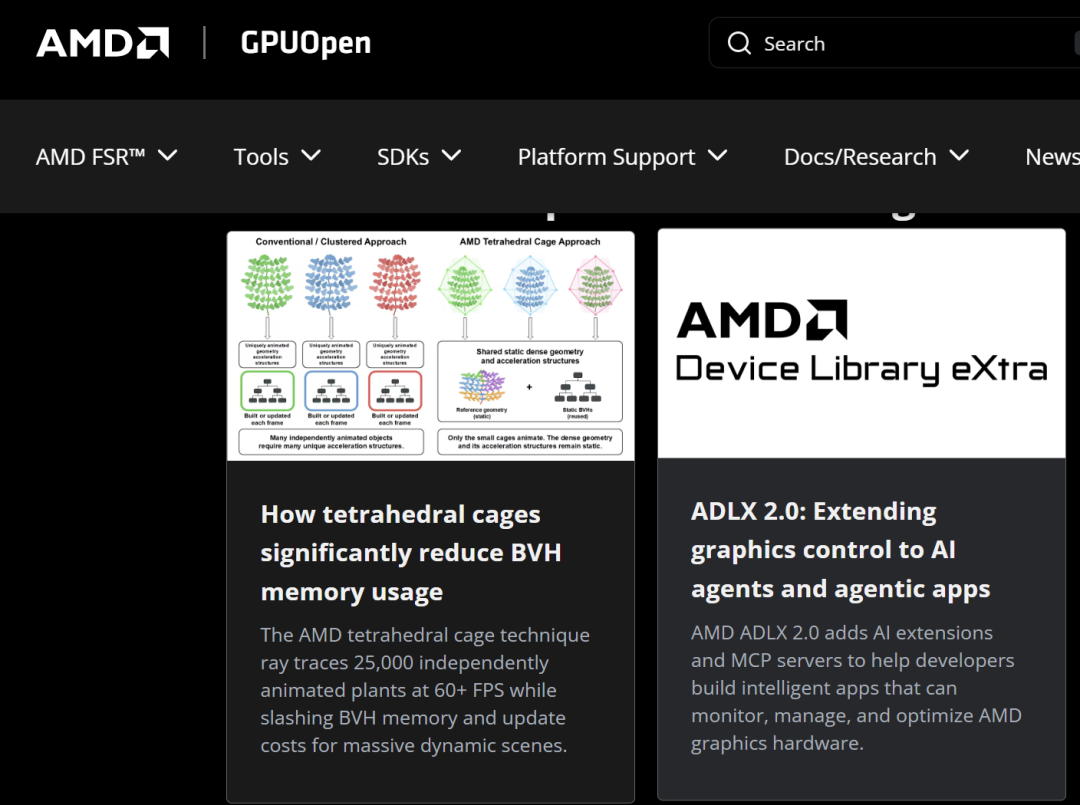
先说清楚80GB→1.7GB到底省在哪。AMD放出的参考文件里写得直白:关键结果不是三角形数量,而是加速结构存储和BVH更新成本的下降——同一动画场景,换成四面体笼子,BVH内存约1.7GB,每帧全部更新约3.3ms;用传统密集三角形BLAS对象逐帧更新,显存需求高达80GB,每帧更新耗时超过300ms。知乎

传统光追实现里,每个会动的物体(角色蒙皮、布料、形变)每帧都产生一套独一无二的顶点位置,GPU就得为这套几何重新生成、重新存储一份加速结构(BVH)。东西越动,结构越重建,显存和帧时间双爆炸。四面体笼子的思路是动静分离:给致密网格罩一个小的可变形四面体笼,跑起来只有笼子跟着变形,里面的致密几何和它的BVH结构保持静态、可重复使用,光线在相交测试前被变换回静态参考系。动画成本从此只随笼子复杂度增长,不再随三角形数量增长。代价也写在明面上:失去逐顶点的动画控制精度,对蒙皮变形要求极高的场景不适用。快科技
看懂这段,就能拆穿"从此不爆显存"的误读:你游戏里爆的那块显存,主力是高清材质、帧缓冲、UI和后台驻留——跟动画BVH根本不是一个科目。A卡玩家社区今年吵得最凶的"三角洲行动爆显存掉帧"那批帖子和攻略视频,根源在材质负载和驱动层,四面体笼子一条都救不到。而且"80GB"是大规模动画场景的理论上限工况,市面游戏实时光追的BVH占用,本来就远够不到16GB显卡的上限。

场景账:真正受益的是谁,社区为什么一半 hype 一半骂
这项技术真正的目标场景,是逐帧大形变几何叠加实时光追:人海级NPC动画、物理驱动的布料毛发、影视级动态场景。在这类场景里,"300ms→3.3ms每帧"的更新成本下降比省显存更致命——它决定的是动态光追能不能从演示demo变成可玩的帧预算。
社区的态度也值得对一对。转发侧是玩梗:“黄皮衣肝胆俱裂”“2G等效80G”;B站热评的另一侧则是老A粉的肌肉记忆——“继续画饼,还不如先把帧生成搞实在”“依旧占未来,依旧无未来”,还有人直言"AMD要跟的东西太多了,鬼知道要几代产品才能稳定"。两边都没说错,但都对了一半:技术本身是真论文、真9070XT实测,不是PPT;可AMD目前只计划提供C++库和DXR接口示例,没有任何游戏落地时间表。"有潜力"和"能买到"之间,隔着一整条生态适配的路。哔哩哔哩知乎
时间账:它和英伟达、和RDNA5放在一起才看得清
把它塞进这两年的路线分歧里,信息量更大。英伟达路径是把光追往神经渲染推——DLSS5那波,社区上周还在折腾强开进A卡的教程;AMD这次反过来证明:传统RT管线里被默认为"物理税"的BVH重建开销,可以用算法砍掉一个数量级,而且是在RDNA4现有硬件上实测的。对存量9070系用户,"不依赖新硬件专属单元"是这项研究最实际的想象空间——理论上走驱动和API层就能吃到。
但同一批人的日历上还有另一行字:RDNA5目前只剩一张代号AT2的料,其余档期被爆料推到2028年。社区又在传什么"10080XT上48G显存"。硬件堆容量和算法提效率,这两条线互相拉扯,说明AMD内部对下一代显存策略本身都还没收敛。证据覆盖到这里,结论就只能说到这里:这是一项值得跟进的研究,不是一个可以排进双十一购物清单的卖点。知乎哔哩哔哩
三本账合上:四类人各拿各的结论
已经持有9070系、正在被爆显存折磨的:先查材质档位、驱动版本和后台占用,这条技术路线与你眼下的掉帧无关,别把它当免费补丁等。
纠结12G还是16G的:别让"47倍"改写你的答案。你的决策函数仍然是材质负载和游戏清单,该买16G还是买16G。
想为它当等等党的:不要为这项研究等卡。真要等,等的是它从C++库/DXR示例走进驱动栈和UE工具链的那一天——在那之前,它改变不了任何一张卡的售价和帧数。
光追路线图观察者:它与下一代Xbox同源,这项笼子技术是否进入后续GPU的RT单元设计,才是判断AMD光追走向的硬信号。知乎
继续盯三个信号就够了:AMD官网是否放出那个C++库和DXR接口示例;UE/微软方面是否有开发者跟进适配;RDNA5的下次曝料里,RT部分的说法有没有从"堆单元"转向"吃算法"。三个里出现任何一个,这篇的技术账才需要重算。至于现在——先把"2G等效80G"的表情包从你的装机决策里删掉,这事就讲完了。