








11
15
我用AI做了条30秒短片,全程只说了3句话
2026-10-07 20:40:17
0点赞
0收藏
1评论
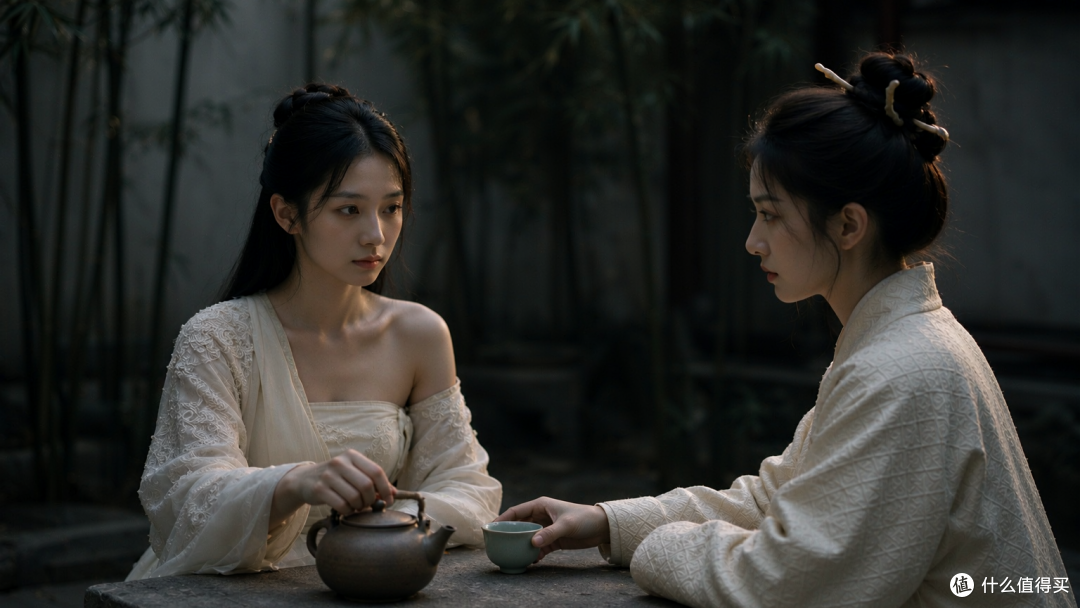
一条 30 秒、1920×1080、真人实拍质感的短片:两个汉代女子,一场暮色庭院里的茶局。
演员、摄影、灯光、剪辑,全是 AI 做的。我没拍一个镜头,也没开过剪辑软件。
整个过程我只交代了三件事:出主角、写剧本、生成视频。这篇就讲这三句话该怎么说。
① 图生主角:「这几张图,帮我做成角色设定图」
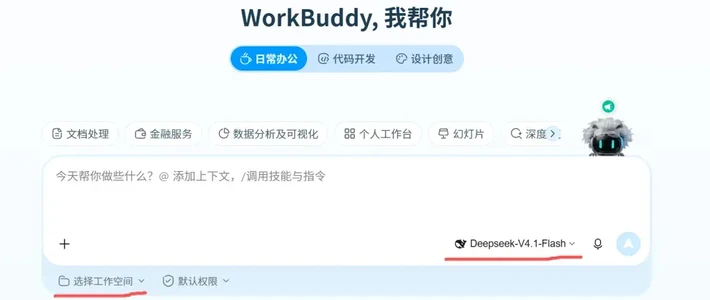
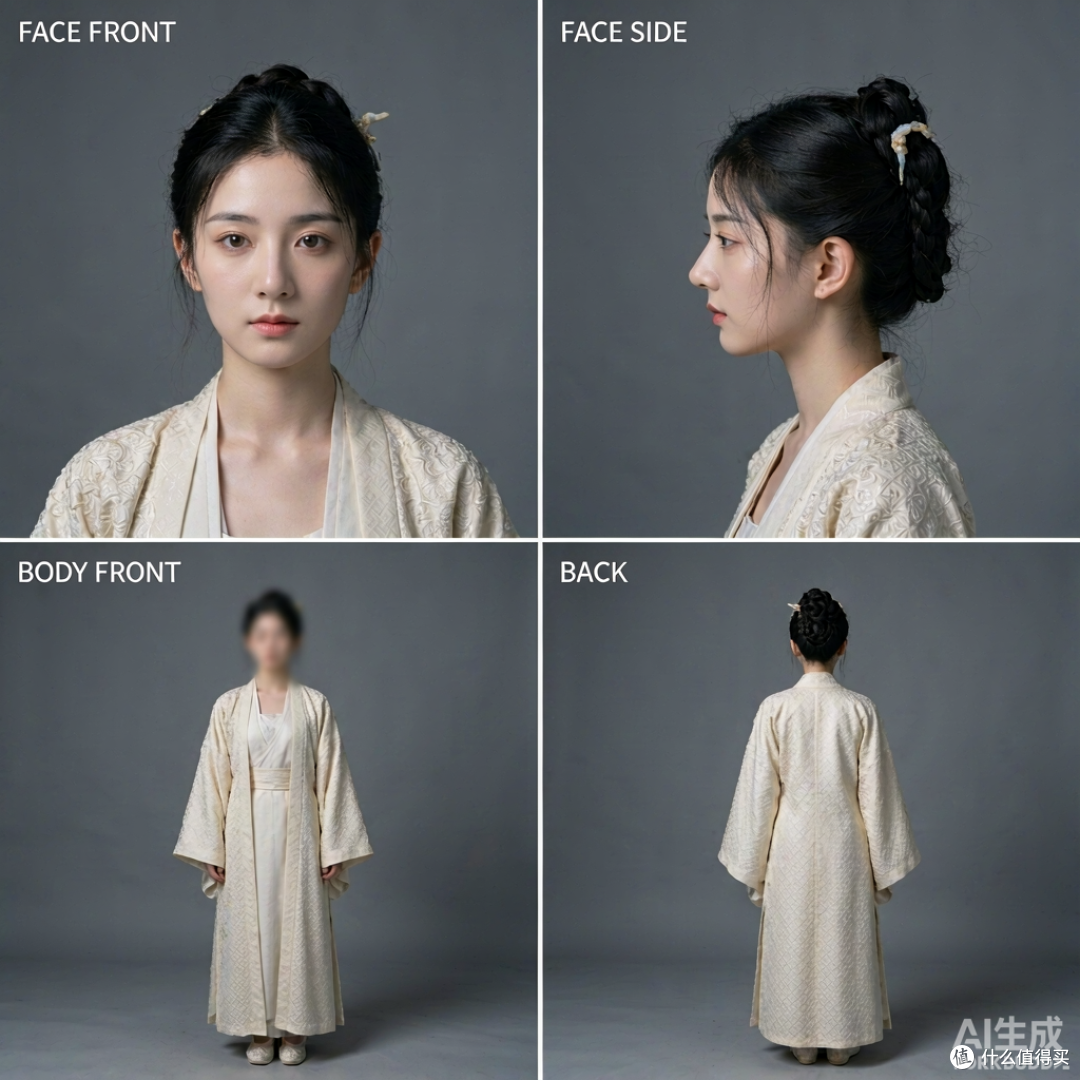
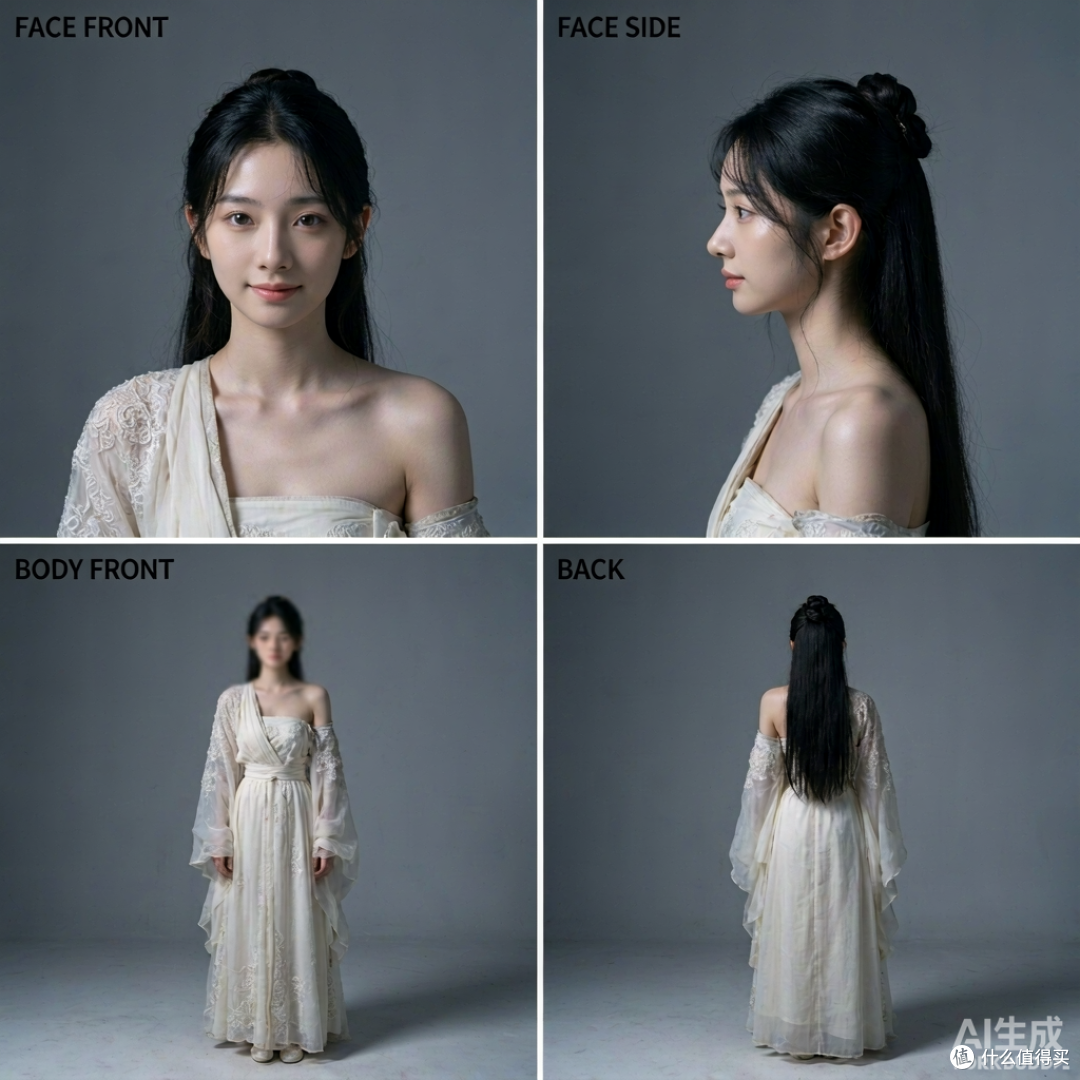
我网上找了一张图,截图了2个人物过去,让智能体生成四宫格人物图。
它自己补的:判断出三人同框会让模型把两张脸"平均"成第三个人,于是先自动裁出两位女子的单人图,再分别生成四面板设定图——正面脸、侧面脸、正面全身、背面全身。这是后面所有镜头里"同一张脸"能保持一致的基础。
技巧:给原始素材 + 一句意图。剩下的拆解,交给它。
② 写剧本:「正常一段文戏」
就这六个字。它自己排出了:18 个镜头,每镜标好景别和运镜;一条张力曲线——缓、紧、顶点、软、落定;一条道具状态链——执壶、放壶、推盏、喝尽、反扣空盏、起身;每镜的设计理由,还引了两部电影当参考。
技巧:一句话 + 一个方向就够,但一定要说清“按电影的方式”。你说“随便拍拍”,出来的就是随便拍拍。
03 生成视频:「生成并合并」
就这四个字。它自己补的:判断 18 个镜头塞进一次生成会被模型简化,于是拆成 3 段 × 10 秒;自己为每段生成一张“首帧”锁定画面;自己把三段无损拼接;拼完自己抽帧逐秒检查,把偏差列成表告诉我。
技巧:把决策权和兜底方案一起给它。我的原话是“能一次生成最好,不行就多段后合并”。
做 AI 视频无非这几种路径:文生图出画面、图生视频让图片动起来、文生视频直接出片、视频生视频做参考延展。想最快出片,直接用 Seedance 2.5 文生一条 30 秒就够了。
但无论走哪条路,第一步都值得先把角色确定下来、锁死。因为模型每次生成都是重新抽卡,同一句描述换一镜,就可能换一张脸。先有角色设定图,后面每一镜才能是同一张脸。
这篇也是学习加试验的记录:场景我没有自己生成,全交给智能体直接出,边学边试。
以前也做了很多视频,简直不能看,这个学会了后期慢慢的图用MJ,视频Seedance 2.5的话效果会更加好,我这边只不过直接用智能体生成的,全是免费的。
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~









校验提示文案
校验提示文案