








 深耕数码、汽车兴趣领域




12
8
长江存储PE511评测:12.8TB的企业级粮仓,并发不怕卡顿
2026-09-20 10:16:47
1点赞
1收藏
0评论
企业选SSD时,容量之外还要看业务怎么运行。在线交易、实时推理对响应时间比较敏感,数据库和虚拟化集群则经常有大量请求同时到来,这时就需要把IOPS、延迟和QoS放在一起看。平均延迟低,不代表每个请求都能很快完成。少量请求如果等得太久,也会影响业务响应,这就要看QoS了。云计算、大数据分析中的读写任务往往是混在一起的,运行时间也长。除了速度,耐久、可靠性还有掉电保护这些也得看,企业盘毕竟不是只跑个测速就完事了。
 image1.jpg
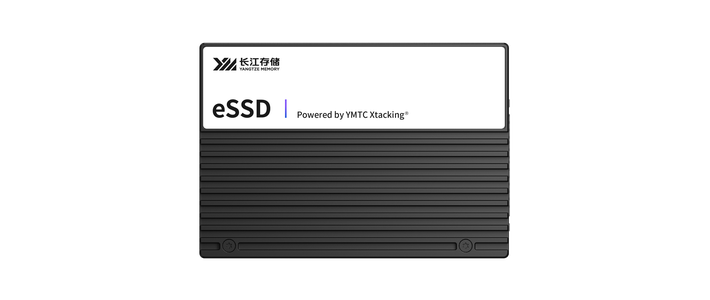
PE511使用的是长江存储晶栈®Xtacking®4.0技术打造的X4-9070三维TLC闪存芯片。产品分为读取密集型和读写混合型,耐久规格分别为1DWPD、3DWPD,我们收到的12.8TB版本属于后者,更适合数据库、在线交易、虚拟化这类写入任务较多的用途。
 image2.jpg
也许有人会问,QLC密度更高、单TB成本更低,企业盘为啥还要用TLC?选择TLC,与这些用途有关。QLC可以在同样的空间里提供更大容量,单位容量成本也更有优势,对于以读取为主的部署,有利于控制每TB功耗和总体拥有成本。PE511要应对的,正是持续写入、读写频繁交替的业务。放在这类负载里,TLC在耐久和延迟上的优势就比较实在了。官方给出的闪存耐久为12000次擦写。整盘有1DWPD和3DWPD两个版本,一个偏读取密集型,一个面向读写混合负载。这款TLC闪存标称支持12000次擦写。PE511的读写混合型则给到了3DWPD,是读取密集型版本的3倍。每天持续写入,耐久余量自然要留足。随机I/O和延迟当然要看,数据保护也不能忽略。企业盘一装进服务器,往往就是长时间连续运行。
 image3.jpg
我们收到的12.8TB版本,标称顺序读写分别为14000MB/s、10000MB/s。4K随机读取达到320万IOPS,写入为90万IOPS,后面的实测就以这组参数作为参考。PCIe 5.0提供的带宽空间,能否在不同访问方式下充分用起来,是后面实测的一个重点。另外,官方给出的4K随机读取延迟低至55μs,写入低至8μs,也专门标出了99.99%分位的QoS表现。延迟这部分,我们会在实测中展开,平均值和较慢请求的分布都看一看。
 image4.jpg
PE511的MTBF标称为250万小时,盘级和主控级均通过了安全认证。它还支持AES-256 XTS静态数据加密、增强掉电保护和安全擦除。日常存储、意外断电,直到退役前清理数据,都有相应的保护功能。
性能实测
说了这么多企业对SSD性能需求以及长江存储PE511特性,也该上硬货了——性能实测。
 image5.jpg
测试基于PC平台进行测试,使用Intel Core i9-13900K处理器以及ASUS ROG Maximµs Z790 Hero,PCIe 5.0 M.2接口是通过转接卡从PCIe X16插槽中转出来的,再通过转接卡连接到PE511的U.2接口上。考虑到这次有不少长时间读写项目,这次长时间读写项目不少,所以PE511测试时一直放在机箱风扇附近,直接用风扇送风。Ubuntu 26.04下的高并发随机I/O测试,最初出现了周期性波动。后来排查下来,问题出在这套平台默认的NVMe中断聚合设置上。正式测试前,我们先关闭了相应的中断聚合。处理方式是通过NVMe Set Features,把Interrupt Vector Configuration里各I/O队列中断向量的Coalescing Disable设为1,尽量不让中断聚合干扰持续性能。
CrystalDiskMark
 image6.jpg
第一个测试SSD跑分标配的CrystalDiskMark,用于测试SSD最大读写速度。实测PE511顺序读取速度为13877.22MB/s,顺序写入速度为10088.39MB/s,前者很接近官方标称值,后者则是高于官方标称值。CrystalDiskMark的4K随机读写成绩分别为2263620IOPS和1297735IOPS。
TxBENCH
 image7.jpg
TxBENCH的顺序读取跑到了13063.79MB/s,写入为9391.87MB/s,使用128K Q32T1设置。4K Q32T1下,随机读取测得509021IOPS,写入462380IOPS。
SPECworkstation 4 WPCstorage
 image8.jpg
不同专业软件访问硬盘的方式并不一样,这次也加入了SPECworkstation4.0的Storage测试,里面有内容创作、工程设计、科学计算等负载。图里主要看SPEC Ratio,简单来说就是实测成绩和参考系统成绩的比值,数字越高,这一项的表现越好。
 image9.jpg
PE511在mcad、7zip和3dsmax三个子项中分别取得2.53、2.38和2.05,机械CAD、压缩工具、三维内容创作相关的存储负载表现比较突出。MayaVenice、namd和ccx也分别达到1.89、1.87和1.76,较好的成绩并不集中在单一类型的应用中。这里比较的是存储子测试,可用于工作站选盘参考,不能直接理解为整个应用获得了相同比例的加速。
ezFIO
ezFIO是基于fio自动执行测试的脚本工具,本次使用fio 3.41,测试范围基本覆盖整盘,约11921GiB。块大小、并发数量和读写比例都会跟着项目变化。4K随机读写这里有一点容易看混,每个线程实际上都是QD1,线程数往上加以后,总QD才跟着增加,图里的QD标的是总队列深度。
 image10.jpg
持续稳定性这项使用4K随机访问,70%读、30%写,256线程,每线程QD1。大多数时间都在170万IOPS上下,全程都非常稳定。平均1694327IOPS,变异系数1.30%。收尾时的成绩和刚开始差不多,稳态状态表现非常优秀。
 image11.jpg
同样是4K、70%读取和30%写入,总QD64时已经达到1000995IOPS,读写平均延迟分别为83.55μs和17.18μs。这个档位既有百万级处理量,响应也比较快。加到QD256,混合读写升至1698448IOPS,还有明显增长。对应的平均延迟也上去了,读取171.25μs,写入101.67μs。
 image12.jpg
 image13.jpg
纯4K随机读从单线程开始就是53.19μs,和官方55μs的标称值已经很接近。加到64线程,IOPS超过100万,平均延迟还没到60μs。256线程时成绩来到2918006IOPS,延迟87.32μs。一路把并发往上推,IOPS还在涨,延迟则一直压在100μs以内。
 image14.jpg
前面这组线程配置还没碰到官方标称的随机读取性能,所以又补了几组,把线程数和每线程QD一起调整,每组大约跑120秒。几组结果都在344.3万到345.8万IOPS之间,最高出现在64线程、每线程QD32,也就是总QD2048。这个成绩比12.8TB版本标称的320万IOPS高了约8.1%。
 image15.jpg
 image16.jpg
随机写入更早进入性能平台期,总QD32附近就已经达到百万IOPS,此后继续增加并发,成绩变化不大,最高为1008970IOPS,超过官方90万IOPS约12.1%。QD1写入响应也很快,实测平均延迟8.44μs,和官方8μs基本贴着。写入曲线在总QD32附近已经趋于平坦,再增加并发,成绩也没有多少变化。到这个档位,延迟还不算高,吞吐已经基本摸到这一项的上限了。
 image17.jpg
 image18.jpg
数据块增大后,随机读取带宽上升很快,8KiB就达到13639.05MiB/s。32KiB至128KiB之间变化不大,基本都在13800MiB/s左右。随机读取这里用的是16线程、每线程QD16,总QD256。顺序读取则是单线程QD256,128KiB下跑到13806.26MiB/s。换成厂商常用的MB/s以后,大约是14477MB/s,基本到了标称水平。两种访问方式在较大数据块下,都取得了接近的高带宽成绩。
 image19.jpg
 image20.jpg
随机写入仍使用16线程、每线程QD16,4KiB带宽为3876.18MiB/s,增加到128KiB后为4278.57MiB/s,增长已经比较有限。单线程QD1顺序写入关注的是低并发下的表现:4KiB平均延迟8.41μs,128KiB带宽3563.91MiB/s,平均延迟34.92μs。此时QD只有1,单次请求写入的数据更多,带宽也就随之提高。
 image21.jpg
 image22.jpg
平均值之外,再看70%读取、30%写入时的延迟分布。QD1时看延迟分布,大约99%的读取请求都能落在61μs以内。到QD32以后,约99%的读取请求落在245μs以内,整条曲线也比QD1往右挪了一截。这时的混合读写成绩为604039IOPS,处理的请求也多了不少。并发上去以后,等待时间会变长,这很正常。不过大多数读取请求还是能比较快地返回。写入这边的曲线明显要靠左一些,QD1下大约99%的请求在11.5μs以内就能完成。到了QD32,也只需要32.1μs。越往尾部看,几条曲线的差距越明显。多数写入请求的耗时仍然很短,没有因为同时进行读取就普遍变慢。
VDBench
Vdbench的测试方法比较自由,块大小、读写比例、随机还是顺序访问,包括线程数,都可以自己设。也可以直接限制目标I/O速率,一档一档往上加压力,看吞吐和延迟会怎么变化。本次使用Curve方式,先测出各项目的最大IOPS,再按10%、25%、50%、70%、80%、90%、95%和100%设置请求强度,观察延迟怎样变化。这里的百分比是相对于该项目最大I/O速率而言,并非SSD利用率或队列深度。比如某个项目最高跑到329万IOPS,50%负载就是把目标速率设为约164.5万IOPS,90%则设为约296万IOPS。
 image23.jpg
 image24.jpg
4K随机读取的曲线比较平缓,从50%负载时的69.4μs,逐步增加到满负载时的154.6μs,没有明显突增。写入直到95%负载,平均延迟也只有53.0μs,80%时更低,为31.5μs。前面几个档位变化都不算大,直到最后的100%负载,延迟才明显跳到516.6μs。写入接近饱和后的排队影响在这里比较直观,而在95%及以下档位,响应仍然很快。
 image25.jpg
 image26.jpg
70:30混合读写下,4K在80%负载时是91.3μs,95%时130.1μs。8K会再高一点,分别是111.9μs和162.9μs。拉到100%以后,两组平均延迟仍没超过300μs,分别为277.4μs和249.8μs。放在混合读写负载里看,这样的响应表现还不错。
 image27.jpg
数据库混合v1项目从50%负载时的88.1μs,增加到90%时的149.7μs,95%仍不到200μs。最后一个满负载档位升至363.0μs,整个测试范围内都处于亚毫秒水平。
 image28.jpg
VDI混合v1跑满以后是550.0μs,前面几个负载档位则是一点点往上走。把六种负载横着看,90%和95%时平均延迟都还在200μs以内。已经比较接近各自的最大处理能力了,响应并没有突然恶化。
结语
晶栈®Xtacking®4.0到了企业级产品上,最后还是要看它能不能经得住这些实际负载。PE511在这次测试里没有出现明显的持续性能衰减,随机读取最高跑到约345.8万IOPS,长时间混合读写也维持得比较稳定。12.8TB容量、较高的并发性能,再加上3DWPD这样的耐久规格,放到数据库以及虚拟化存储里,都能找到直接的对应场景。
 image29.jpg
对长江存储来说,晶栈®Xtacking®4.0进入企业级SSD,也说明这套技术已经开始面对真正高强度的业务负载。高并发、长时间运行、大容量和高写入量,这些要求比消费级产品苛刻得多,PE511这次的实测表现也给出了比较有说服力的结果。随着数据中心继续扩张,存储的重要性只会越来越高,而PE511至少证明了一件事:在企业级SSD这个更看重长期稳定和综合能力的市场里,长江存储已经拿出了足够强大的产品。
作者:潇湘









