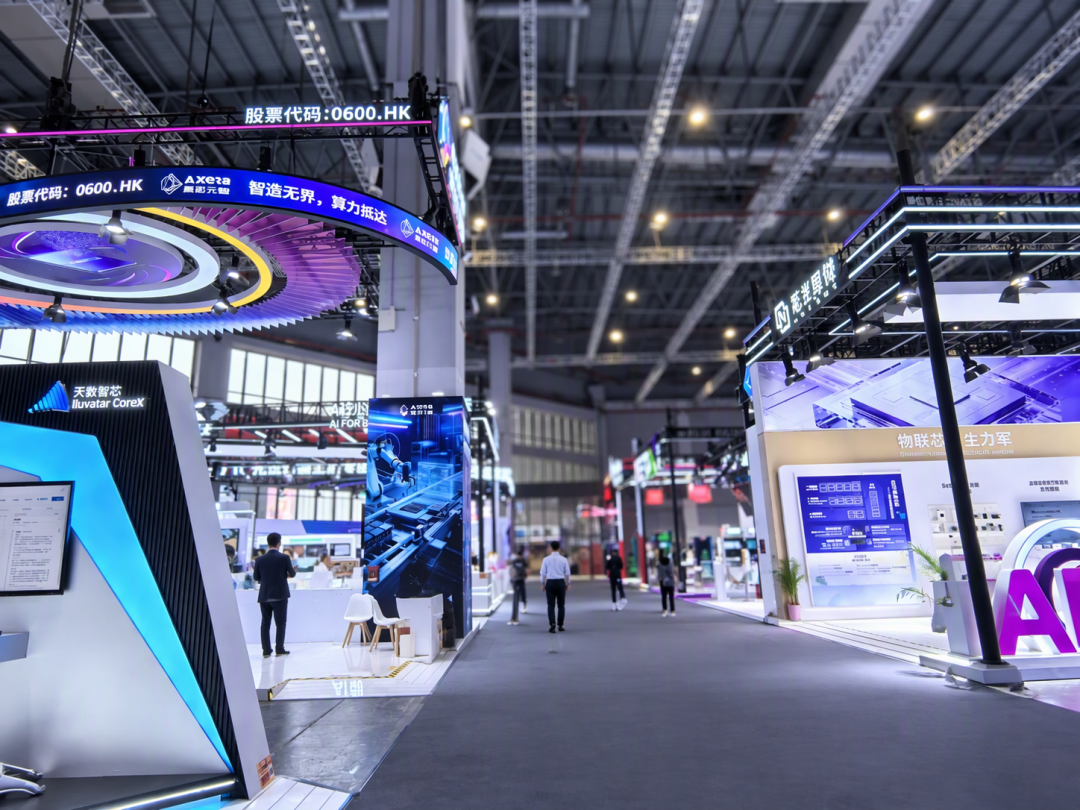
10月12日开幕的第26届中国国际工业博览会上,首次以独立专业展形式亮相的"国芯展"汇集300余家企业,而国产GPU厂商的展台不约而同在做同一件事:把更多的芯片连起来。沐曦摆出单柜64卡全互联的曦景S600,燧原展出云燧ESL64-O,天数智芯直接把144颗GPU塞进一台44U机柜。 如果你只看发布会通稿,会觉得这是一场"谁的柜子大"的内卷;但把各家的技术口径、模型侧的需求曲线和IDC的出货数据拼在一起看,会发现机柜里每张卡的去留,其实被一套相当硬的数学先定了一遍,剩下的空间才轮到生意决定。36氪
为什么卡数只能是144、64、16:并行划分的2的幂次逻辑
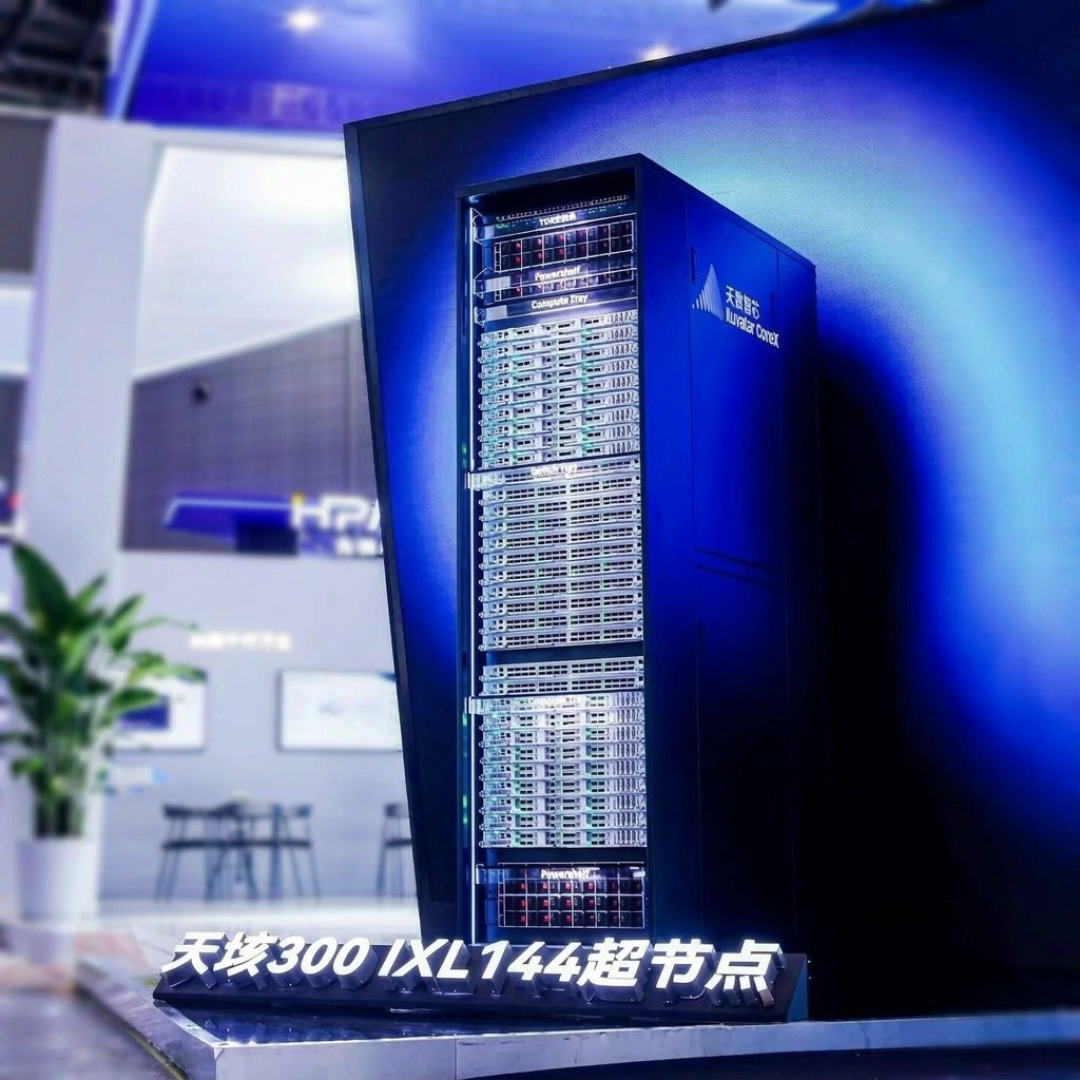
大模型的并行计算不是把一柜卡当一柜卡用,而是按张量并行(TP)、流水线并行(PP)、数据并行(DP)、专家并行(EP)把模型切开分给各卡。这套切分天然是2的幂次:64卡、128卡是常见计算规模。天数智芯在展台解释里说得很直白——如果128卡全部投入计算,一旦某个节点故障,整个训练任务都可能受影响;所以天垓300 IXL144选择128卡承担主计算、16卡提供冗余,把"算力利用"和"运行保障"分开记账。36氪
这就是那张最反常识的牌:单柜144卡,不是因为它需要比128卡更大的并行规模,而是因为它需要给128卡配一支替补队。
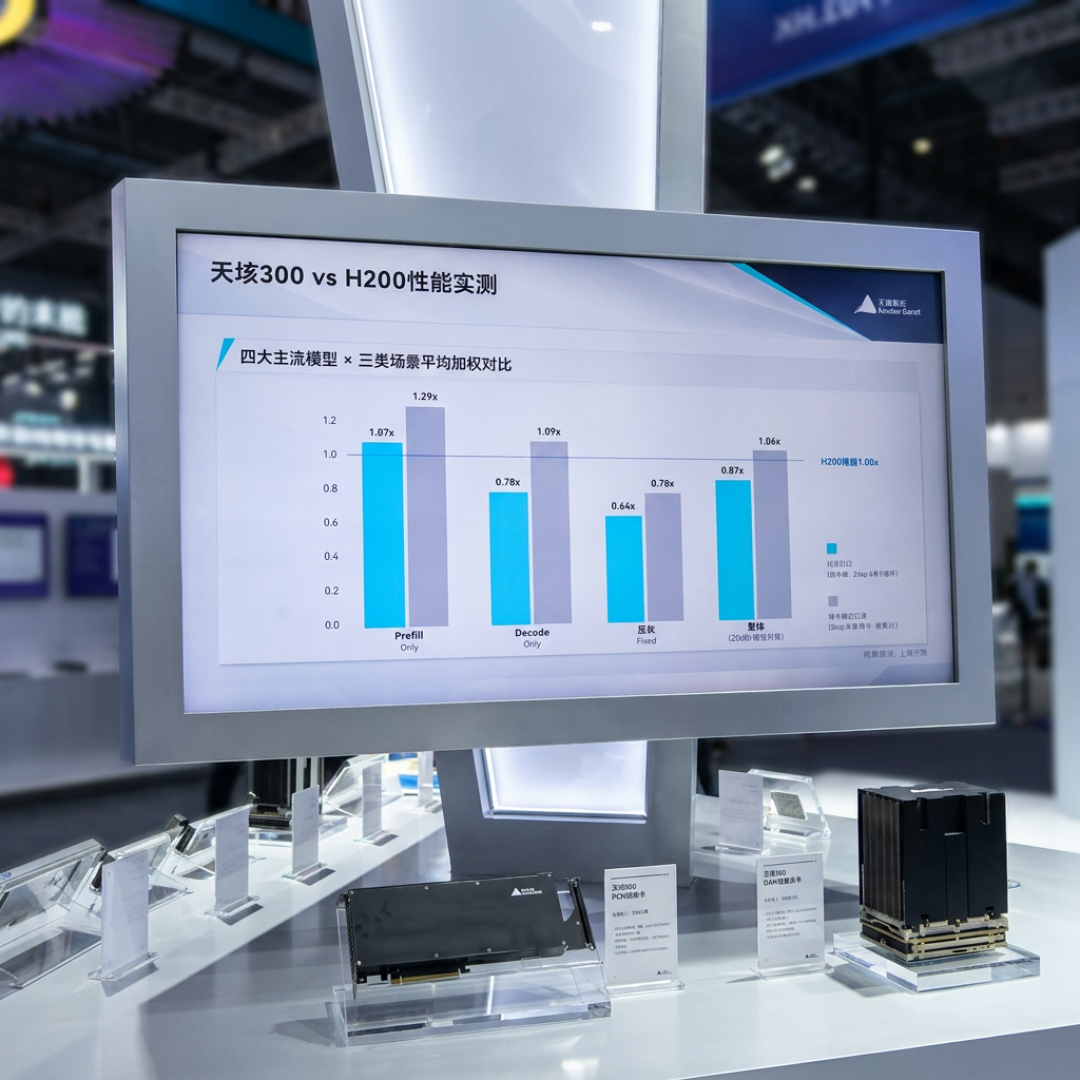
冗余只是显性的一半。另一半在通信。MoE架构训练和推理时,专家并行会触发大量的All-to-All通信——所有卡之间互相收发中间激活,谁快不重要,最慢的那条链路决定整体节奏。据天数智芯介绍,天垓300 IXL144单跳通信时延达到100纳秒级,在特定混合专家模型的All-to-All通信场景下有效带宽可提升15%。 15%听起来温和,但对一个动辄跑几周的千卡任务,通信占比每降一个点都是真金白银。36氪
顺带一提,同一道通信题在消费级显卡上也有自己的版本:10月4日知乎上的一篇论文解读把问题挑得很明——最新的消费级GPU(RTX 40/50系)既没有NVLink,驱动又禁用了PCIe P2P,任意两张卡之间的数据传输都必须经过CPU内存里的中转缓冲,每个字节要穿越PCIe两次。ThunderEP的做法,是把主机内存从"点对点中转站"升级成"共享广播介质",用三个改动把派发与回收两类通信分别加速到NCCL的2.00倍和1.53倍,端到端prefill最高提速1.66倍。 从百万卡超节点到12GB小卡跑MoE,"数据在路上浪费的时间"是同一个敌人,只是账单单位不同。知乎
10.1TB显存对着谁的需求:2.8万亿参数的Kimi K3和奔着10万亿去的Qwen4
为什么要在一个柜子里堆显存?时间线摆在旁边就清楚了:今年7月,月之暗面发布的Kimi K3总参数量已达2.8万亿。 9月云栖大会上,阿里披露下一代Qwen4正在训练,并把未来模型参数规模目标指向5万亿至10万亿。天数智芯说IXL144按128卡计算+16卡冗余整柜互联、总显存约10.1TB,正是为这种量级预留空间。36氪
这里容易被忽略的是推理侧的账。就算MoE每次只激活部分参数,庞大的模型权重仍要存储和调度;而上下文越长,KVCache吃掉的显存越凶——这也是为什么工博会现场会出现基流科技这样专门做超节点运维的新公司:其Galaxy自主算力系统通过多级KVCache管理、缓存感知路由和智能调度等技术,减少重复计算、降低推理延迟,并提高集群的有效吞吐量。 机柜的显存规模、卡间互联、调度软件,是一个闭环的三件套,单看任何一件都会误判。36氪
64、128、1024:四家公司用柜子的形状回答了"终局在哪"
都叫超节点,但各家对卡数的取舍暴露了完全不同的路线押注:
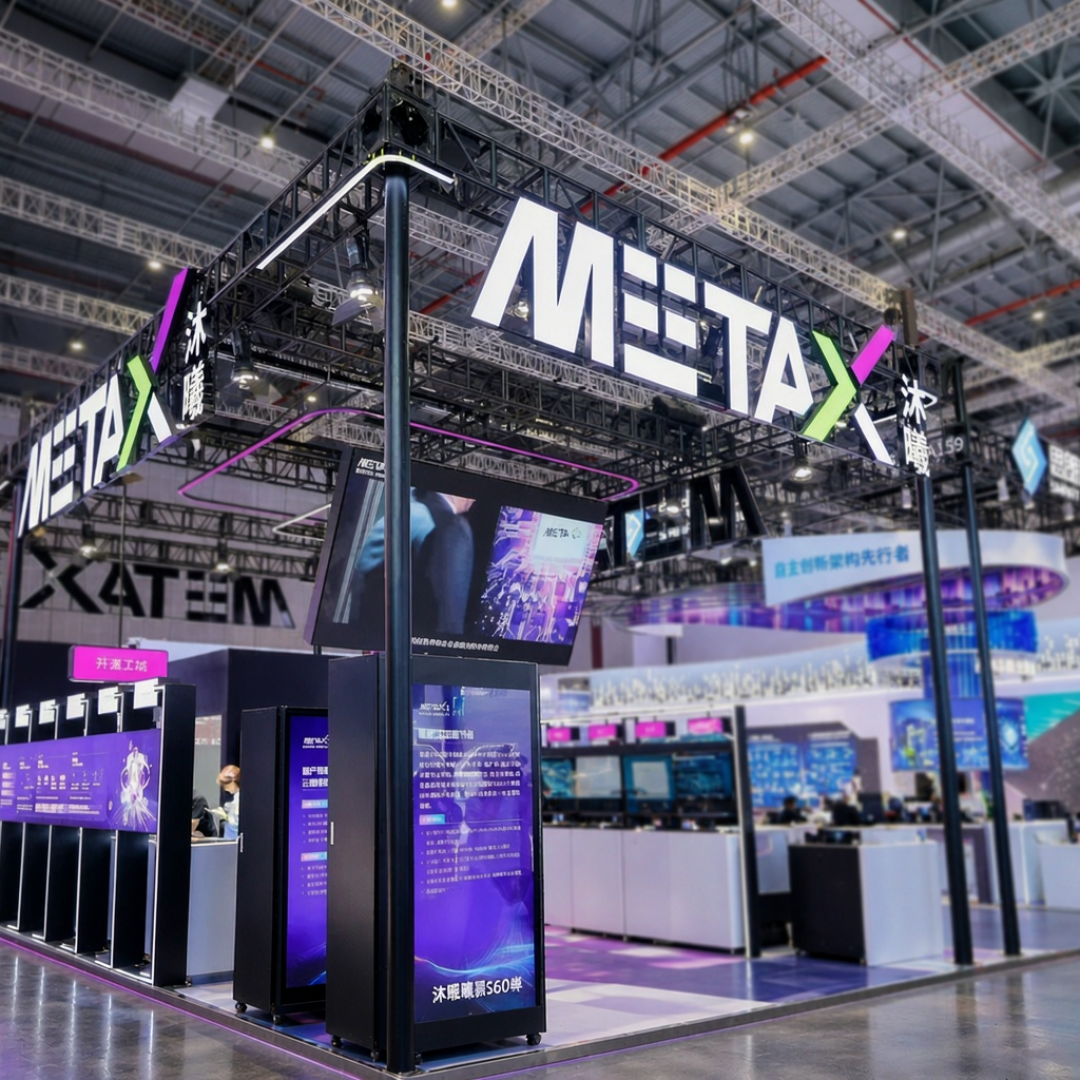
沐曦主推64卡全互联,通过正交连接器和交换结构减少传统机柜内部的线缆连接,又摆出曦景S600 Lite这种16卡方案——用同样的MetaXLink互连和零线缆架构,把体积压到接近传统8卡服务器。其联合创始人、CTO杨建此前曾表示,行业主流实用配置以32卡为主,但考虑到未来三四年的需求,64卡是必要的。36氪
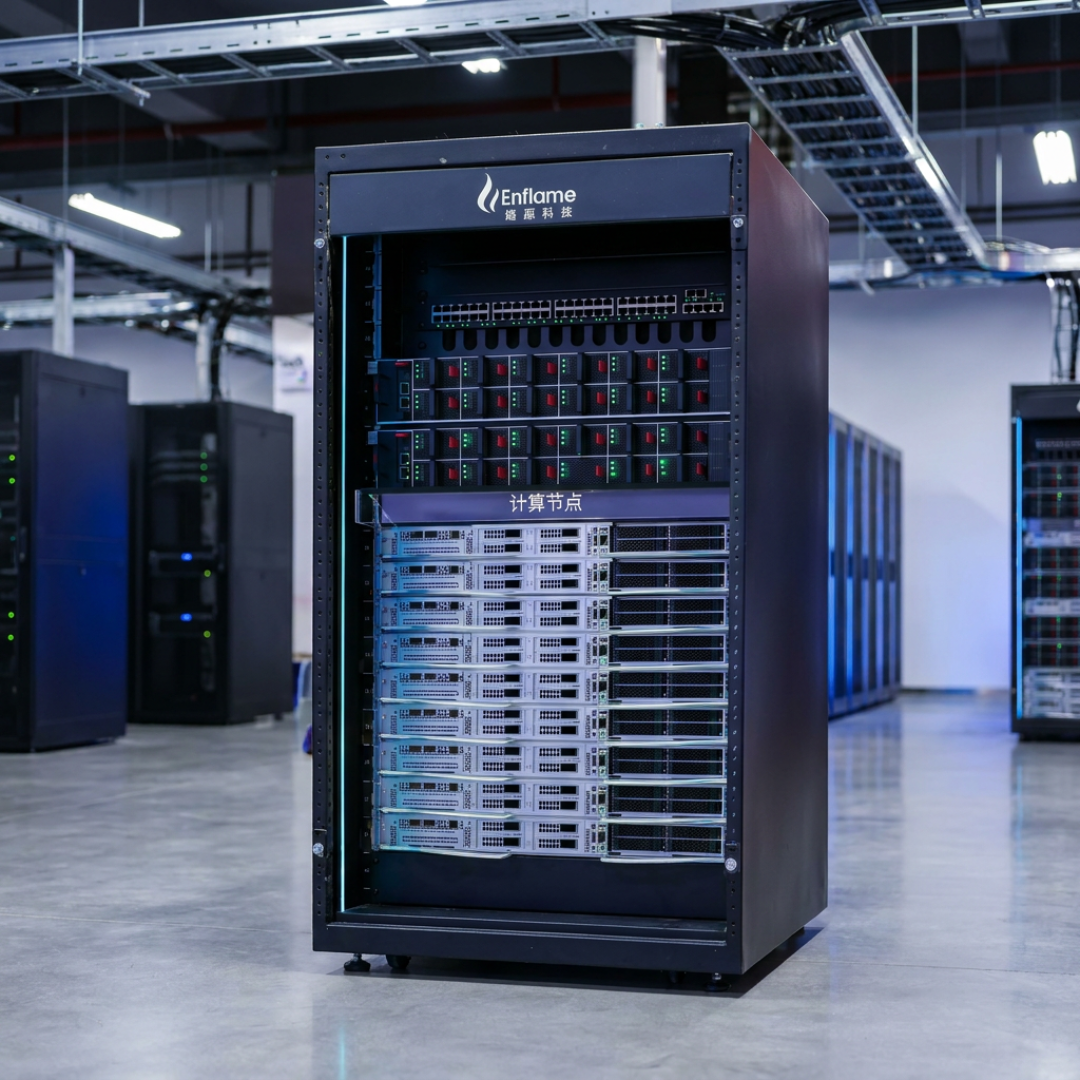
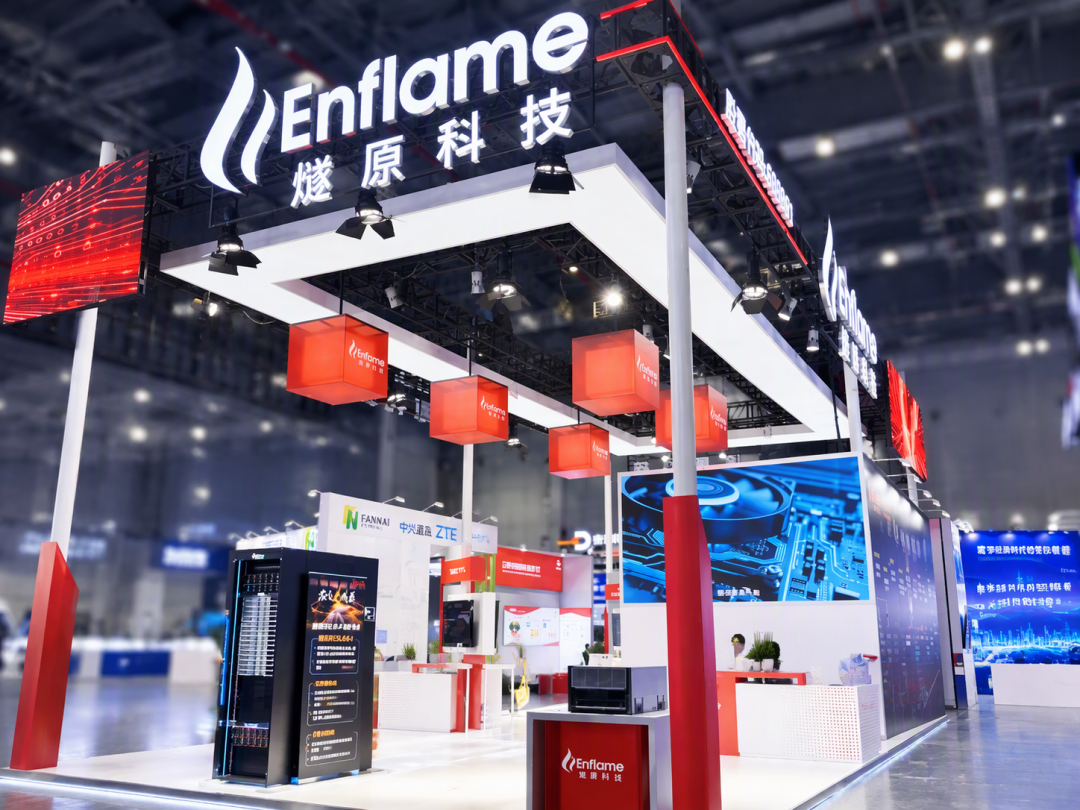
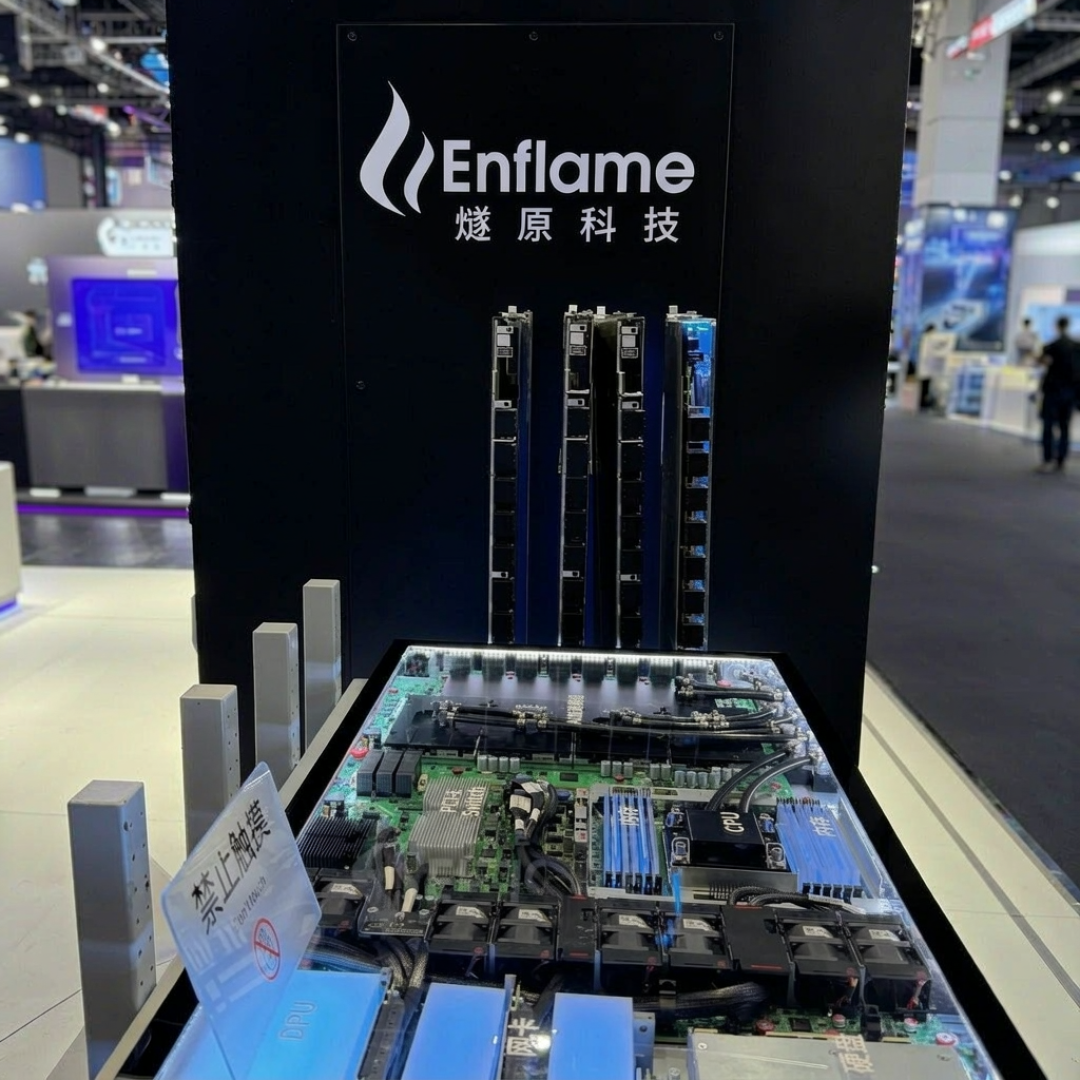
燧原的64卡超节点是与中兴通讯合作的,燧原主要提供GPU芯片,中兴通讯承担机柜架构、整机集成与交付等工作。 当被问及为什么不直接推128卡时,展台工作人员说得很实在:技术上不是做不到,但卡数意味着更高的整机采购金额,客户是否愿意为此买单才是问题。36氪
摩尔线程、壁仞、阿里云等此前已布局单柜128卡方案,中兴OEX架构也支持单柜最高128卡;壁仞则把宝押在更远处:芯粒拼芯片,配合自研的NPO光互连技术,光引擎直接集成到GPU上、绕过传统的DSP芯片做低延迟长距离传输,今年WAIC上拿出了1024卡超节点方案。 拼芯片容易,芯片间通信延迟和一致性才是真问题,NPO就是冲着这个来的。36氪
摩尔线程的叙事从12月的首届MUSA开发者大会就开始了:新一代"花港"架构宣称2026年量产、算力密度提升50%、能效提升10倍、支持十万卡以上集群;AI训推一体芯片"华山"方面给出的数据显示,相对英伟达目前在美国市场主流发货的Blackwell系列,华山在访存容量上已实现超越、访存带宽处于同一水平,但在浮点算力和高速互联带宽方面还有不小差距。 这组"自己公布、也自己标注差距"的数字,比一句"全面超越"更接近真实水位。钛媒体
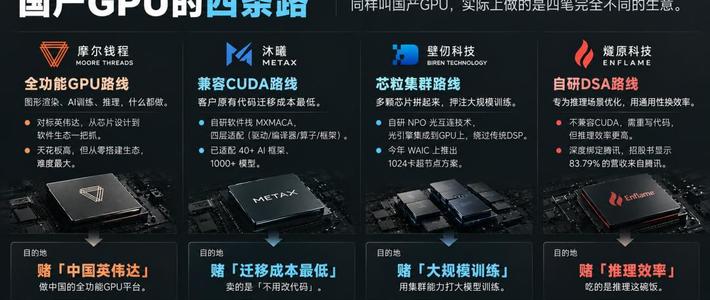
把这四张牌放在一起看,会发现所谓的"四条路"其实是在用机柜的形状投票:摩尔线程做全功能GPU、想成为"中国英伟达";沐曦卖"不用改代码"的CUDA兼容迁移,自研软件栈MXMACA做了驱动、编译器、算子、框架四层适配,官方称已适配40多个AI框架、1000多个模型;壁仞赌大规模训练集群;燧原走DSA专用架构吃推理这碗饭,不兼容CUDA,招股书上的数字,83.79%的营收来自腾讯。 2025年推理已经占了AI服务器市场的67%,训练只有33%——燧原的选择,赌的就是这个结构。36氪
买单者名单:GPU出货在跌,AI加速芯片出货在涨
超节点最终要有人掏钱,而10月13日路透社援引的IDC报告把市场结构说得很清楚:2026年上半年中国数据中心AI加速芯片出货200.8万颗,英伟达67.8万颗占34%,华为57.2万颗占28%,阿里平头哥约7%。更值得注意的是同一份报告里的分化:中国GPU出货量99.1万颗,同比下降26%,而其他类型AI加速芯片出货量达到101.6万颗,同比增长近80%。 "GPU"这个品类在中国市场出货量收缩,不是算力需求萎缩,而是需求被非GPU架构的分母吃掉了。再叠上2025年的账本——国产AI加速器出货165万张里华为昇腾一家拿走81万张,"四小龙"加起来不足7%——四小龙们喊的超节点,对手名单里既有英伟达,也有华为那套从芯片到软件框架的全栈,还有脉动阵列式的ASIC们。36氪
另一个隐形的买单约束是时间差,这种投资周期的滞后性,是当下一些市场化"算力工厂"最头疼的问题。 工博会现场一位地方智算中心投资人抱怨:芯片厂商几乎一年一代,而一座智算中心从规划、建设到投运往往要两年以上——等设备能对外服务,"最新算力"已经不是最新了。这就是为什么采购超节点实质上是在预付未来几年的技术路线:芯片能跑模型只是及格线,如果需要投入大量工程师重写算子、适配框架,单卡的价格优势很快被软件成本抵消;各家软件栈互不兼容、换一家供应商重新来一轮的隐性开支,才是TCO里最难估的那项。摩尔线程上半年营收17亿多、壁仞12亿多、沐曦13亿多,都被卡在业内公认的"30亿生死线"下面;而摩尔线程的存货周转天数达到了658天,将近两年的产能堆在仓库里,占用的全是现金流。 这就是产能排队时代里,现金流的真实形状。36氪36氪
被并行重构的,还有"并行计算"这门手艺本身
如果你关心的是"要不要学GPU编程",这轮超节点新闻里还藏着一个更底层的变化。9月16日知乎一个101赞、151收藏的回答把话挑明了:nv在当前的LLM任务中,SIMT架构已经不是主力,现代的算子编程范式已经从SIMT转向以wgmma为代表的warp协作编程范式(Hopper架构),之后是由tcgen05指令簇代替(Blackwell架构),趋势是线程概念一步一步退场,更多环节交给硬件托管。 纯SIMT手写访存的带宽利用率,实际上被寄存器数量和scoreboard项数限死——在飞数据量约等于带宽乘以访存延迟,这不是软件写得不好的问题,是硬件资源约束;SIMT如今主要退守到矩阵main loop之外的后处理(epilogue)和仍然适合它的HPC解耦合计算。知乎
那个回答还顺手纠正了一个流行误解:国产GPU里走SIMT的其实不少,至于AI ASIC,多数人印象中的"国产SIMD"大概率是指每个PE由matrix core加vector core组成、指令同步广播执行的那类架构,也就是TPU式脉动阵列。 换句话说,“国产卡是不是落后一代架构"这个问题本身就问错了方向:真正的分水岭在矩阵单元是不是通用SIMT执行的一部分,以及有没有人愿意在你的软件栈上长期写代码。中国工程院院士郑纬民在MUSA开发者大会上的表述可以作为注脚,因为"不是你有芯片能跑一个软件就可以了,关键是要让开发者愿意用这个芯片”。知乎钛媒体
不同人现在该看什么
CUDA开发者/infra工程师:四家公司四个软件栈、互不兼容的现实短期无解。选卡前先问三个问题:你们模型依赖的算子在这家有没有现成实现?迁移预算按"人月"算过没有?供应商的软件栈更新节奏追不追得上框架版本?硬件差距在缩小,从"能用"到"好用"之间那道生态鸿沟才是真成本。
学习GPU并行计算的入行人:把经典SIMT教材(线程/块/网格、占用率、内存层次)继续当地基,但尽早去看TMA、warp-group级协作指令和MoE并行的通信模式——手艺的"主力姿势"正在从"人管访存"转向"人管算法、硬件管搬运"。
智算中心买方/区域算力投资人:随着超节点技术逐渐成熟,今年底到明年会有一批产品实现商业化落地,值得盯的信号很具体——几家厂商能否进入字节、腾讯、阿里的采购清单、产能和供应链能否兑现,以及"帮地方把算力投资做成产业闭环"这类承诺有没有第一个落地的样板。
普通AI玩家:超节点竞赛的短期红利可能不是你的卡变快,而是国产推理卡把token单价往下按——但前提是那家的软件栈真的把你要跑的模型适配顺了。
证据边界照例说清楚:上文各家100纳秒时延、15%带宽、华山对Hopper/Blackwell的对比等数字,全部出自厂商展会口径或官方发布会,尚无第三方复测;IDC份额是单一统计口径,而2026年中英伟达在华份额,Bernstein给的预测是整体掉到8%、高端几乎换了一遍,换个口径Reuters估计英伟达整体还占着55%左右,两个数字的落差本身就是"高端几乎换了一遍、中低端还在混战"的另一面。 超节点这场竞赛今年还看不出赢家,但机柜里的数学已经交代完了:并行怎么切,柜子就怎么长;谁买单,路线就走哪条。36氪