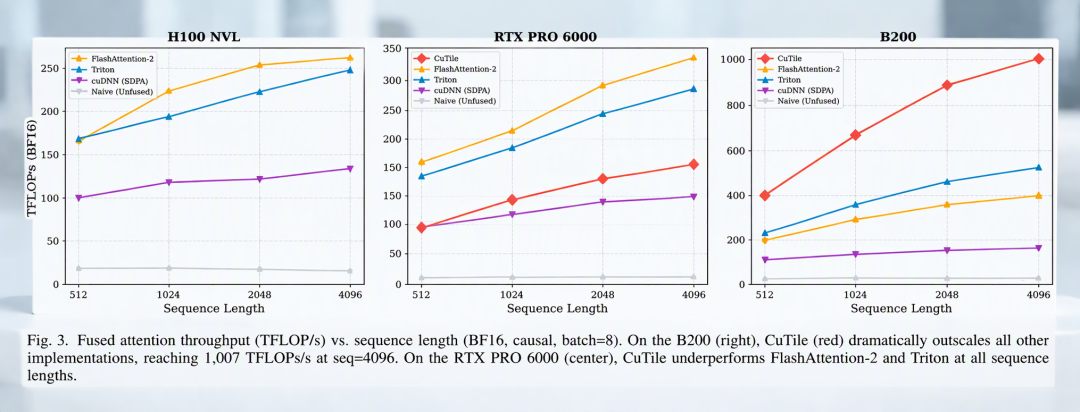
这几个月,GPU 并行计算圈反复转发同一个数字:cuTile 在 B200 上跑融合注意力,约 60 行 Python,吞吐 1,007 TFLOP/s,FlashAttention-2 的 2.5 倍。
但同一篇论文里还有一句话没有传播度:完全相同的 Tile 内核,挪到 RTX PRO 6000 Blackwell(sm_120)上,只跑到 FA2 吞吐的 53%。知乎
同一份代码,一块卡 2.5 倍,另一块卡 53%,差距接近 5 倍。这是 CUDA Tile 推出半年后最容易被标题党误读的地方。要不要把 kernel 搬过去之前,先把三笔账算完。
一、CUDA Tile 改的不是硬件,是你跟谁打交道
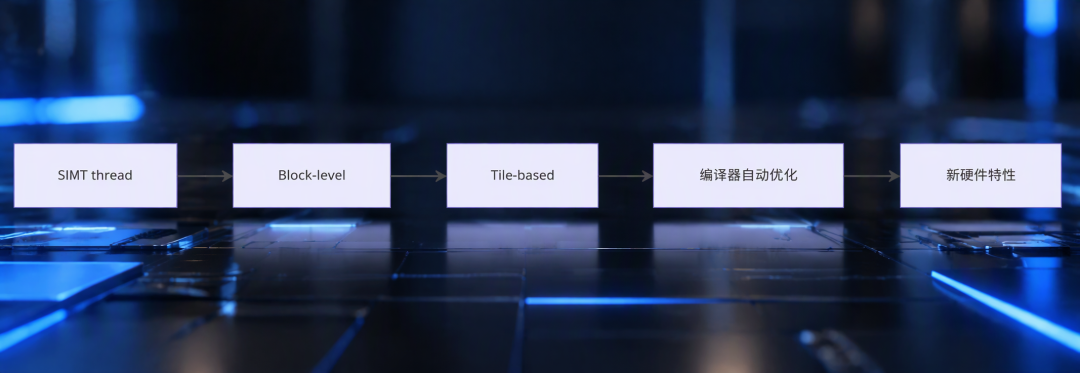
传统 CUDA 写法是 SIMT:程序员自己管线程索引、线程块划分、warp 协作、shared memory 和边界条件,一个元素归哪个线程算,是你说了算。
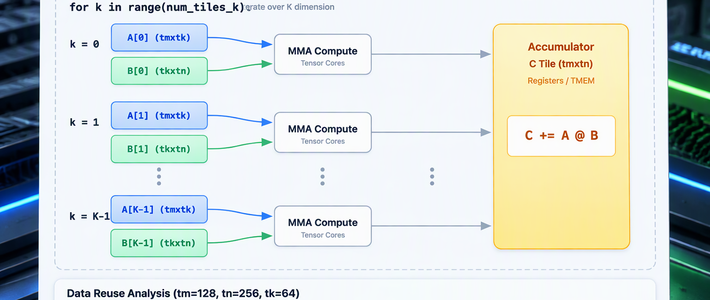
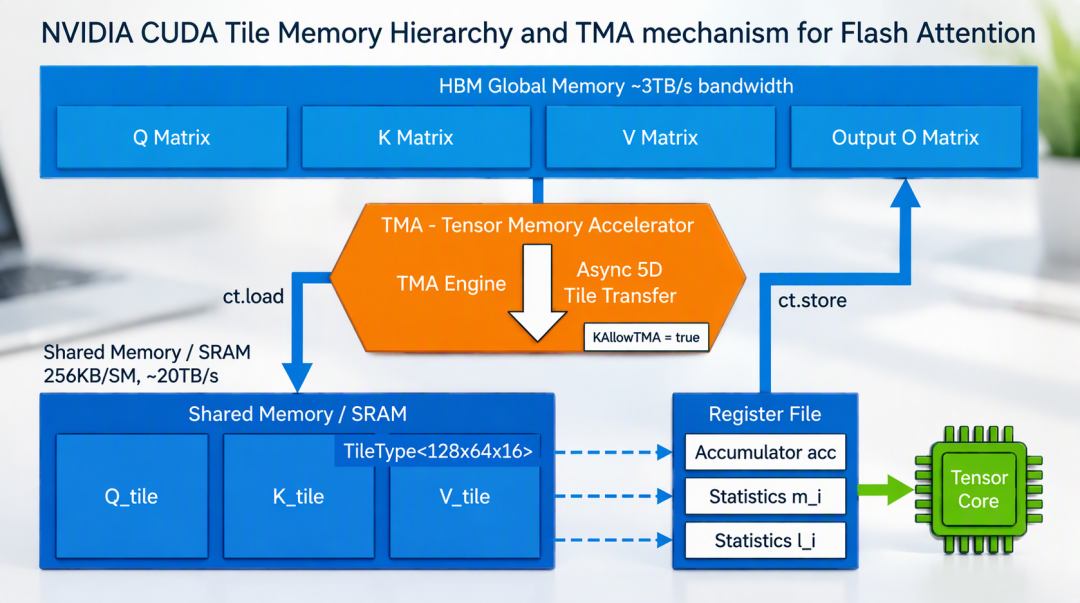
CUDA Tile 换了个主体:你以一块数据(Tile)为单位描述加载、计算和存储,线程映射、Tensor Core 分配交给编译器。有个常见的误解要先纠偏——Tile 不是 GPU 上新增的某种物理计算单元,它只是编程和编译层面的抽象。
版本节奏值得记:CUDA 13.1 发布 CUDA Tile IR 和 cuTile Python 两个组件;CUDA Toolkit 13.3 起提供 CUDA Tile C++ 支持。Python 示例里最核心的动作是 `ct.mma()`:声明矩阵乘累加,由编译器按硬件生成 Tensor Core 指令;规则的 Tile 加载在支持的硬件上映射到 TMA(Tensor Memory Accelerator),比逐元素 gather 更擅长搬运整块数据。知乎知乎
二、第一笔账:多少行代码换多少 TFLOPS
arXiv 上 4 月提交的那篇《Evaluating CUDA Tile for AI Workloads on Hopper and Blackwell GPUs》(2604.23466)做了首个针对 cuTile 的独立跨架构评估:H100 NVL、B200、RTX PRO 6000 Blackwell Server Edition 三款卡,BF16/FP16 精度,测 GEMM、融合多头注意力和端到端 LLM 推理,对比对象是 cuBLAS、Triton、WMMA 和原生 SIMT。知乎
两个数值得抄进笔记:
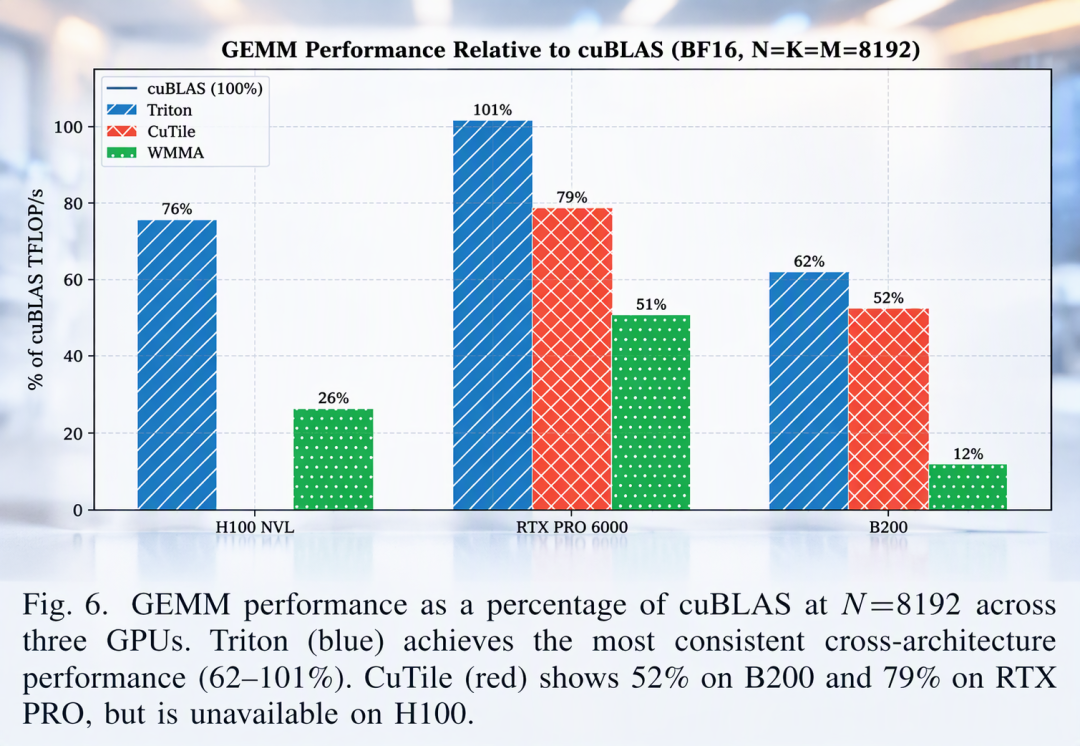
GEMM:cuTile 用 22 行代码达到 cuBLAS 性能的 52%—79%;作为对照,WMMA 手写 CUDA 约 123 行。知乎
融合注意力(B200):60 行 Python,1,007 TFLOP/s,超过 FlashAttention-2 达 2.5 倍。知乎
论文自己的结论也克制:cuTile 可以作为手写 CUDA 内核的实用替代,但现阶段替代不了厂商优化库。52%—79% 的 cuBLAS,够"赢手写",还不够"替 cuBLAS"。
三、第二笔账:性能交给编译器之后,编译器并不认识每一块卡
B200 上 2.5 倍,sm_120 上 53%,同一份注意力内核,变量只有架构。论文的说法是"暴露出显著的跨架构优化差距"。知乎
作为对照,Triton 在同一篇论文里呈现了相反的性格:全部三款平台、无需任何架构特定调优,维持 cuBLAS 性能的 62%—101%。知乎
这就是抽象的定价:SIMT 时代,逐架构调优是你的工作;Tile 时代,逐架构调优变成编译器后端的工作。数据摆在那儿——同为 Blackwell,数据中心卡和 workstation 卡拿到的编译优化力度不是一档。你买到的"少写 100 行代码",有一部分是用"性能命运不再全在自己手里"换的。
四、第三笔账:墙从代码层挪到了 IR 层
过去半年 NVIDIA 有两个动作,比 2.5 倍这个数字更值得记:
2026 年 7 月,CUDA Tile IR 正式接入 FlagOS 社区的统一编译器 FlagTree。FlagTree 已原生适配 12+ 款芯片后端,目标是"算子一次编写、多硬件部署";Tile IR 与 PTX/SASS 路线不同,不绑定特定硬件指令集细节,支持从 Ampere 到 Blackwell。同期,NVIDIA 把 Triton-to-Tile IR 作为开源项目孵化。知乎
2026 年 9 月,CUDA 原生支持 Rust:cuda-oxide 走 SIMT 路线、还在 alpha,cutile-rs 走 Tile 路线、已经发到 crates.io 并有开发者在用;官方规划里 CUDA Rust、CUDA C++、CUDA Python 三个前端可以互相混用。知乎
以前问"CUDA 护城河是不是 20 年积累的代码",现在 NVIDIA 自己把代码往上抬到中间表示层,换语言、换编译器都沿着这条路走。B 站那门官方课程《现代 CUDA 编程:从 CUDA Tile 到多 GPU 实战》6200 多次播放、180 多个赞,就是这个转身底下,圈子里的人正在连夜占座的证据。哔哩哔哩
五、谁现在该上手,谁先别动
按证据把人群分开说:
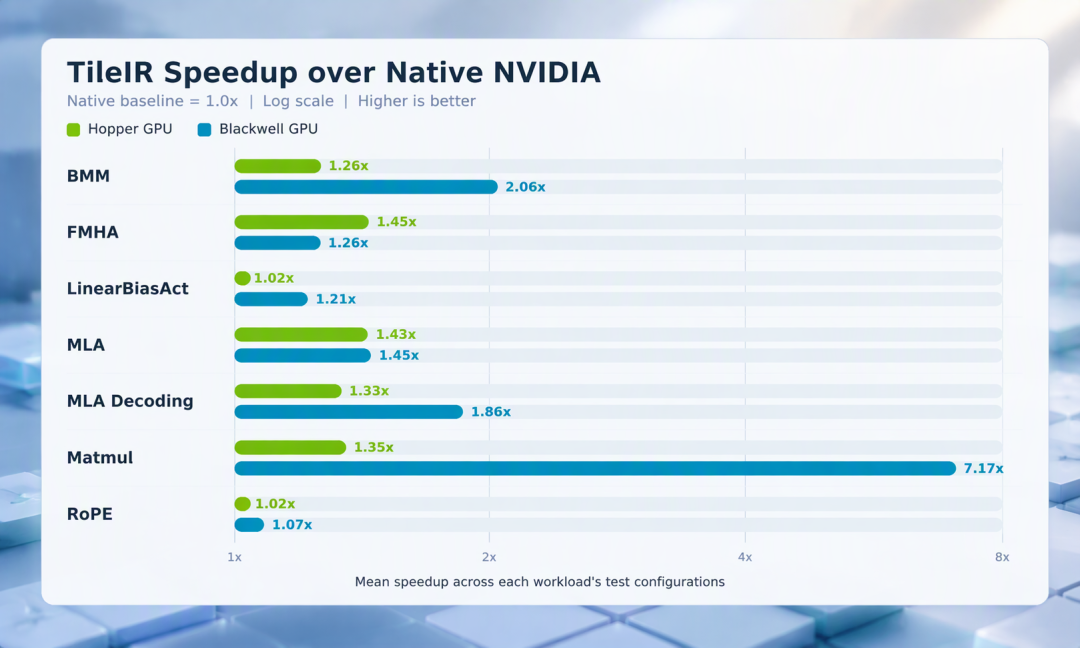
建议上手:手里是 B200 或数据中心 Blackwell 的;写的是注意力、逐元素链这类融合算子的;没有专职 kernel 工程师的小团队。22—60 行的产出密度就是给这类场景准备的。
建议观望:桌面和工作站卡用户(sm_120 那个 53% 是实测,不是猜测);追 GEMM 极致的(52%—79% 满足不了你,cuBLAS 还是天花板);异构机队——Tile IR 接 FlagTree 只说明接进去了,多芯片后端的实测数字还没论文替它背书。
稳妥的引入顺序不用发明新词:优先走 cuBLASLt/CUTLASS,自定义小算子交给 Triton,cuTile 放在实验开关后面,编译失败、误差超阈值或性能回归就回落稳定实现。fallback 是设计的一部分,不是事故之后补的分支。知乎
六、手写 CUDA 还学不学:饭碗没换,锅换了
知乎那个《掌握 GPU 并行编程(硬件&软件)》系列更到第二十九章,讲的还是 Nsight Compute、占用率和 Roofline 线图。这套东西不会因 Tile 作废:Tile 内核慢的时候,你仍然要开 profiler 看 load 有没有合并、Tensor Core 出没出现、spill 有没有发生、launch 是不是过多。知乎知乎
变的只是时间花在哪:从写线程,变成读编译器生成的东西。比较 cuTile 和 Triton 时记得纪律——同一算法、同一 shape、同一 GPU、同一误差阈值,比出来的差才有解释价值,不同机器、不同论文版本的数字不进同一张表。知乎
接下来盯三个信号:FlagTree 对 Tile IR 后端的多芯片支持会不会放出实测;cuTile 下一批跨架构数据里 sm_120 的 53% 有没有收窄;cutile-rs 什么时候从 crates.io 走进官方教程。
尾声
系统软件里没有免费的抽象。CUDA Tile 用 60 行 Python 换走的,一半是你的性能命运,另一半是编译器路线图上的优先级。知乎
下次再有人甩"2.5 倍 FlashAttention"的标题,记得问他同一篇论文里的 53%。两个数字写在同一篇论文里,才是这个 22 行代码的工具给自己留的最诚实的注脚。