本地党这个十月,共同状态只有一个字:等。
10月10日,Qwen Developers 的一条 X 原帖把社区点燃,B站搬运解读的视频底下挂了219条评论,最高赞只有六个字——“qwen小模型才是真神”(73赞)。但截至今天(10月15日),没有任何一个 Qwen4 权重落地:云栖大会上官方给四个新模型的后缀是 Coming Soon,口径只有"已在训练中"八个字。哔哩哔哩知乎
这种状态下,最不值钱的动作是掏钱包,最值钱的动作是把"已确认"、“推测”、"未知"三档摆清楚,再看你的机器坐在哪张桌上。下面这些,是我把云栖官宣口径、8月26日已开源的架构预览、推理栈PR动态、微博/知乎/B站/抖音四个平台一周内的讨论现场拼在一起之后的结果。
一、先把事实和推测切开:官宣是"摊牌",不是"发模型"
9月22日云栖大会,Qwen LLM 项目负责人刘大一恒第一次把 Qwen4 的完整阵容端出来:Qwen4-Max、Qwen4-Flash、Qwen4-Plus、Qwen4-27B。很多人把这个"官宣"读成"发布",细看其实不是——四个名字后面全是 Coming Soon。
信号 | 内容 | 定级 |
|---|---|---|
9/22 云栖 | Qwen4 四员大将:Max / Flash / Plus / 27B,后缀"Coming Soon",口径"已在训练中" | 官宣确认 |
9/22 云栖 | 分工:Max 追智能上限、靠 RSI 递归自进化;Flash/Plus 追性价比;Qwen4-27B 明确留给本地部署 | 官宣确认 |
8/26 | 架构预览权重放出:Qwen3.8-Flash-Next,就是 Qwen4 那套架构 | 官宣确认 |
10/10 | Qwen 官方 X 原帖,社区解读为"Qwen4-27B 与 Max 同期发布" | 帖子属实,解读属推测 |
10/11起 | "双开源官宣"说法 | 自媒体日报转述,非官方口径 |
9月底起 | 千问4内测测评、Cursor 疑似 Qwen4 神秘模型 | 社区目击,未经证实 |
至今 | 27B 是 dense 还是 MoE、总参数量、Flash/Plus 是否开源、量化支持时间表 | 未知 |
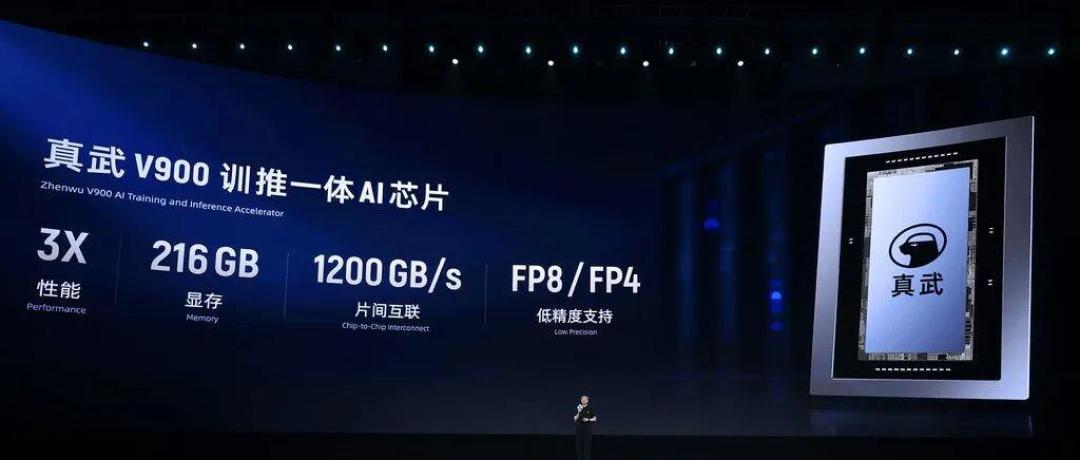
顺带一句:同场公布的 Qwen4.5/Qwen5 要冲 5-10 万亿参数、自研芯片真武 V900 配 216GB 大显存——这两条跟你家显卡关系不大,别拿它吓自己加内存。官方数据里和本地党真有关的是另一条:RSI 自进化上线一个月,33 轮有效数据迭代,把 Qwen3.8 在 Artificial Analysis 的分数从 40 磨到 45。模型自己产数据、自己训练,人负责看护——迭代节奏变快,才是"该不该急着换版本"的真正背景板。微博
二、真正值钱的信息:架构8月就开源了,推理栈已经铺好路
8月26日放出的预览权重 Qwen3.8-Flash-Next,官方口径就是把 Qwen4 的底层架构提前交给开发者验证。拆开看每个本地党都该认识的零件:
主模型 125B,每个 token 实际只激活约 6B;
外加一张 51B 的 n-gram 嵌入表,放在每个 token 的算力预算之外;
原生上下文 262K,用 YaRN 可拉到 1M;
官方给的账:训练成本约为 Qwen3.7-Plus 的 1/9,百万 token 输入价格降到 1/4。微博
推理栈这边,路已经铺好:llama.cpp 8月27日合并了 qwen4exp 支持,Transformers 8月26日合并了 qwen4 测试,vLLM 的 Qwen4 相关 PR 还在排队。一句话:今天部署预览模型,跑的就是 Qwen4 的架构——等正式版落地,是升级,不是迁移。知乎
B站评论区那条高赞争论——“事实上3.8已经是qwen4 flash,因为是一样的架构"vs"开源版本连原生百万上下文都没有,官方肯定藏东西了”——就是这次预览的两种读法。不用急着选边,事实只有一条:路已通,车未到。哔哩哔哩
三、51B 的 n-gram 表:门票问题从"显存装不装得下"变成"表放哪儿"
n-gram 表这玩意儿,一句话讲透它为什么改写本地部署的账本:查起来便宜、存起来占地方。模型预测下一个字时直接从这张超大的查找表里取值,不用逐 token 现算——把它塞进每次前向的算力预算纯属浪费,所以官方干脆放到预算外面走"查表"。这就是 125B 总参数、训练成本却只有 1/9 的核心原因:大部分参数并不在每次前向里干活。
对本地党,这个结构意味着两件事:
决定你机器档位的不只是权重体积,还有这张表放哪儿。 社区已经把玩法跑出来了:知乎有人晒出 9700X + 64G 内存 + 4080 32G 的档位——热门专家放显存、冷门专家放内存、PLE 表放硬盘,IQ4_XS 量化 4.25bpw 已非常接近无损,专家命中率 95% 起步、后期能到 98%,代价是内存占用很高。知乎
n-gram 是不是"可选项",是权重落地当天最值钱的参数。 B站评论里那条没什么赞但问得极准的话:"n-gram以后能成为可选项,相当于额外知识储备,可以挂在硬盘上,就好了。"表可以挂硬盘,16G 党才有上桌资格;表必须常驻,门票就是 64G 起步。哔哩哔哩

四、座位表:等权重的这段日子,每档做什么、不做什么
你的机器 | 现在(Qwen3.8 系列)的真实座位 | 等 Qwen4 该做 | 等 Qwen4 别做 |
|---|---|---|---|
8–12G 单卡 | 27B 量化版最低 8GB 显存就能起;A卡这边 7900XTX 24G 满血跑过 53TPS + 262K 上下文 | 先把 Flash-Next 预览架构装上,把工具链、上下文、报错现场预热一遍 | 别为一张未知参数表提前囤内存 |
16–24G 单卡 | GGUF UD-Q4 档是主座(单张 4090 实测可跑) | 盯 llama.cpp 和 Strata 对新量化格式的支持速度——Strata 目前社区反馈只到 IQ3,IQ4 以上支持才是行动信号 | 27B 若官宣 dense,你大概率还在原位;若官宣 MoE,这张桌反而更宽 |
2×4090 / 48G | FP8 官方参考位(2x4090 起跑),GGUF 降级单卡 | 权重落地第一天转正式即可,等货期没有必须动作 | 别折腾社区魔改量化版,原版稳定性的教训 10 月刚有人替你们踩过 |
64G+ 内存 / 统一内存 | n-gram 架构的最大受益档,专家+查表分层驻留玩法已验证 | 现在就练 Strata 类引擎的显存/内存/硬盘分层 | 别默认 51B 表要吃显存,表放硬盘才是这档的正确姿势 |
双十一前手痒的再加一句:官方只给了"训练中",Qwen4-27B 的内存和显存需求全是推测,照着一张没公布的参数表提前囤货,是追新最贵的方式。
五、这个圈此刻最在意的,浓缩成四个分歧
能力锚点:“27b 能赶上 GLM-5.3 Flash 就行”(58赞、24回复)vs 反方"世界知识储备摆在那里,赶不上只能反复大思考"。24G 党的验收线其实早写好了:不是超旗舰,是接棒自家。哔哩哔哩
开源范围:“27b 不开源没啥意义,Max 不开源有说法"vs"正因为只有大企业才部署得起才毫无忌惮地开源,小模型赚口碑、大模型才赚钱”。知乎博主对官方推文的读法是:“Qwen4 和 Qwen4-27B 都要开源的样子”。知乎
档位焦虑:评论区许愿"希望还有 35B-A3B 版本,或者比 3.8-Flash 小点,不然跑不动"(19赞),底下接得实在——“搞个64G内存跑 q2xxs,也能用”。
刷分免疫:“希望别又是刷分王”、“qwen4 救一救,这代 2b 能不能到 Opus4.6 的水平”(19赞)。许愿清单就是需求清单,社区对 4bit 党的诚意验收,从来不看跑分页。
还有个彩蛋分歧:评论区冒出"太好了有Plus,3.8太极端了,2.4T 大材小用、135B 又偏小,正好 400 多 B 的 Plus"(15赞)——Plus 到底多大没人知道,但"中间档"被喊出来了,这就是本地党给官方递的真实需求单。
六、权重落地当天,盯这六个信号再动手
官方 X / ModelScope / HuggingFace 的 repo 名出现——先核对 repo 名与官方账号一致再下载,每轮热度期都有假仓库;
公布的是 dense 还是 MoE、主参数和激活参数各是多少;
n-gram 表是否为可选项、官方给不给硬盘/内存驻留的部署说明;
llama.cpp 的 qwen4exp 何时进主线、社区 GGUF(unsloth 级)量化几天内放出;
vLLM 的 Qwen4 PR 是否合入、Strata 适配版本和支持的量化档位;
官方 FP8 参考权重是否先行——这是 2×4090 党的发令枪。
这六个信号亮完,"要不要加内存/换卡"才值得被认真回答。在那之前,等权重的正确姿势只有一个:在预览架构上把自己那套路跑熟,钱留在口袋里,座位先找好。