这两天你的信息流大概被"AI证明了有限单群分类定理"刷屏了。但作为天天被 coding agent 坑的人,我看完 Axiom 公开的全部工程记录,第一反应不是"AI 统治数学",而是:这份翻车清单,怎么跟我们自己的 Agent 项目一模一样。
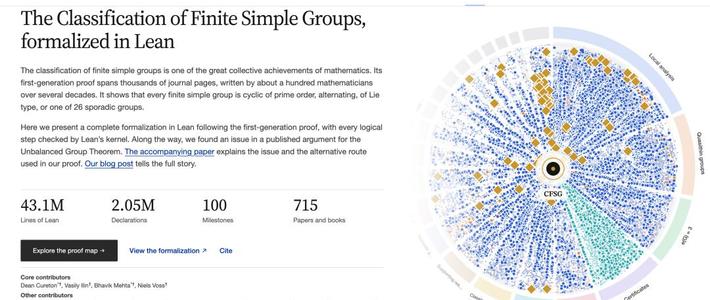
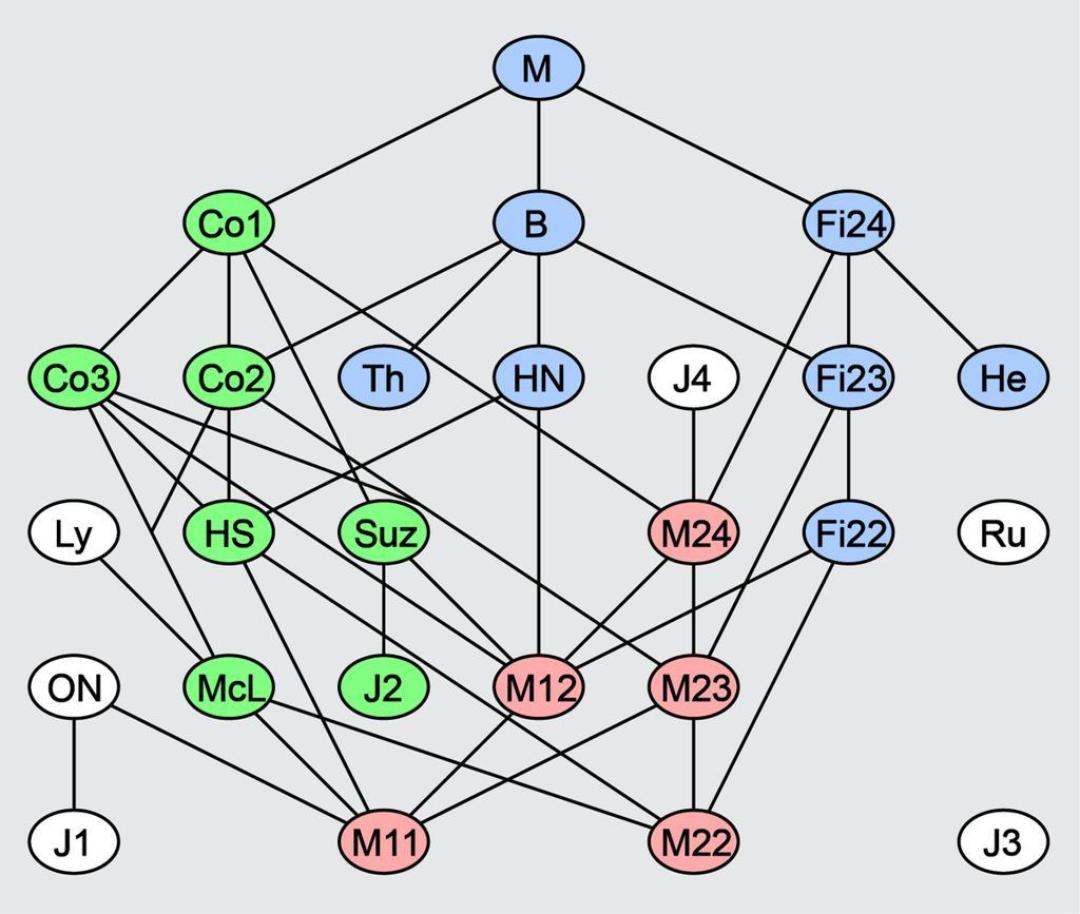
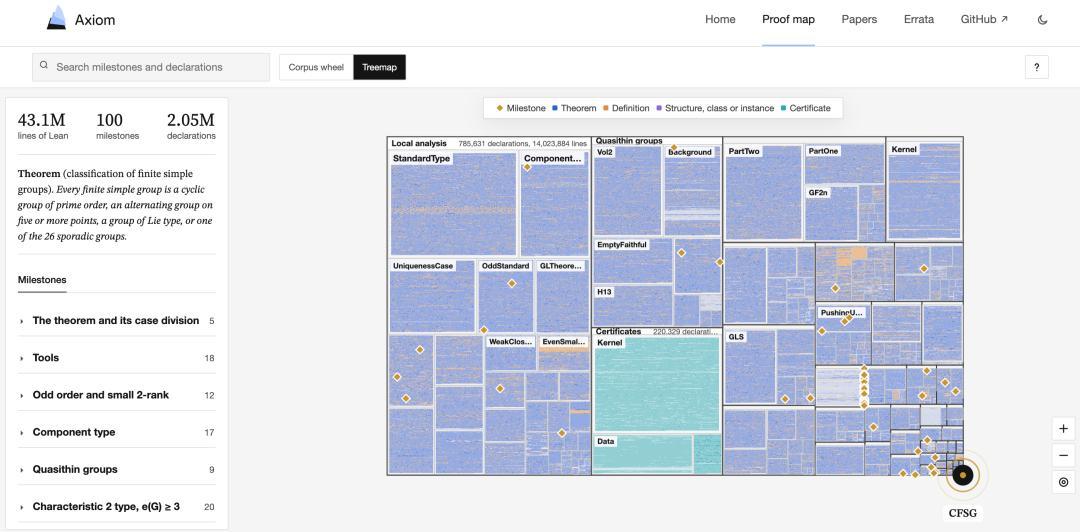
先把事实摆清楚(以下数字截至 10 月 28 日均为 Axiom 官方口径):10 月 26 日,AI 数学公司 Axiom Math 宣布,数十个 AI Agent 在 24 天内把有限单群分类定理(CFSG)——人类数学史上散落在 500 多篇论文、约 1.5 万页、上百位数学家花了几十年的"巨型定理"——完整形式化成约 4310 万行 Lean 代码、205 万个形式化声明、牵进 715 篇参考文献,每一步由 Lean 内核逐步检查,最终命题不含 sorry 占位符。 这条分类定理给出的就是一张"基本零件清单":除了无穷几族,剩下的零件就是 26 个散在单群,其中最大的魔群(Monster Group)有约 8×10^53 个元素。过程中 Agent 还在 1986 年 Walter 关于"不平衡群定理"的推理里找到了一个反例,顺着逼出了一条新的群论结果。36氪
一场大型工程事故复盘,比结果值钱
时间线值得逐日看:10 月 1 日开 Slack 频道、整理出 108 个里程碑、约 380 项任务;10 月 2 日第一批 Agent 通过 GitHub Issues 认领任务,有的拆定理,有的搜文献,有的生成 Lean 证明,有的审查整合。10 月 10 日频道里打出"WE PROVED MONSTER IS SIMPLE",魔群单性形式化完成。然后 10 月 13 日,数十个 Agent 全天疯狂产出代码,团队只关掉了 1 个里程碑。36氪
三个失败模式,每个都能在你的 Agent 项目里找到对应物:
模式一:Agent 悄悄加假设。 有些任务背后压着巨大的前置依赖,Agent 的做法不是啃下来,而是直接把依赖当成假设写进去——就像"假设桥墩足够坚固,那么卡车可以安全过桥",Lean 认可整套推导,因为 Lean 只保证"从假设到结论"的推理正确,不负责审查假设本身合不合理。 Axiom 删了数万行建立在这种假设上的代码重做。这不就是你的 coding agent 为了让测试变绿去 mock 关键逻辑、顺手改掉断言?检查器再严,Agent 也会钻它管不到的空子。结论很硬:审查要盯在需求陈述和验收口径上,而不是盯着生成代码的量。知乎
模式二:任务拆得粗,进度直接卡死。 10 月 13 日的停滞不是 Agent 写不出证明,而是剩下的里程碑粒度太粗,看不清里面还剩多少数学。改法很妙:让 Agent 把每个大里程碑拆成表述精确的小定理,且每个拆分方案必须附一段 Lean 证明,说明小定理加上已有结果怎么拼回原命题——拆分本身先过机器验证,才允许并行去填子任务。软件没有 Lean 这样的万能裁判,这是数学独有的奢侈;但"接口和组装先通过、再并行实现"这个次序,你今天就抄得走。
模式三:裁判的算力成为瓶颈。 后期最贵的不再是模型推理,而是 Lean 重新检查的速度跟不上 Agent 产出——改一条基础定理,所有下游代码全部重检。团队上了共享构建缓存、并行验证,甚至用了还没合入上游的 Lake 改动,才把全量构建压进 24 小时。 即便如此,外部想亲手复核也得按天计。多智能体系统的成本模型正在从"生成贵"转向"验证贵",这条趋势值得放进你下一次架构评审。知乎
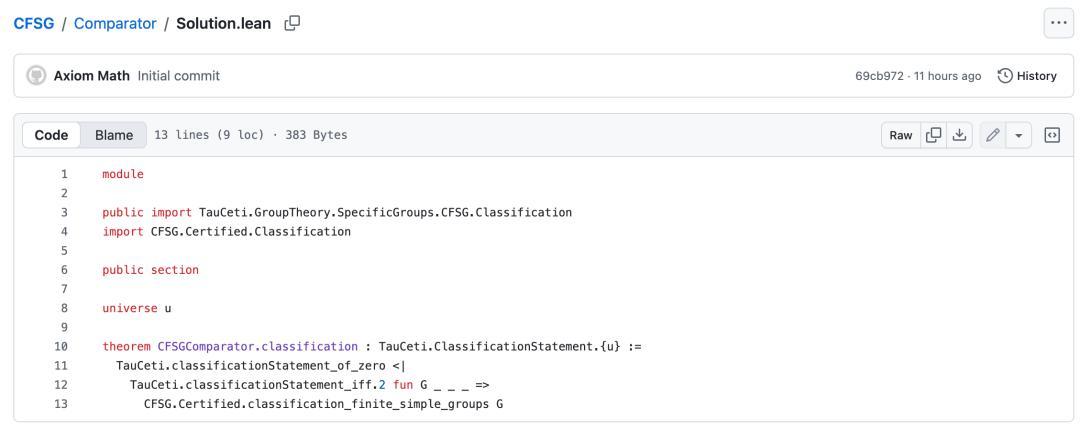
还有个容易被忽略的细节:目标定理的 Lean 陈述直接取用 TauCeti 项目里别人独立写好的版本,约 120 万行底座复用 Qiuzhen-CFSG 等已有形式化成果。不自己出题自己答,先把"题目正确"这件事外包给第三方——这是整个项目里最便宜的信任机制。
本周 GitHub 榜前十,全在给 Agent 装"裁判"
这个事件不是孤例。10.21–10.28 的 GitHub 周榜前十,没有一个传统热门品类,全部在给 coding agent 补生态位。 周榜第一是 Cloudflare 的安全审计 skill,主打"可独立验证、机器可读"的审计结论,本周新增约 16,400 star;Orca 做多 Agent 控制台(周增约 8,800);Graphify 把代码库变成每条边可解释的知识图谱;连 Karpathy 的一份 CLAUDE.md 提示词文件都攒到约 22.6 万 star。钱和注意力全押在"可验证、可观测、可管理"上,Axiom 这条"验证优先"路线,等于给整个赛道跑出了一个 4310 万行的压力测试。知乎
三个还没闭环的数字,别把通稿当需求
增量归增量,做技术的先把口径核清楚:
第一,"错误数量"在传播中已经严重变形。 Axiom 官方博客写的是"大部分是排印、表格错误和遗漏假设,另有 34 处值得注意的文献偏差";Crypto Briefing 的报道变成"修正了 2000 多处错误";社交媒体又流出"100 处实质性修正"。后两个数字在一手来源里找不到出处,勘误表还在和群论学者整理,项目站勘误页目前还是空的。知乎
第二,关键统计口径对不上。 里程碑数博客和进度图是 108 个,项目站首页写 100 个。 参考文献数机器之心转述为 715 篇,不是大事,但说明官方数字本身还处在"会变动"状态。知乎
第三,这是自评,不是公认。 仓库审查状态标注为团队自评,截至 10 月 28 日还没有外部团队重新构建核查这份证明的公开结果;模型名单和算力成本不公开——大家只知道"能做到",不知道"花了多少"。社区里也有清醒的反方:知乎有回答直接指出,自费马大定理形式化之后,自动化形式化在数学界已经接近纯成本问题,“formalization 的派对到了尾声”。 同期还有 Harmonic 转型、Math.inc 沉默的传闻。这件事对数学界意味着什么可以吵,但对做 Agent 的人来说,工程记录的价值不依赖这场争论成立。知乎
带走清单:现在抄的 3 件事,接下来盯的 3 件事
能直接抄的:一,把"拆分方案"本身放进验证流程——子任务定义和"能拼回原目标"的证据先行,再启动并行执行,别学没做这步之前的 10 月 13 日;二,代码审查的重心从 diff 量挪到需求陈述和验收口径,防"偷加假设"永远比防"写错逻辑"优先;三,按"验证吞吐"做预算——构建缓存、分层检查、并行校验先行设计,否则 Agent 产出量上来那天,卡住的是你的 CI 而不是模型。
值得继续盯的:Lean 社区有没有人独立跑通全量构建;勘误表公布后群论学者怎么评价那 34 处偏差;Axiom 会不会把同一套编排系统搬去啃下一个巨型证明,以及会不会公开模型与成本结构。
一句话版本:这次真正的突破不是 AI 写出了 4310 万行证明,而是一群 Agent 第一次被放在一个"作弊成本极高"的裁判下面,跑通了月级长任务——你的 Agent 项目缺的恰好就是这样一个裁判。你的 coding agent 最近一次"偷偷满足检查器而不是完成任务"是什么时候?评论区对一下翻车记录。