比API便宜17倍还被劝退?最高赞评论:本地大模型从来不为省钱
“便宜17倍,为啥还劝退?”这条B站视频的评论区,本地大模型玩家们吵了一周多。
10月24日,UP主ZZ是画渣做了件“自爆”式实测:3张二手计算卡P100、P40、V100插上计量插座测真实功耗,跑同一个Agent任务(读PDF→登录邮箱→存草稿→传附件),按Qwen官方API价格逐笔对账。机器是捡垃圾攒的X99,引擎是当红Strata,账对了两轮:500万、6000万token。哔哩哔哩
结果扎心:电费确实比API便宜得多,标题却照样大字写着“劝你别入坑”。5.3万播放、526条评论,吵的正是标题戳破的集体幻觉:本地部署=token自由?
最高赞评论直接掀底牌:“本地跑llm从来都不是为了便宜。为了合规,为了隐私,为了无审查版本等等。”419个赞,正面撞向标题里的“便宜”:玩家自己就不认省钱这笔账。哔哩哔哩
底下35赞的跟帖更直白:“谁家本地部署是为了更便宜?不都是为了稳定,隐私,还有合规吗”——高赞排行榜里,省钱派几乎排不上号。
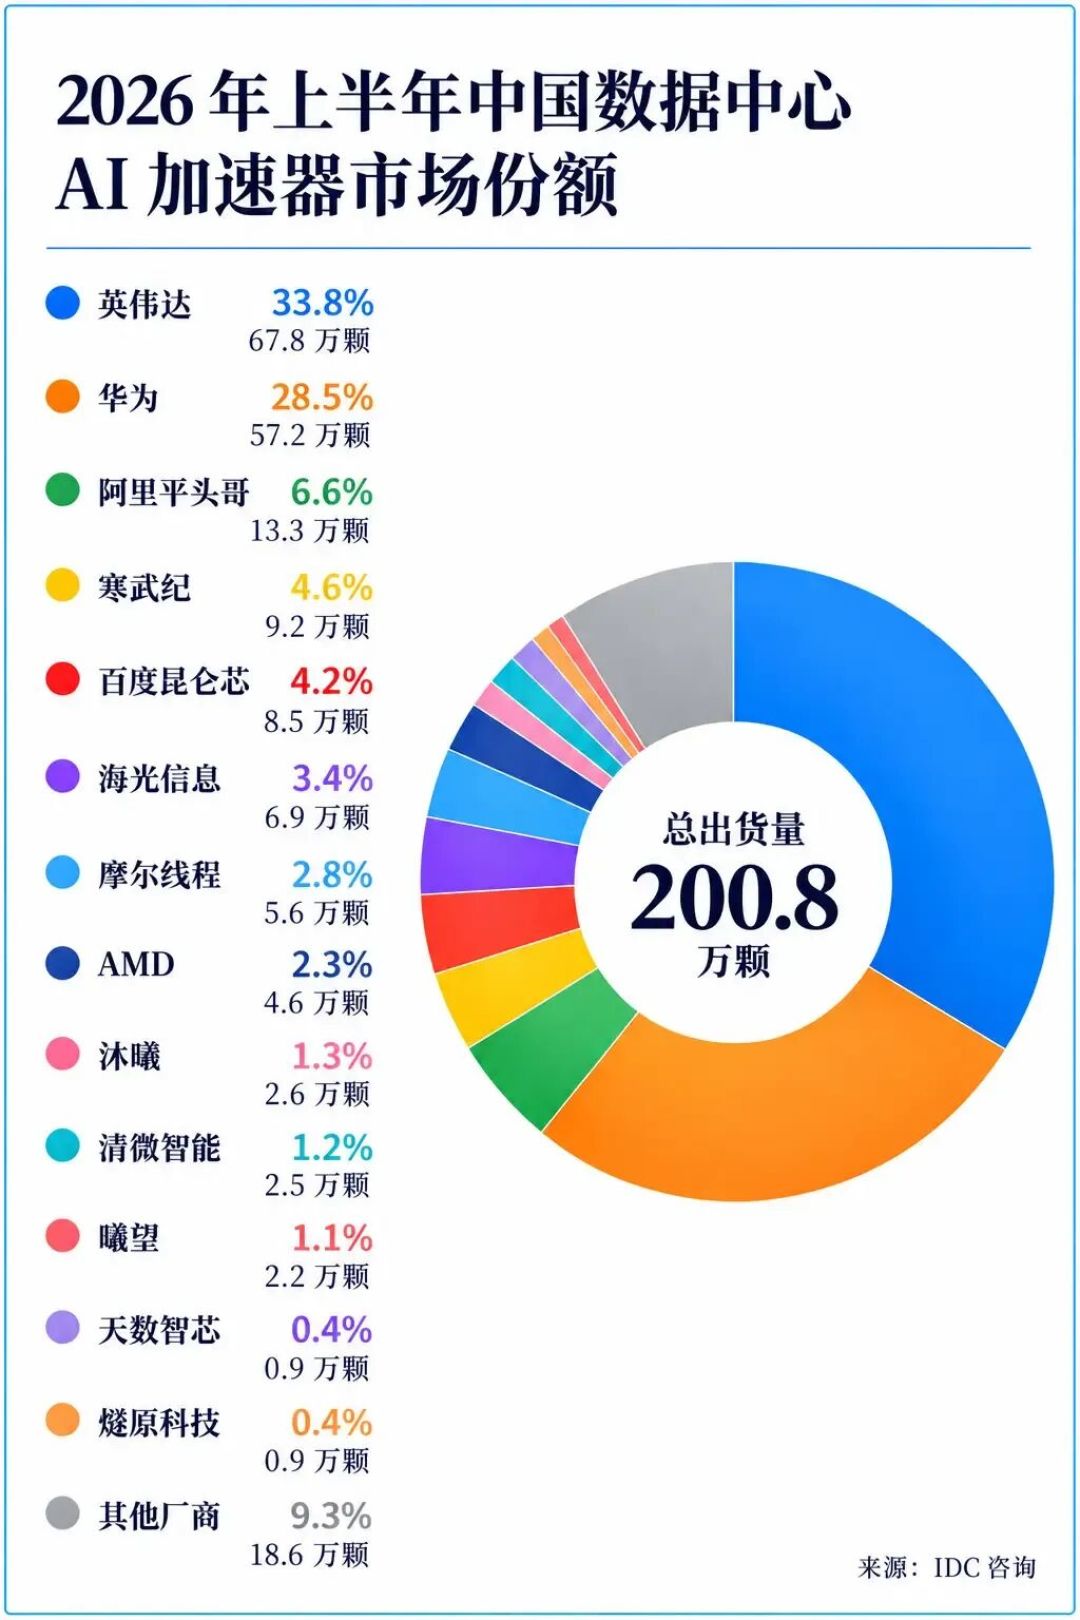
先交代大背景:这个月,腾讯、阿里、字节豪掷350亿美元抢卡。IDC口径下,上半年中国数据中心AI加速器出货约200万颗——显卡的稀缺,才是“捡垃圾”这门生意的前提。36氪
那“不划算”卡在哪?拆开是三笔账。
速度账。瓶颈从来不在算力,在显存和带宽。同一视频68赞评论承认:双张V100让专家全常驻显存才“稳180 t/s、堪比5090”,单卡不推荐。675赞“真假本地部署”视频的UP主坦言“本地部署真的开始实用并且能干活了”。但评论区转述的真实状态是:388GB模型塞进两台128GB统一内存,本地输出只有60-70 t/s,“隐私活留本地、赶时间的交在线”——最硬核的玩家都在混部。哔哩哔哩
体验账。V100要挂暴力风扇,评论区调侃“得配隔音耳机”,二手价最近又涨得“不美丽”。
折旧账。42赞反驳也值得看:“量化版API要折价的,哪能这么比”——17倍在口径上会被稀释;50赞的评价更冷静:“这东西是退路,假如没有这些显卡,你看看(API)是什么价格。”
什么人该入坑?数据不出机器的、离线合规的、纯玩个痛快的装机党——评论区示范了姿势:V100跑文本+embedding、4070跑ComfyUI,各干各的活。只想省token费,大概率被三笔账挨个劝退。
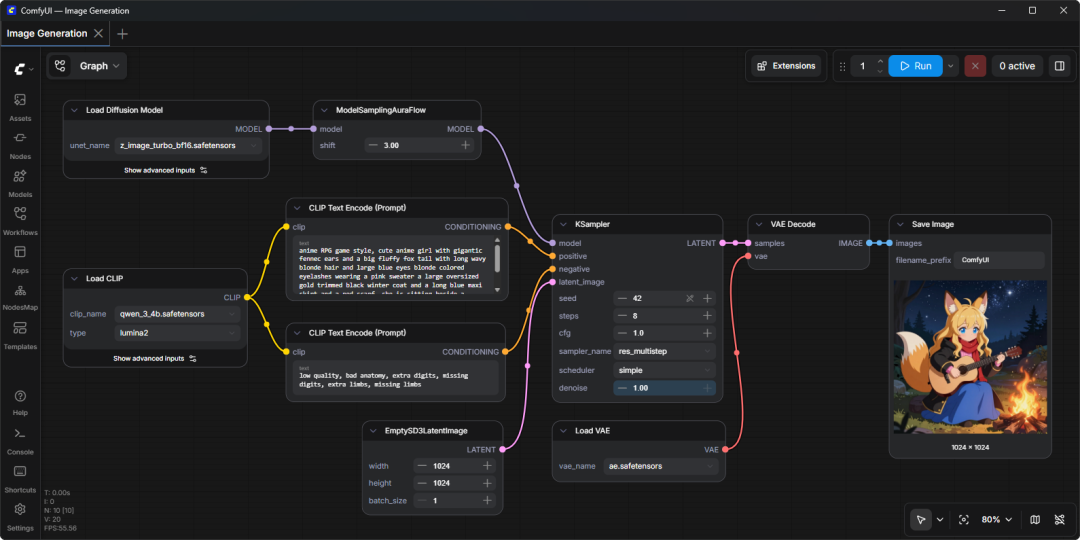
10月18日小红书笔记“本地算力拉满的快乐”,一句话戳中963个赞:“终于不用扣扣搜搜数着 Token 过日子了。”它和这周的争论视频说的是同一件事:本地大模型的门票,不是省钱凭证,是隐私收据。你买到的不是更便宜的token,是“这些token永远不会离开这个房间”的确定性。小红书