

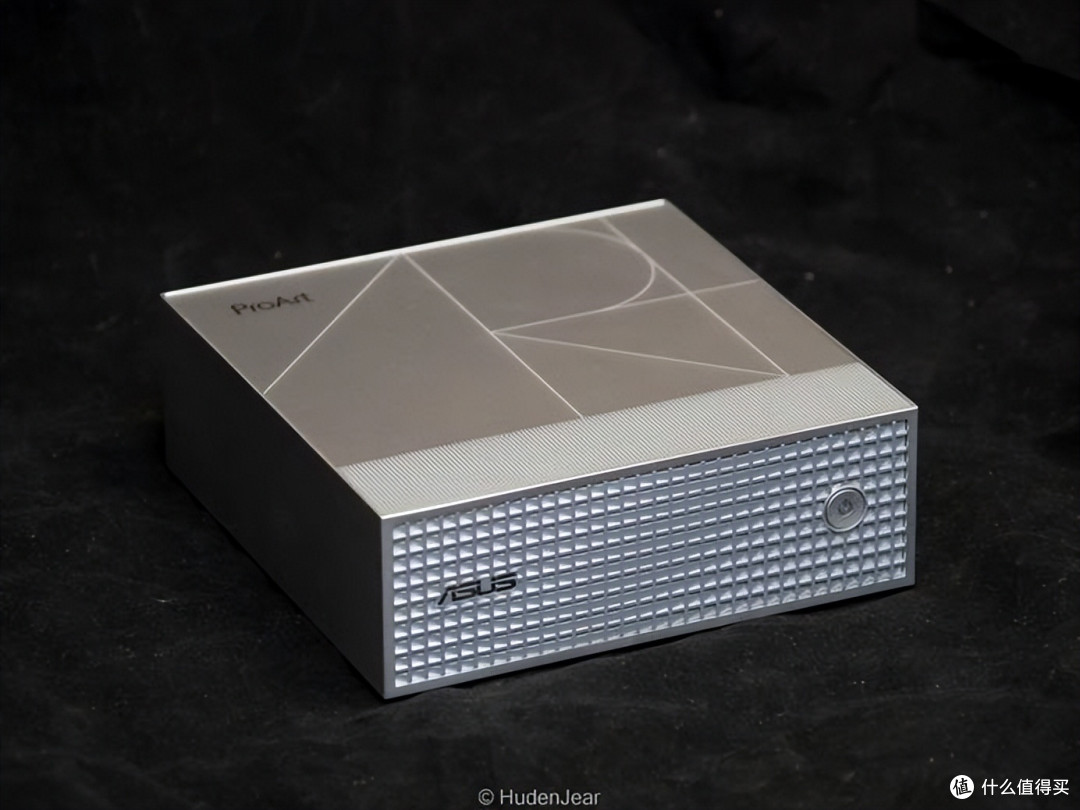
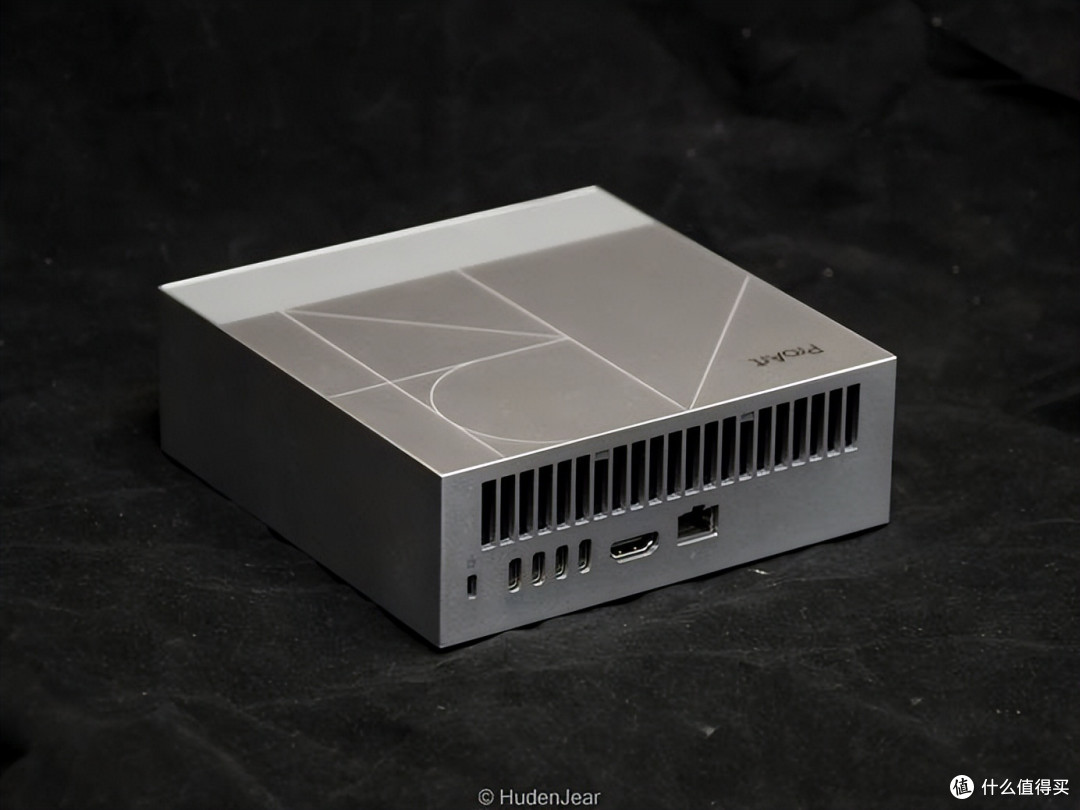
NVIDIA去年推出的桌面AI“个人超算”——DGX Spark(华硕Ascent GX10)发布以来就带来不俗的反响,但是最近由于内存的价格高企,其价格也逐渐被内存容量主导。而 NVIDIA 做出了适当的调整,发布了基于同一个芯片的RTX Spark,推出了内存容量可选,并且把对个人用户用途不大的CX7互联芯片移除,最重要的是支持了Windows,对于普通用户来说可用性大大提升。就在2026年11月18日,华硕正式发布了ProArt GR1X个人迷你AI工作站,这台主机使用类似Ascent GX10那套GB10方案,换用了基于ARM的Windows,NVIDIA将这颗芯片称之为N1x,还有一个稍后推出的N1,64-128 GB 统一内存,从而使其变化为了适合单机家用/小微企业的迷你 AI 工作站。
这一次我也在首发就拿到了这台主机64GB版本,所以作为这台主机的性能展示,我把四件最常见的应用都试了一遍:本地问答、对外提供接口、AI 绘图、AI 视频!正式介绍之前先说一下结论:这台主机的定位可以说是非常精准,正好能跑 40B 以下模型,而且 LLM、图片、视频工作流都能用,尤其是在AI视频生成上优势十分明显,所以我觉得是非常适合单人单机的创作者工具。
硬件规格简介
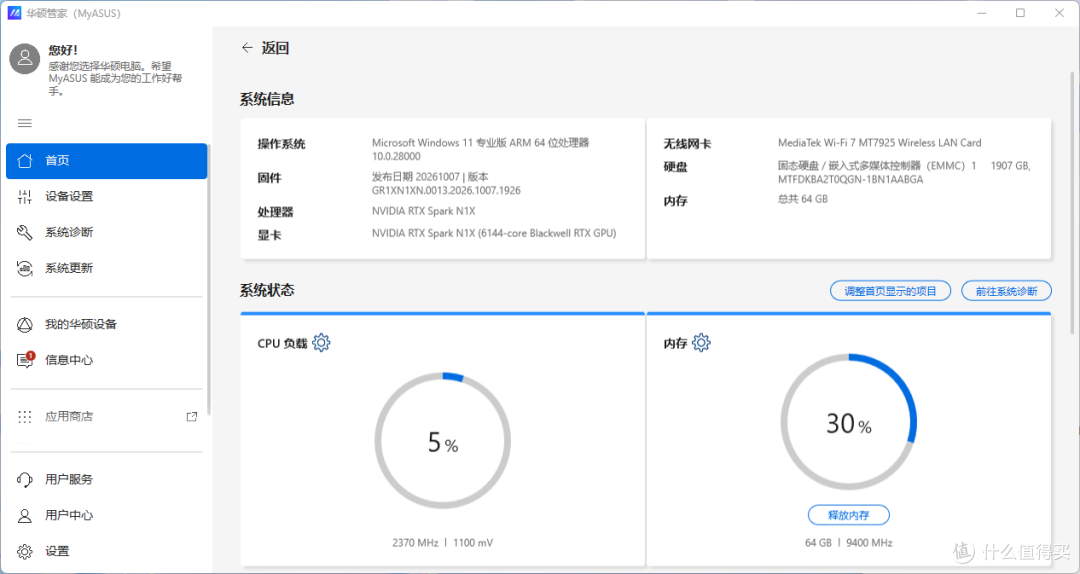
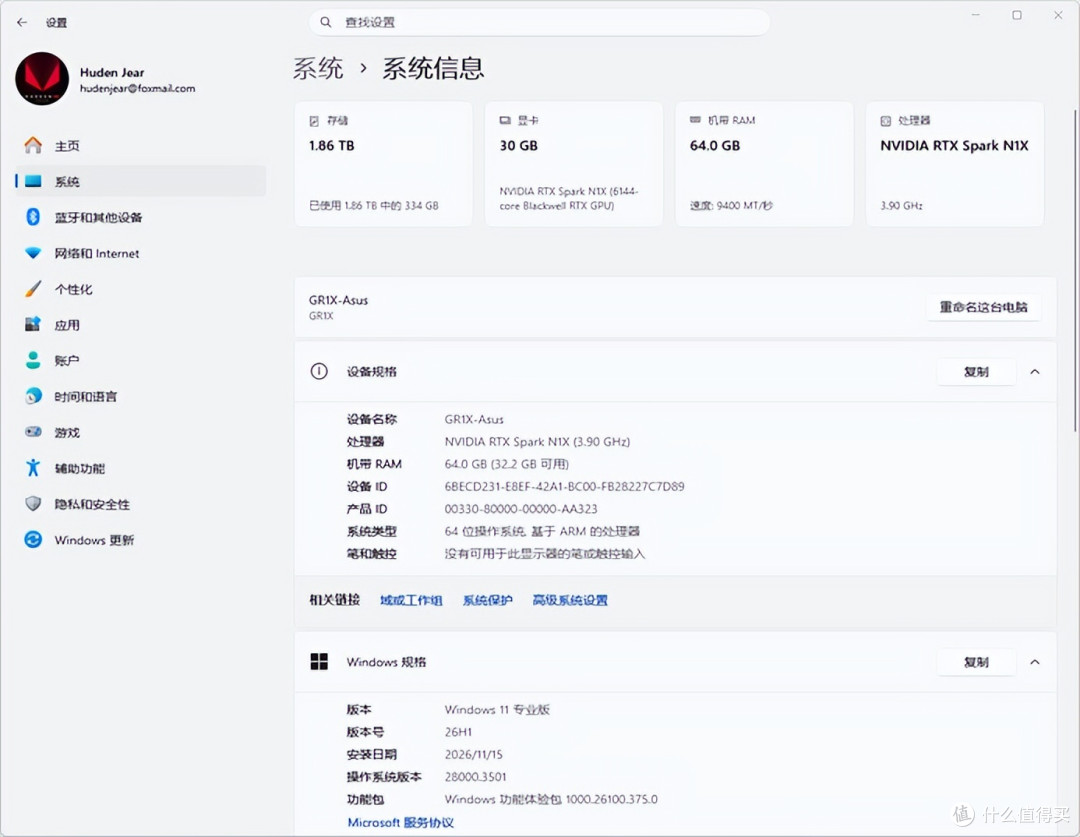
ASUS ProArt GR1X用的N1x超级芯片,CPU 和 GPU 两颗 die 封在一颗芯片上,整机最高可以到140W TDP功耗,比之前发布的RTX Spark笔记本方案都高很多,并且支持全天候运行,可靠性上也不是笔记本电脑能比的。整机共用一组 64 GB 的 LPDDR5X,频率达到了9400MT/s,比DGX Spark更高,统一内存方案可以让GPU 直接吃这块内存,并且支持灵活调整,我在使用的时候一般是48 GB 显存。
这一点其实对本地 AI 来说很关键,跑大模型最怕的就是显存卡脖子,一般稍微好一点的模型容量都在30B左右。这台机器启动 vLLM 的时候空闲 45.63 GB、总量 45.92 GB,按 0.85 的配额就是 39 GB,21 GB 的 27B 权重可以完全进入内存,所以这个64GB的设计非常关键,更大就贵更小就废,算是统一内存的甜蜜点。
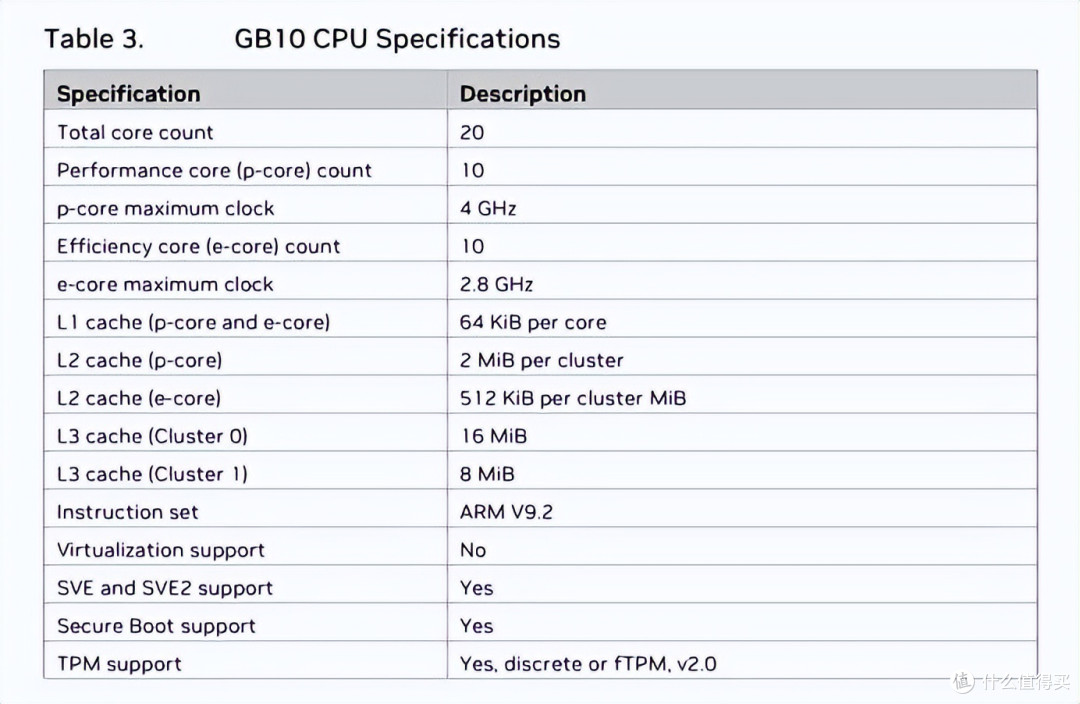
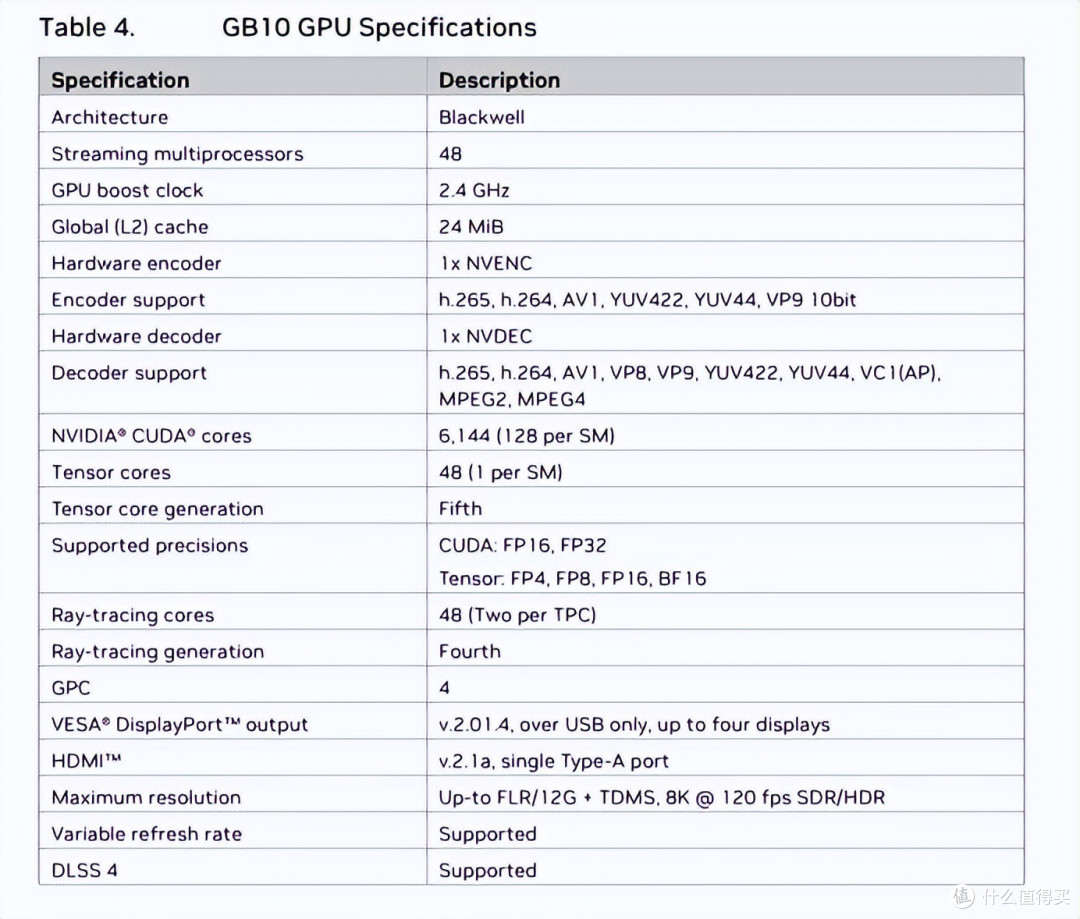
CPU规格上是 20 核 (10 个性能核 4.0 GHz 加 10 个能效核 2.8 GHz,ARMv9.2),GPU 是 Blackwell架构,48 个 SM共6144 个 CUDA 核心,24 MB L2,Boost 2431 MHz,支持目前的主流精度FP4、FP8、FP16、BF16。内存方面使用的是板载 64 GB LPDDR5X 9400 MT/s。不过因为 CPU 架构原因,系统是 Windows 11 专业版 ARM64,个人觉得使用上区别不大,就是安装依赖的时候需要注意一下。
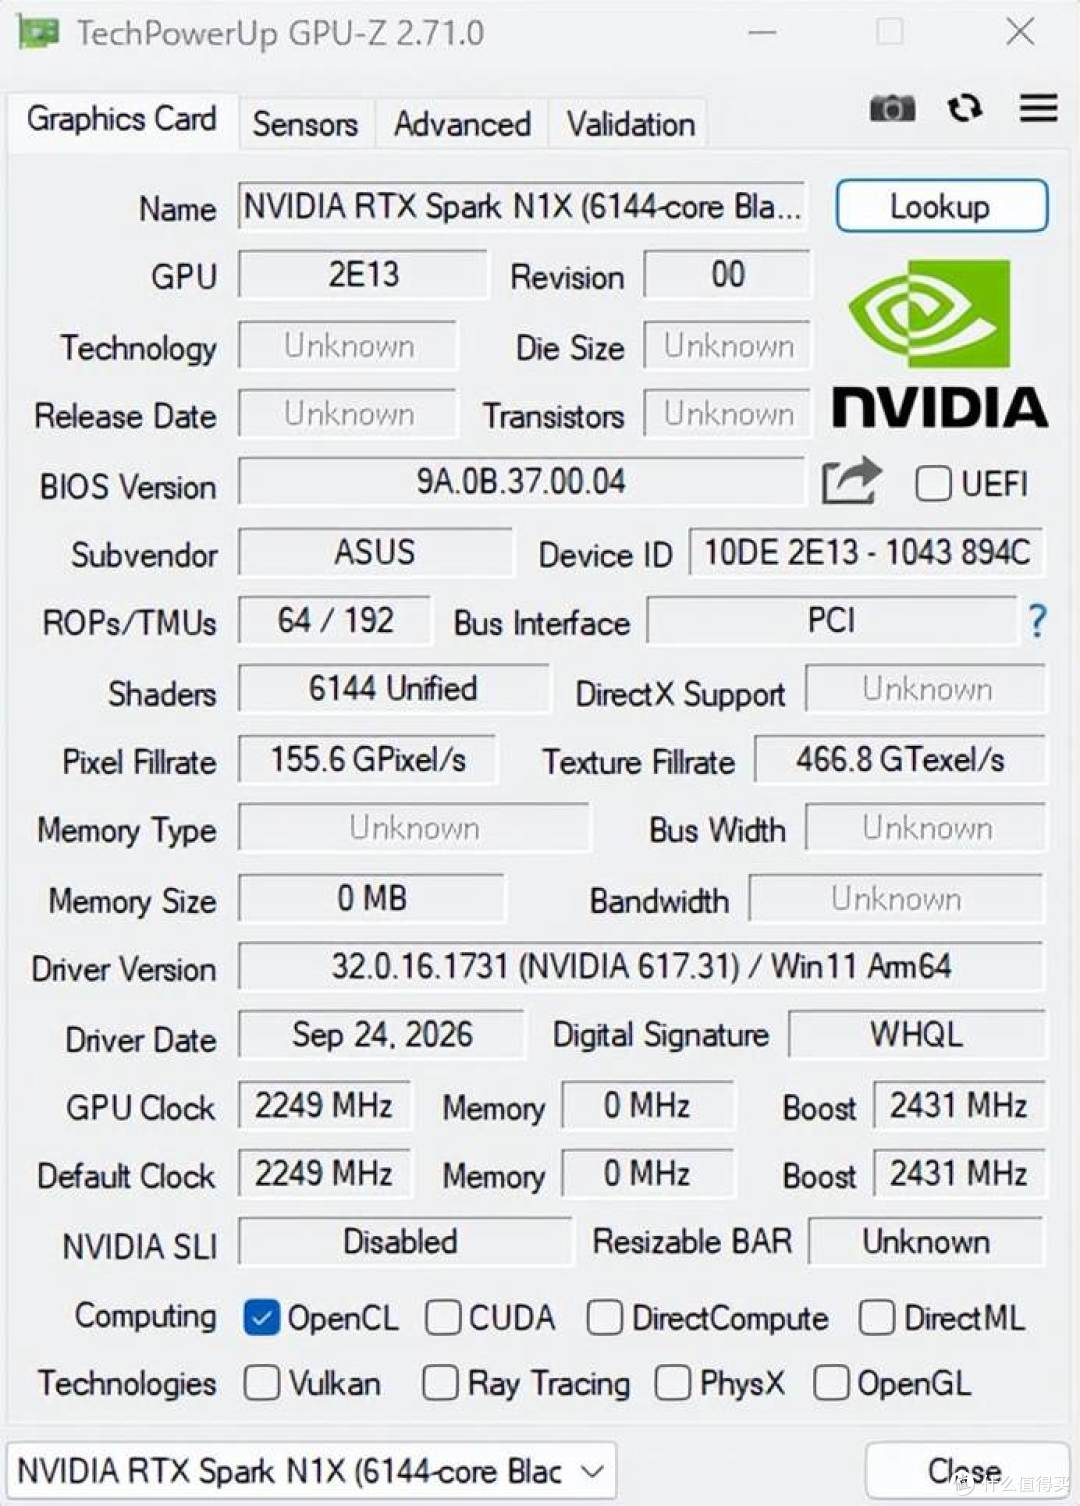
打开 GPU-Z,这个芯片被标记为RTX Spark N1X,规格上,着色单元 6144、默认 2249 MHz、Boost 2431 MHz,和资料里的 GB10 完全对得上,这个核心规格已经达到了桌面显卡RTX5070的规模,可以说是“史上最大核显”了,当然受限于功耗散热以及内存带宽,实际性能不会到桌面卡这么夸张,但也是如今集成显卡的No.1了。个人觉得这个规格没有给X86还是很遗憾的,毕竟Nv没有X86芯片哈哈哈。
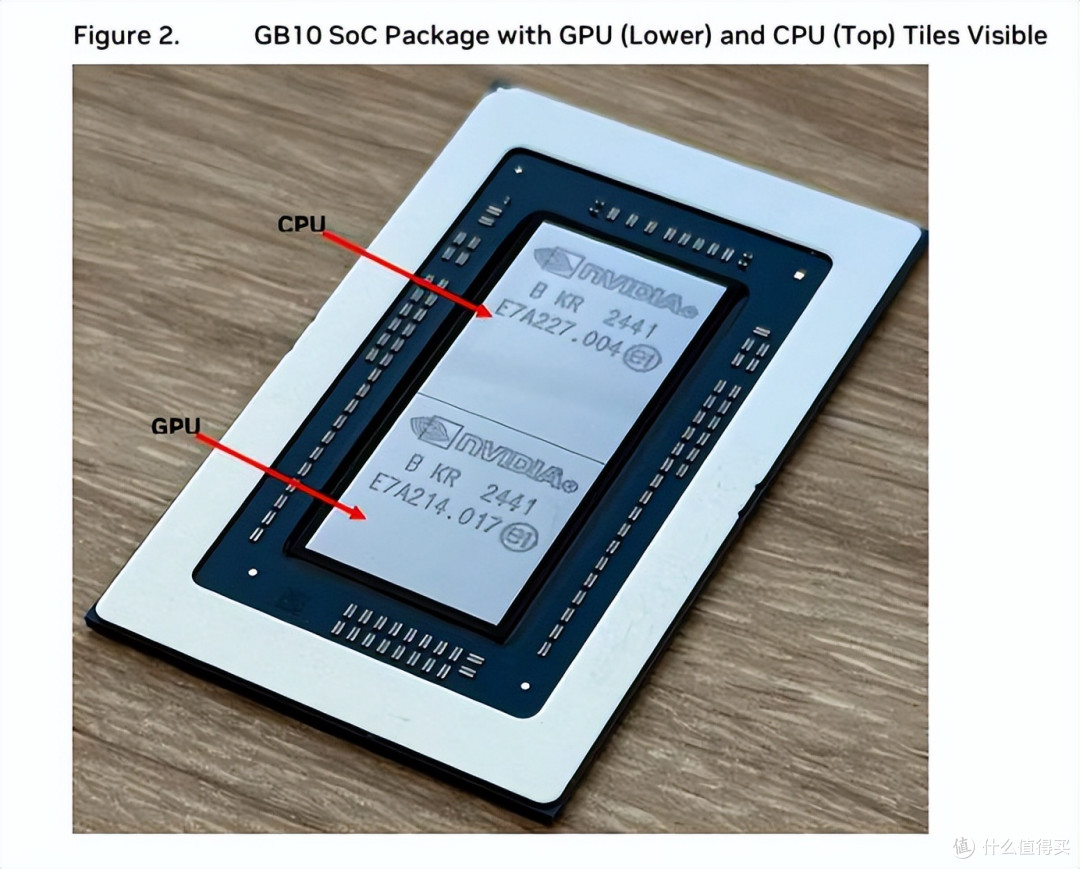
我在网上找到了封装图,两颗 die 贴在同一块基板上,中间共享内存控制器。统一内存用一个内存控制器也正常,而且两个芯片本质上并不是一起制造的,所以良率控制这一块稍微有一些优势
测试资源包
本次测试用的是我整理的包(等我再完善一下就放出来),发布的时候是压缩包,先解压到 C: 根目录,解压完就是 C:AI-artifact 文件夹。因为下面的路径都按这个位置写,所以不建议修改为其他路径,如果要换的话得重写脚本。最外层的 run.py 是全部功能的入口;00-common 放公共的东西,十来个脚本、一份便携的 Python 3.13.9 ARM64 解释器、vLLM 用的 Ubuntu rootfs,还有一个测模型改代码能力用的代码夹具;再往里是四个玩法各占一个子目录,01-llm-llamacpp 放官方编译好的 runtime 和起停脚本,02-llm-vllm 只有脚本、vLLM 本体装在 WSL 里,03-image-flux2 和 04-video 共用一份 ComfyUI,各自带工作流和脚本。另外可以独立下载的东西我都放在包里了,另有一份 to-go 的包,这个只有几百 K,可以下载这个然后自行下载对应的东西。
环境依赖上,我建议编辑器装一个 VS Code,这个启动命令更方便,按照我给的命令直接在 VS Code 项目里的 terminal 运行即可。Python 一定用包里这份便携版或者官网的 ARM64 安装包,Windows 默认给的 python 在 ARM 上有问题。LM Studio 也放在包内了,这个包仅为我个人整合,非官方整理。
用法一:本地 LLM 部署
这是我觉得最轻的一条应用路径,因为本地大模型的工具很多,而且有 GUI,所以使用上非常方便。GGUF 权重丢给 llama.cpp 或者 LM Studio,打开就能聊,没有服务端的概念,也不用管端口和接口。(但是他们都会给出对应的接口,但是并发数量受限,所以单机单用户正好合适)
这次下载了两个模型。gpt-oss-20b 是 MXFP4(12 个 2.4B 的专家),12.1 G,跑起来 69.8 tok/s,因为是 MoE 所以快一点,但是没有达到理论极限。另一个 qwen3.8-27b 是 GGUF,这个模型是目前当代非常能打的小模型,16.6 G,23.5 到 27.5 tok/s,全稠密的参数,所以速度上会慢一截,但回答质量明显更稳,中文写作和代码解释更合适。
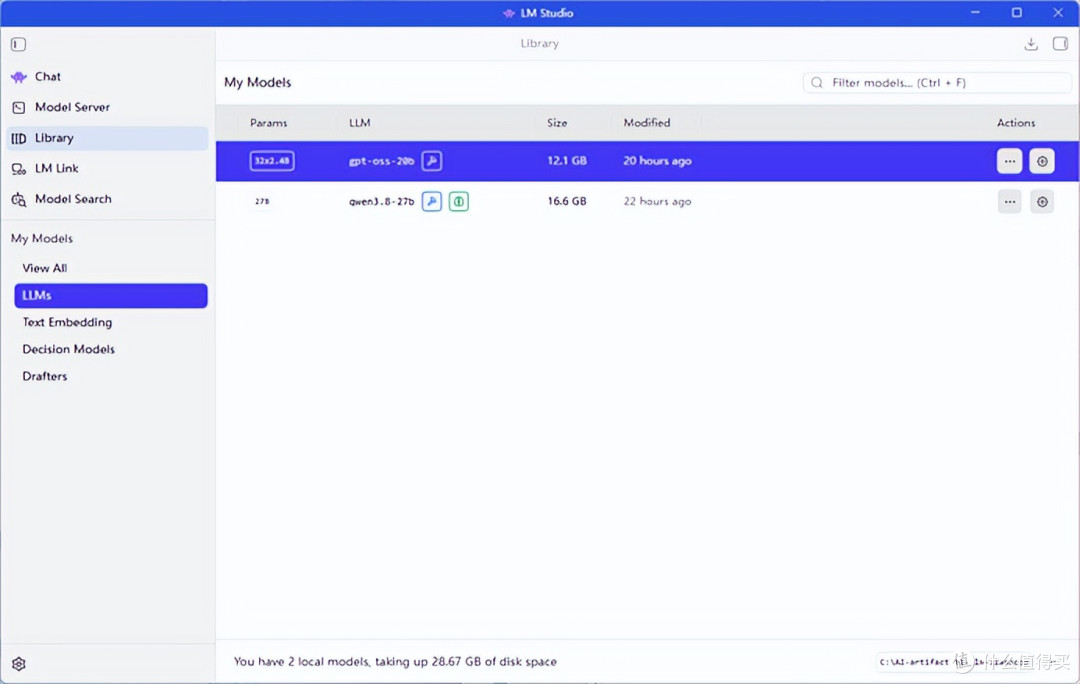
我这里就直接用带 GUI 的 LM Studio 来演示,用法没什么门槛,下载模型,选模型,把 Think 打开(27B 默认就思考,回答前那段推理过程也会一起显示),然后直接提问就行。每条回答下面可以看指标:tok/sec 是解码速度,tokens 是本轮长度,最前面那个数是首 token 延迟,Stop reason 告诉你它是正常说完还是被截断的。
实测 27B 那轮 23.48 tok/s、8128 tokens,最后是被上下文长度顶掉的(Context Length Limit Reached),所以长会话记得开个新的。20B 那轮 69.81 tok/s、2956 tokens,同一台机器上差不多是 27B 的三倍速,按照道理说应该更快的,不过这个速度已经非常能打了,有兴趣的可以换用Qwen3.6 35B A3B。
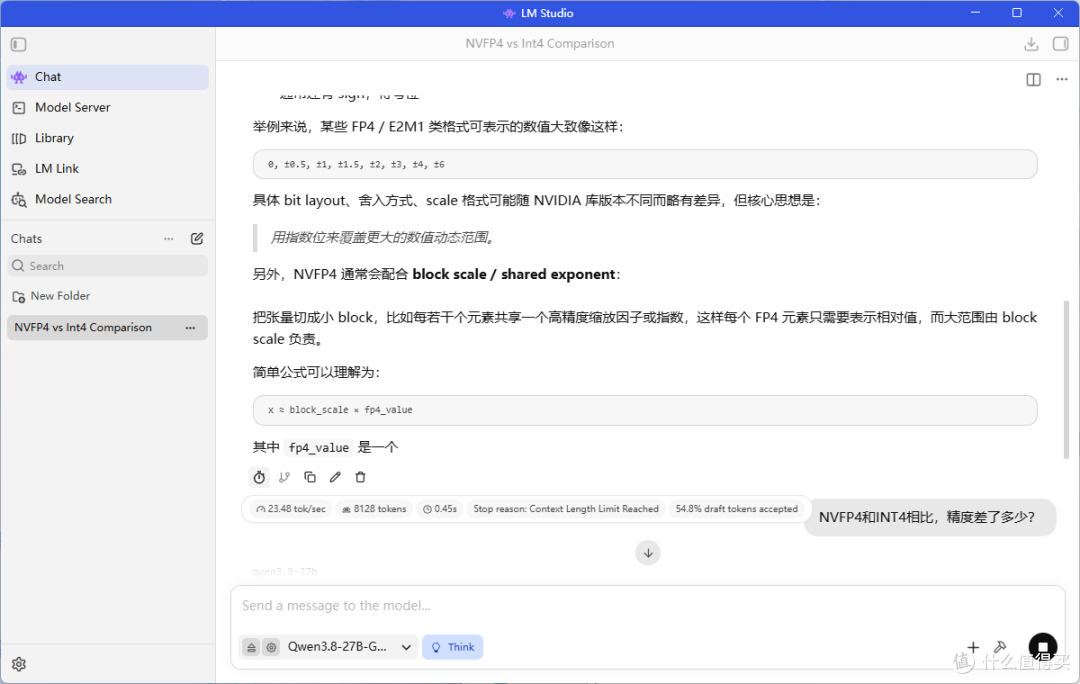
另外27B 那两条记录里带着 draft tokens accepted 54.8% 和 60.9%,这是因为llama cpp内核的LMStudio会默认开投机解码,也就是额外挂了一个草稿模型来猜后面的 token,这个会加速推理。开和不开的 tok/s 完全不是一个口径,不用拿这个数去和下面 vLLM 的 11.5 tps比,因为vllm这个是没开的,而且也不是一个精度,不是一个应用场景,不建议直接对比。
用法二:基于 vLLM 的推理服务
LLM 这个东西,如果你要提供给自己的Code agent,或者要给其他agent调、给 IDE 调、给前端调,我建议换成 vLLM。它直接提供 OpenAI 那套 /v1/chat/completions,流式也有,是目前最标准的一套本地推理框架。
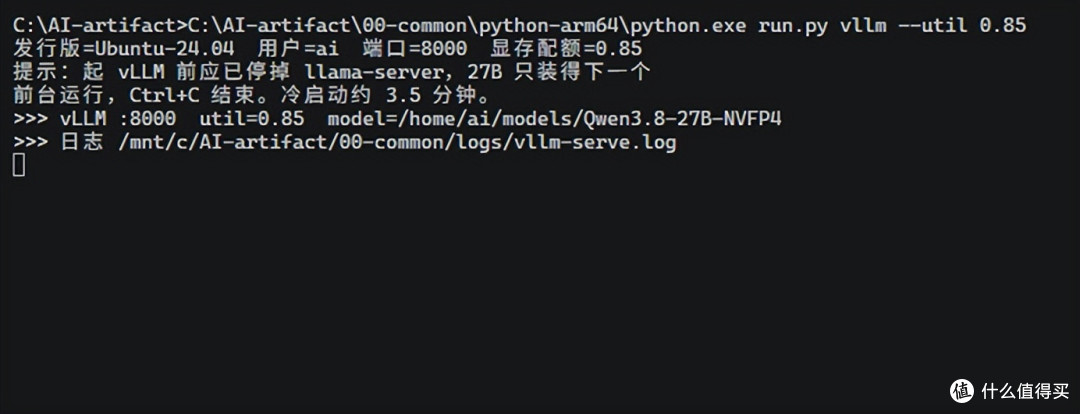
C:AI-artifact0-commonpython-arm64python.exe run.py vllm --util 0.85
冷启动大概 3.5 分钟,需要完整的模型加载CUDA Graph图捕获,启动器会把端口、显存配额、权重路径、日志路径都回显出来。因为 vLLM 最好的使用方式是 Linux,建议装一个 WSL 2,然后把权重放在 WSL 里的 /home/ai/models/Qwen3.8-27B-NVFP4 目录下。
运行的参数,8192 上下文、单卡(tensor_parallel_size=1)、FP8 的 KV 缓存、FlashInfer 注意力后端。倒数第二行是内存预算——启动时空闲 45.63 GiB、总量 45.92 GiB,我给的启动参数,最大使用率0.85,实际分到 39.03 GiB。
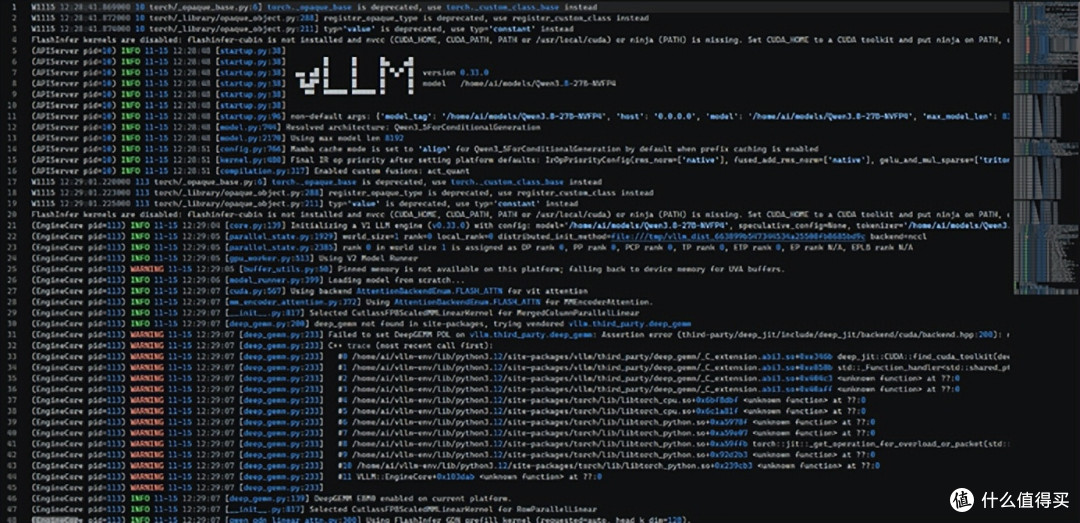
中间那段 19 张 CUDA 计算图的捕获只占 0.13 GiB,属于冷启动里最长的环节。vLLM 和 llama.cpp 最大不同是,它有非常强大的缓存管理能力,如果你的多个请求命中同一个缓存头,就能避免重复prefill,从而加快并发请求速度,因此很适合做sub agent请求的负载终端。
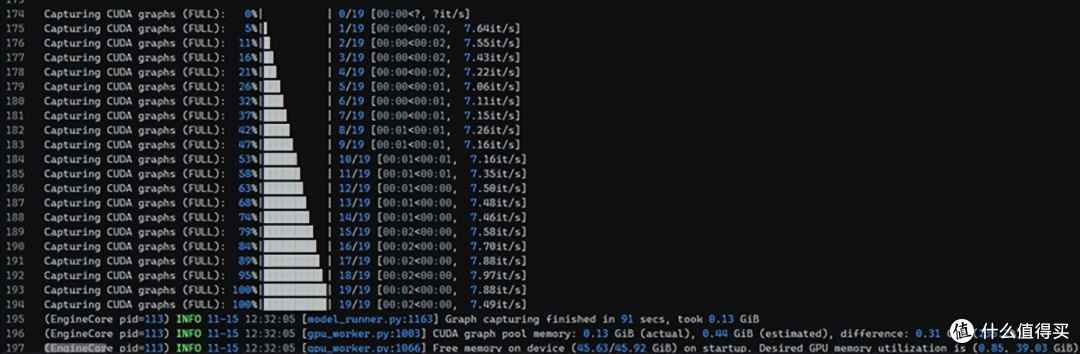
使用下面这个脚本来测试客户端。
C:AI-artifact0-commonpython-arm64python.exe 02-llm-vllmscriptschat.py
测试的时候跑了一轮,输入 69 个 token,TTFT 266ms,解码速度是 11.5 tok/s,前后一共 88.84 秒。TTFT 就是首 token 时间,vllm 这块还是很有优势的。
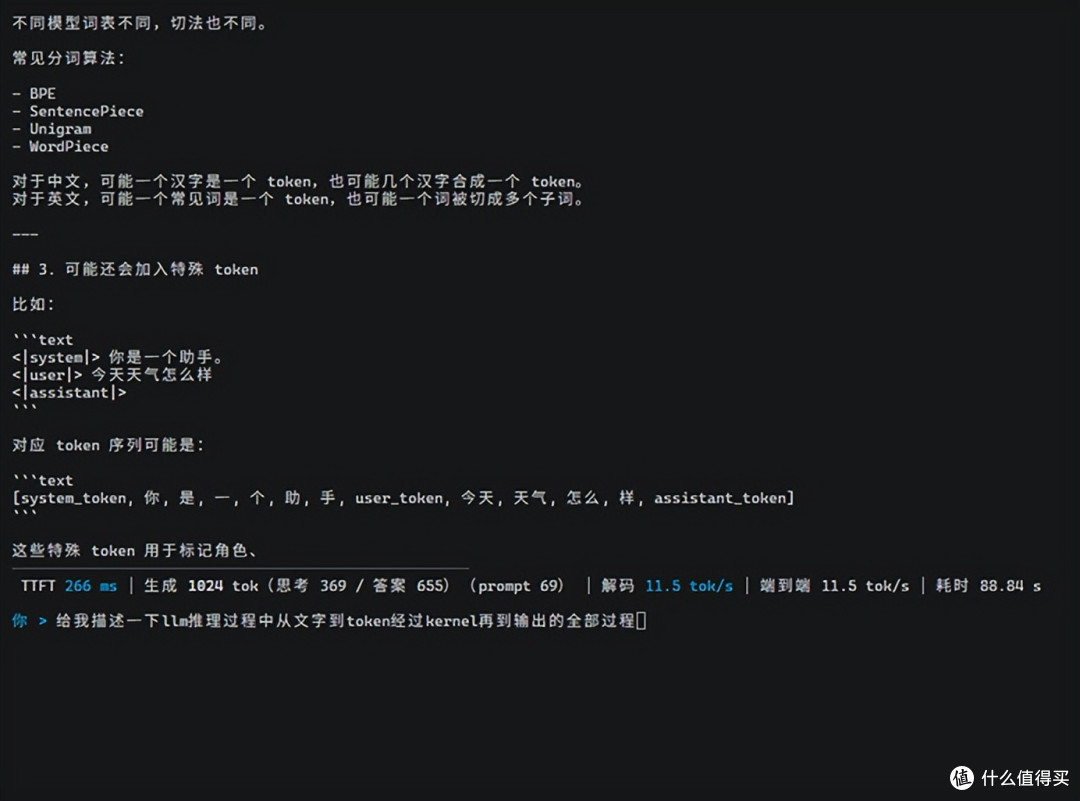
用法三:出图,58 秒一张 1024
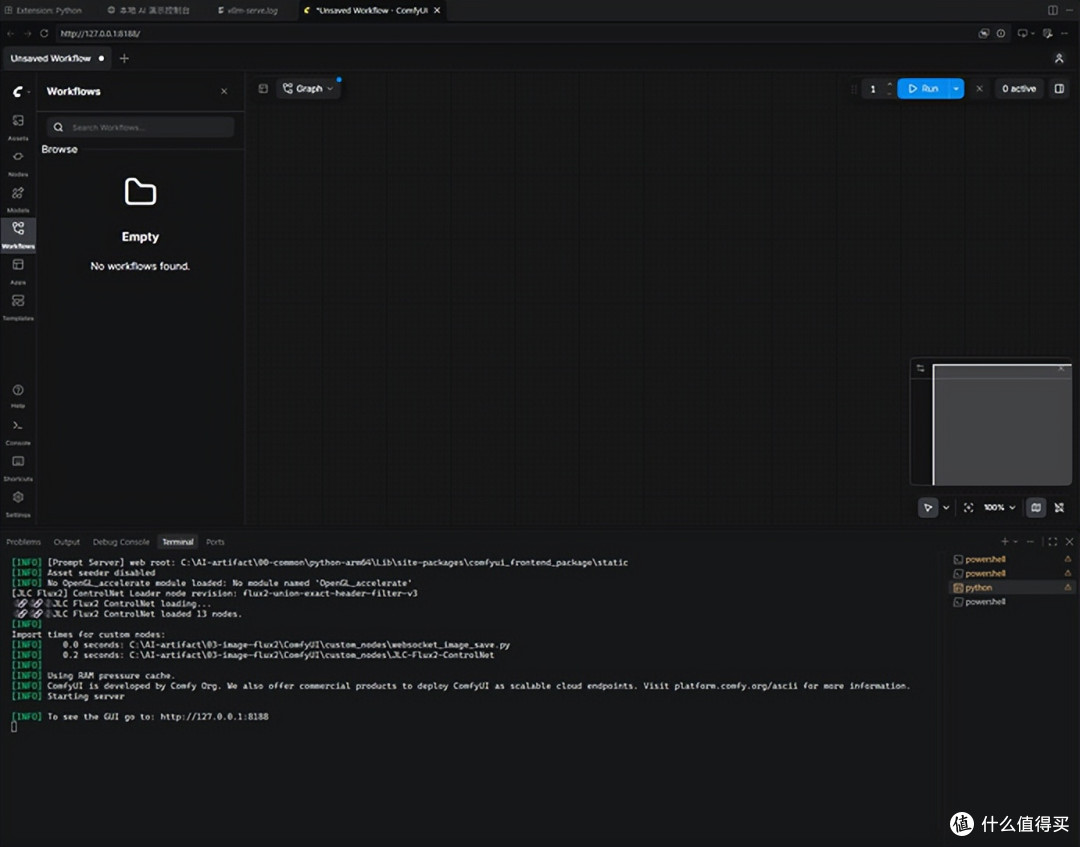
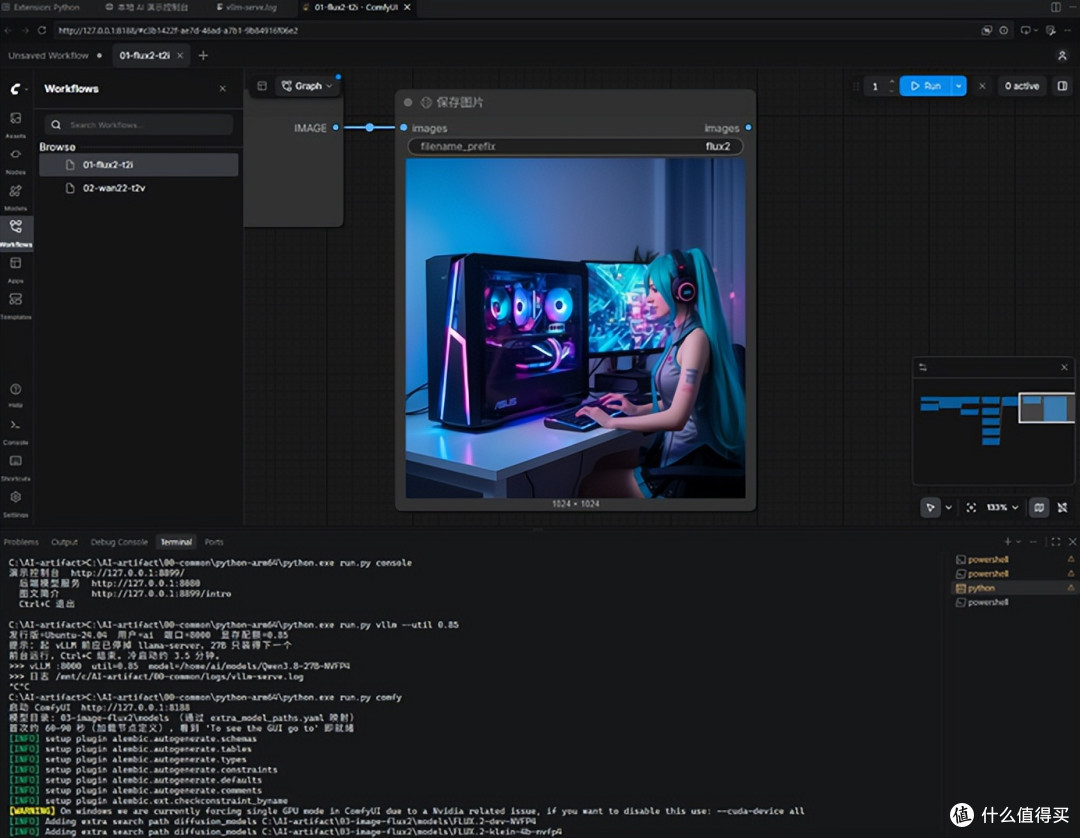
目前图片和视频工作流可以共用同一个 ComfyUI 实例,8188 端口,区别只是换工作流。这个需要单独安装,也可以直接使用包里的comfyUI副本,加载完成了进入localhost的8188就能看到界面。我习惯使用VSCode的webview。
C:AI-artifact0-commonpython-arm64python.exe run.py comfy
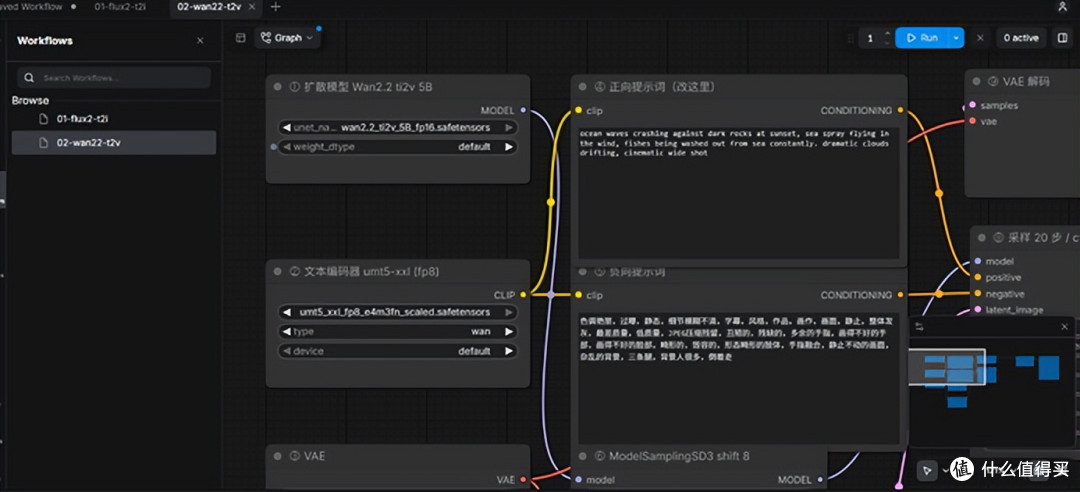
第一次进去左侧 Workflows 是空的,别慌,那是没放 UI 格式的工作流。我把两套预设转成了能直接打开的版本,节点按 ① 到 ⑬ 标了序号,改提示词就能跑。
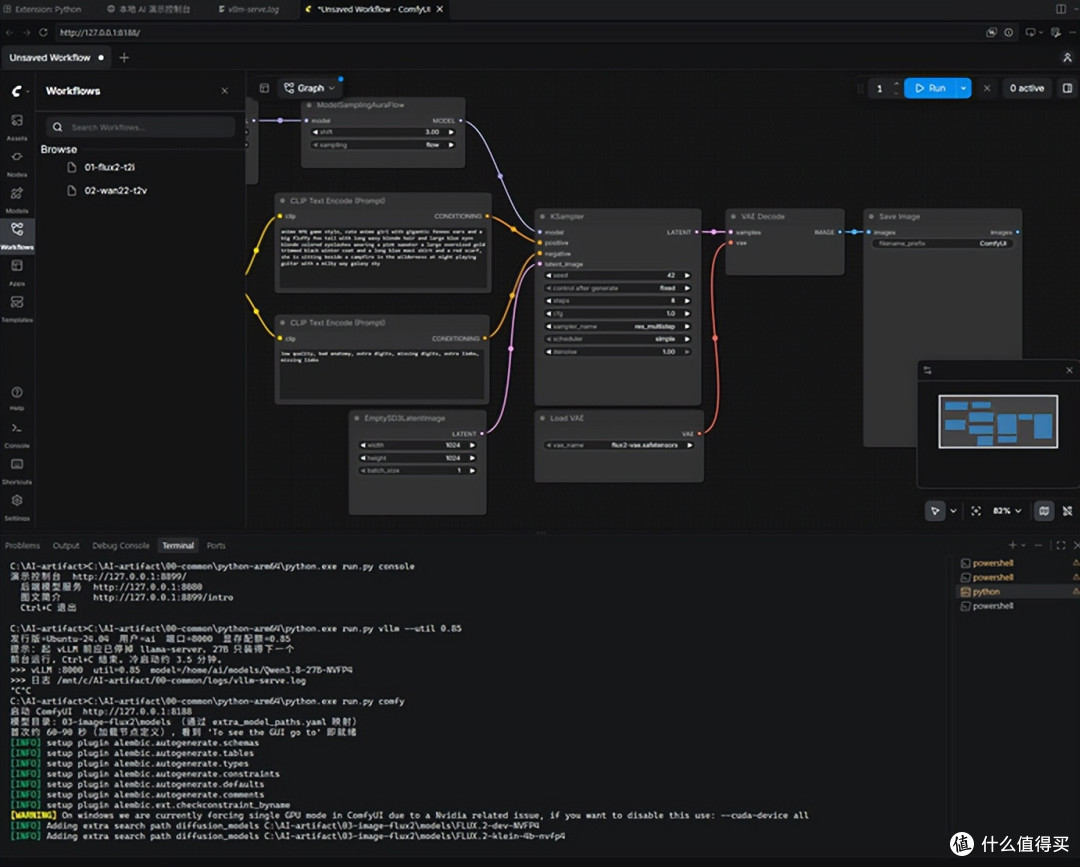
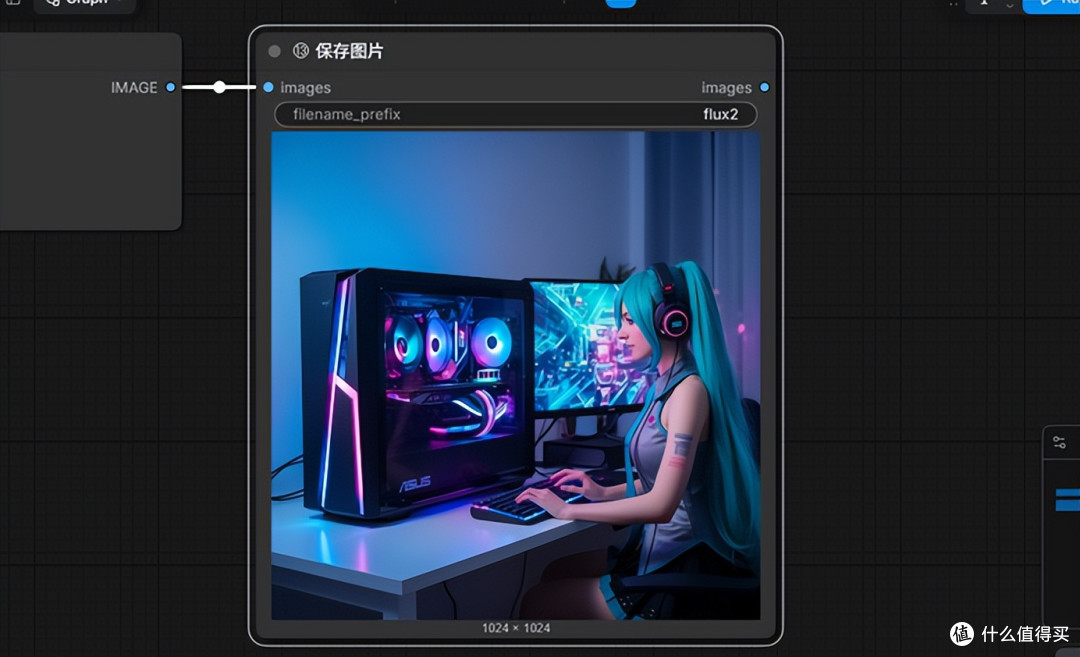
文生图这套是 FLUX.2 dev NVFP4:20 G 主模型,配 12 G 的 mistral 编码器(类型必须选 flux2),VAE 用 flux2-vae,1024×1024,20 步 euler 加 Flux2Scheduler,guidance 4.0。实测一张 58 秒左右。感叹一下现在模型进步速度惊人啊,图里手部、机箱的 RGB 光、玻璃反光都相当不错,这个尺寸的模型能到这个水准,已经能达到创作可用的程度了。不过这些都建立在GR1X这个内存容量下,FLUX2的显存需求不是随便一台机器都能满足的。
用法四:AI 视频 720P 工作流
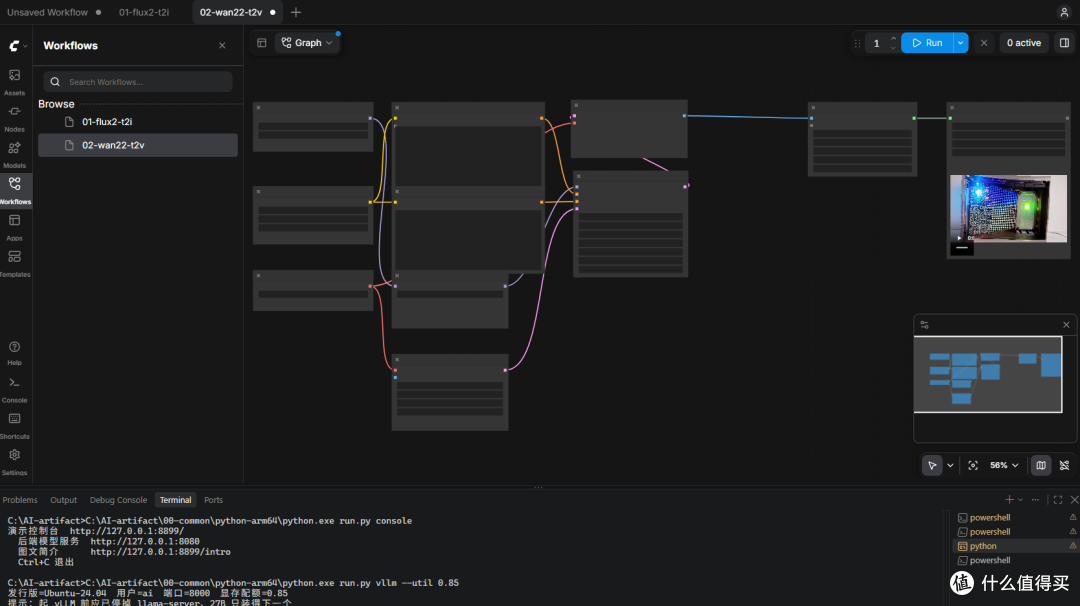
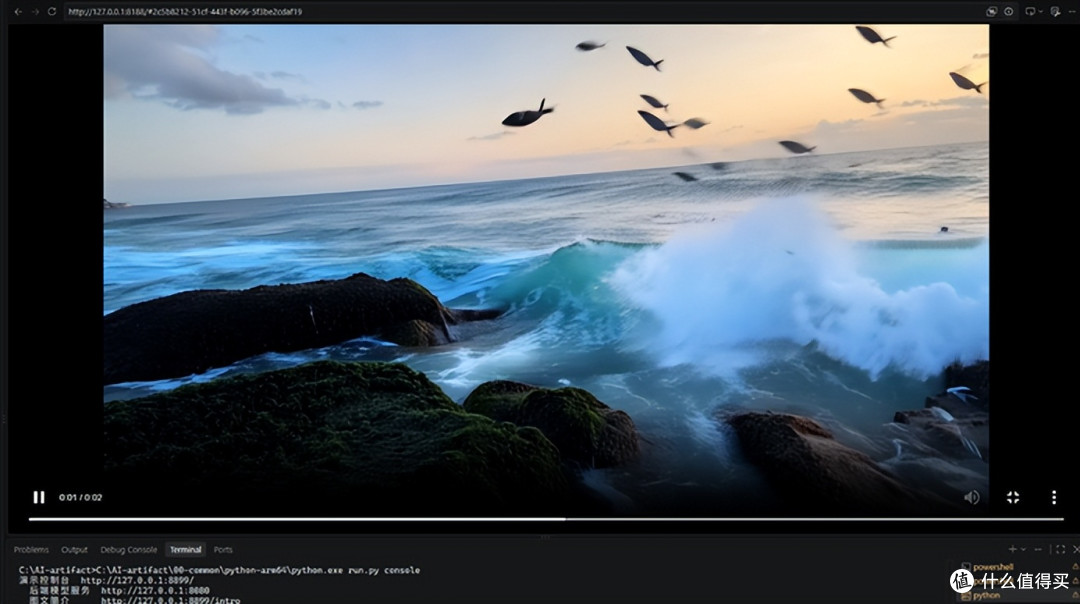
视频工作流是另一套,但是也正如前面说的,都能用 ComfyUI,跟出图共用一个界面,只需要换工作流。模型用的是统一万象的开源权重 wan2.2_ti2v_5B,5 秒左右的片段,一分钟上下能出片,做分镜预演、出素材草图够用了。
参数是 wan2.2_ti2v_5B 的 fp16 权重 9.4 G,配 umt5-xxl 的 fp8 编码器 6.3 G 和 wan2.2_vae,1280×720,61 帧,20 步 uni_pc,simple 调度,cfg 5.0,shift 8.0,出 h264 的 mp4,24 fps。这个视频总时间基本就1min,速度可以说是相当不错了。而现在一般的PC想要实现视频生成,光是显存的硬需求就无法被满足,上述这些组件加起来就超过了16G,大于16G显存的显卡价格现在都快超过现在GR1X单机了。而且GR1X构建视频工作流是完全可以和超分辨率工作流一起使用的,所以可以轻松超分到2K或者4K视频,因为显存大就是可以为所欲为,再放下一个SR的model,一个StyleGan或者一个controlNet都不是问题。有了这些工具,对于视频内容的掌控力要强很多,能避免直接使用提示词+线上API的无规律抽奖。
出片之后浏览器里直接就能播,不用另存再打开核对。如果想快一点做预览的话,可以先降低分辨率,降低总帧数。
WOA的体验
另外我想谈一下这个机器直接使用的感受,因为这个机器默认是Windows On Arm也就是非x86系统,不过我感觉现在WOA的优化也相当不错了,我在使用的过程中完全没有卡顿,CPU本身性能是足够的,Arm9.2的10大10小总共20核的规模完全能够媲美苹果的M5,原生单核多核性能都在目前CPU的第一档。同时这个芯片从规模上说已经超过了RTX5070Ti Laptop,再加上最高可以划分到48/96GB的超级大显存,直接拿来做视频编码解码也是可行的,所以即是不专注AI,这台机器也是一台足够强大的桌面工作站。再加上有高频64GB LPDDR5X的加持,这台主机基本能胜任传统工作站的所有应用。
目前WOA的生态我感觉还不错,因为很多软件都已经做了WOA适配,我平时用的编程开发,基准测试,包括聊天软件其实都有。我个人感觉使用上和X86没有太大区别了。
总结
华硕ProArt GR1X这台机器的定位我认为就是单机单用户在独立工作时的AI终端,尤其是在AI视频生成方面还是有一些优势的,普通PC很难轻易拿出48GB这个量级的显存来,同时GR1X的功耗很低,持续运行时只有100W出头,在视频生成这种需要长时间连续工作的工况下,更低的功耗和发热能明显减少长期投入,同时ProArt GR1X的全天候设计运行起来也远比普通台式机和笔记本更加可靠。
这台机器的造型设计非常不错,大小合适放桌上,放在桌面赏心悦目,和傻大黑粗的工作站一比堪称优雅。机器的功耗也低,散热不吵,WOA在使用上和一般的常规windows没有区别,GPU性能基本就是靠近5070 Laptop单卡这个水平,而显存最大48G处于甜蜜区间,中等大小的LLM模型和FLUX2这样比较大的文生图模型也可以顺畅运行。在文生视频上,生成视频完成没有问题,720P的速度也不慢。也能配合其他组件一起玩,给视频生成带来更多可控的或者提升质量的功能,潜力超同价格的桌面单卡主机。而且架构上,这个机器的芯片原生支持NVFP4格式,支持这个格式能赚到不少推理速度,买新不买旧的原则在AI硬件尤为重要。
不过我觉得这个机器也有一些问题。一个就是老生常谈的统一内存共享带宽,解码速度受限于带宽大小,越是大稠密模型越慢,所以建议最大就 27B 的 Qwen3.8 了,再大最好用 MOE 模型。图片和视频工作流就不受这个限制,内容创作者福音了属于是。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~
当前文章无评论,是时候发表评论了