这个场景你大概率经历过:吭哧吭哧改了一下午提示词,随手问了个问题,答得比以前顺——满意,上线。三天后有人来告诉你,昨天还能答对的问题,今天答错了。你盯着改动记录,说不出哪里变了,更证明不了它"确实变好了"。哔哩哔哩
凭感觉改提示词,是现在大多数人的真实状态。而真正上道的提示词玩家,早就把问题换了:不再是"怎么写得像模像样",而是"我改了,怎么知道它变好了?"
把提示词当代码,它得能"跑测试"
知乎上有从业者把话挑明了:提示词不是写作文,是配置,实战里翻车十次有八次是管理问题不是措辞问题,其中最贵的坑就是改完没跑回归测试、上线才发现旧场景全坏了。B站一个LLM应用开发系列,连标题都是这个要求:改提示词,并且知道它真的变好了。知乎哔哩哔哩
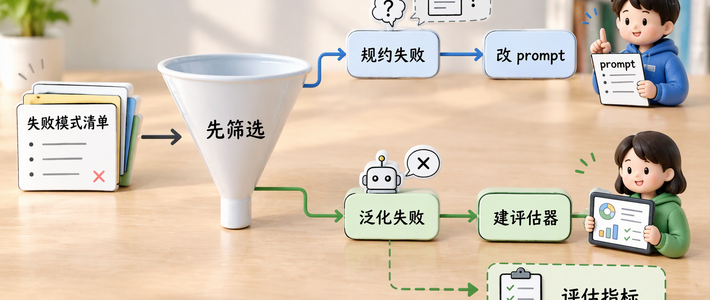
测试集怎么建?五步,没有玄学:
攒真题:30到50条就够,别追求上千条却没人跑。知乎哔哩哔哩
分场景:常规问答、边界输入、该调工具的、该拒答的,四类都要有;
定判定:能用规则判的(必须含某字段、不许带敏感词)就用规则,判不了的才用模型打分,两套混着用;
锁环境:模型版本、提示词版本、知识库版本全部记录,不然这次和上次比的根本不是同一个东西;
设门槛:通过率低于基线就不许合入,和代码单测一个道理。
还有个容易漏的细节:分数掉了,要去看失败样本,别只盯数字——掉的那两个点挂在哪几条、卡在哪一步,这才是评测真正的价值。哔哩哔哩
尺子也会撒谎:换个顺序,82.5%的答案翻了
"我让强模型当裁判给答案打分,总行了吧?“一位B站UP主的实测很泼冷水:同一批80道题,只把两个候选答案的顺序对调,66道判反,翻转率82.5%;选项A被选中概率34.6%,排到D就只剩15.8%——它读的不是内容,是位置,在"给字母下注”。哔哩哔哩
解法也不神秘:别让模型二选一,改成一次只看一个答案,按维度逐项打0或1,最后加总。这一换,跨模型一致率提升了0.45。你看,连打分方式都要做工程,不确定的从来不只是提示词。哔哩哔哩
企业已经靠这套方法吃到红利
这不是个人玩家的自嗨。Brainbase Labs做的达美乐竞品价格追踪项目,第一版准确率只有41%,到第11版拉到97%,全程没换模型——换的是术语定义、评估基准和执行轨迹上的定向修复,顺带把单源成本从2美元砍到1美元、耗时从129分钟缩到71分钟。模型没升级,是"打分"升级了。哔哩哔哩
今天就能上手的事
不用建平台,就三步:把用户(和你自己)真实问过的问题攒进表格,先跑20条;改之前跑一遍、改之后跑一遍;只看失败样本,不凭体感合入。想系统学评测,可以把Anthropic官方的 Introduction to Evals 评估入门课过一遍。先别急着花钱买课。哔哩哔哩
提示词的措辞可以慢慢磨,但尺子得先立起来。不然你说的"变好了",只是感觉,不是事实。