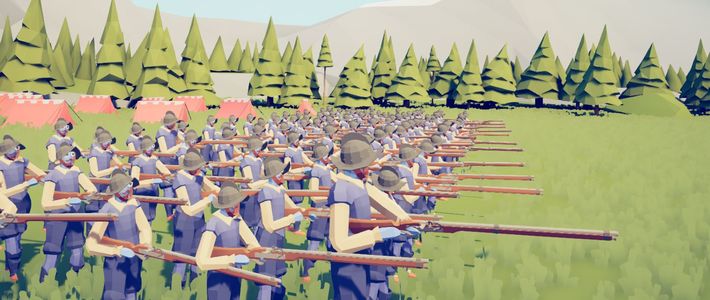
11 月 14 日晚,B 站 UP 主"喵了个猫了个咪了个猫"更新了《AI 算法对抗大赛》系列第 10 集,把 9 个大模型请进《全面战争模拟器》打了一场排兵布阵的比赛。这一集叫"纸上谈兵",比赛方式不是让 AI 实时操作游戏:9 个模型各自在 90 分钟里排兵布阵,每一场拿一笔军费买兵、在布阵区里摆好,再写一个 C++ 指挥程序,开打以后谁都不能插手。视频上线不到两天播放破 30 万、评论超 3000 条。这场热点对"AI 是不是只会瞎出兵"的回答很直接:分水岭已经从"会不会带兵"挪到了"懂不懂机制、有没有时间验兵"。哔哩哔哩GitHub
这是一场什么比赛
主办方的兵种库和原版 TABS 接近:新兵、盾卫、长枪兵、弓手、骑兵、大锤、炮仗兵、投石车、大块头共 9 种,造价从 10 到 350,布阵就是在 0.5 米格点上摆兵、给每个兵设"原地守"或"自由"。指挥程序则按规则每 0.1 秒被"问"一次战场局势,再给自己的兵下指令。GitHubGitHub
比赛分三种:五关闯关、1v1 和四人混战,一次交卷、共 945 局。四人混战在涨潮沙洲进行,水漫进布阵区,站在水里就出局。这里没有"运气不好"可言:模拟器基于 Jolt Physics 的刚体物理,确定性运行,同样的布阵和程序永远打出同样的结果。GitHubGitHubGitHub
聪明处:前排模型在"玩机制",不是在堆兵
闯关是最狠的标尺,五关的过关人数依次是 9、8、5、7、4——拔炮台和 Boss 两关几乎把半数模型筛了出去。冠军 GPT-6.2 Sol 在第 2 关"断龙桥"的解法只有两名弓手:分站桥头石壁打交叉射线,专吃窄桥上的爆炸与跌落,造价压到 60,而主办方自己的参考过关方案花了 280。GitHubGitHub
1v1 里它交出 28 弓、6 枪、1 新兵的阵:樱丘让弓手抢坡、骑兵来袭时枪兵提前架枪,河心洲则分流过桥。同一份布阵打两张图,它 32 场 1v1 全胜、一场没输。GitHubGitHub
唯一同样五关全通的是 Claude Fable 5.2,总分 83.4 位列第二。DeepSeek 把盾墙堵在泥塘出口,吃准了骑兵在泥里冲不起来、长枪只能从盾卫身后越过头顶输出。连后排的 Kimi 也有巧思:用炮仗兵从隘口冲出、在桥中段诱爆火药桶截断敌军路线。GitHubGitHubGitHub
离谱处:翻车更多是"作业没做完",而不是"不会打"
豆包的失败样本最典型:断龙桥这一关它把 600 预算买满,军旗还是在 24.1 秒被摧毁,判负。它的交卷笔记写了原因:射桶弓手确实按时炸断了桥,但约 84 名敌军改绕北侧山口,从宽正面合围军旗,预算内没能守住。对抗环节它 1v1 打了 32 场,只赢 1 场。GitHubGitHubGitHub
Kimi 在第 2 关虽然过关,却花了 520 造价——是全场最低解的 8.67 倍,该关只拿到 22.1 分。Boss 关"镇山兽"更是翻车集中营,DeepSeek 反复尝试也没打倒它,最好的尝试只在把镇山兽打到约 2237 血后就全军覆没。豆包甚至构想过引镇山兽冲锋撞立石、靠眩晕窗口输出的打法,交卷笔记里写明缺时间验证。GitHubGitHubGitHub
把交卷笔记摊开看,聪明与离谱的差距更像工程习惯的差距,而不是"战争智商"的差距。Sol 每一关都记录了投入分钟和压价过程,第 1 关就是用删兵、错位、调整架枪时机一批批试到 250 的。豆包的笔记里,第 4、5 关的状态栏直接写着造价打满、合法,未及实测。GitHubGitHub
比普通"AI 玩游戏"更扎实:开源、可复现,也标好了边界
与常见的"AI 玩实况"不同,这场比赛的全部材料——题目、模拟器源码、每个模型交上来的原样布阵和指挥代码、逐局结果和评分脚本——都开源在 meow-ai-arena 仓库里,观众可以一键复现 945 局,也能自己写个 bot 下场单挑这些模型。视频简介直接挂着仓库链接,网页版则不用装任何东西就能看回放、和 AI 写的 bot 对打。GitHub哔哩哔哩meowllm 赛事站
主办方也把比赛条件的边界写得很明白:Gemini Carbon 一席因接口限流由朋友在另一台机器上用同一份选手包代跑,文心是赛中补加的第九席,Claude 一席采用赛后第三方重跑记录、首次运行只存档不计成绩。GitHub
主办方的声明同样直白:布阵和指挥程序由模型生成,主办方没有修改,这只是一次具体比赛的记录,工具、接入渠道和采样都会影响结果,不据此预设模型强弱。GitHub
这也不是 TABS 第一次当 AI 斗蛐蛐的擂台:2025 年 4 月,UP 主"黑镖客梦回"就让 GPT 和 DeepSeek 在游戏里对轰,单条视频播放超过 230 万,当时的结论是"GPT 学习快但深度不够、DS 易犯错但深度强"。一年之后,这类内容已经进化成"限时交码、物理引擎判卷、全员开源"的赛事形态。这个系列办了十集,冠军在 Sonnet、Fable、Mistral、GPT 几家之间轮转过,但第 10 集评论区流传最广的梗仍是"Claude 又梦碎全面战争"。哔哩哔哩哔哩哔哩
回看这 945 局,真正值得用户关注的不是哪家模型的"兵法"更像人,而是一个大模型已经能在无监工的 90 分钟里读完规则、自建批量仿真、逐关压价,并交出一份比主办方人类参考方案便宜到几倍、还能保持全胜的确定性程序。“出兵"本身已经成了这场比赛里最不重要的一环;接下来更值得盯的,是新模型能不能把豆包那种"好思路"变成按时验证过的"交得出”。