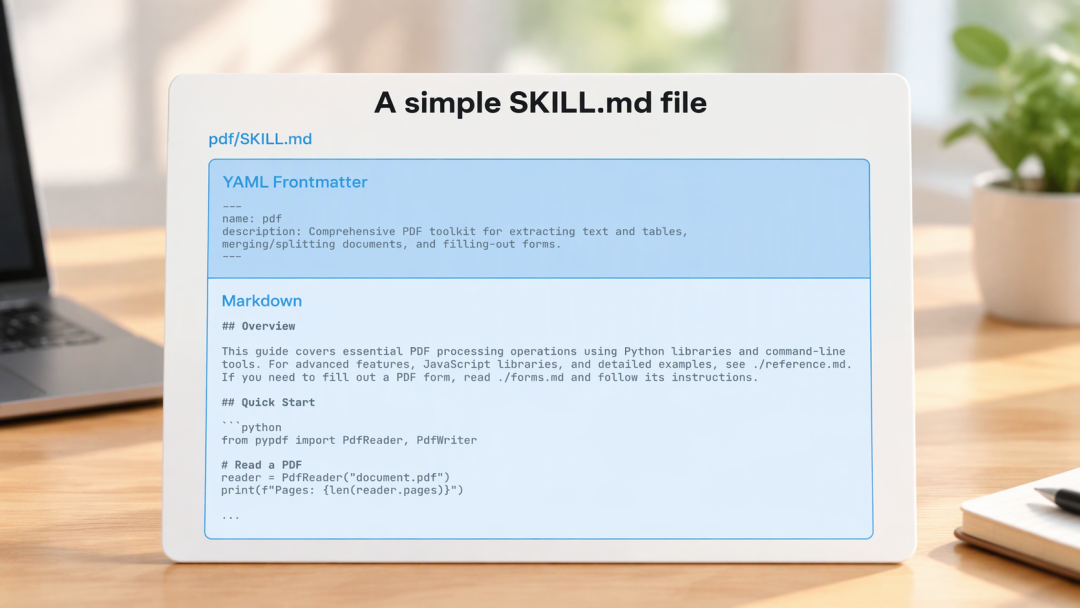
这一届 LLM 应用开发圈最常见的抱怨就五个字:装了 Skill,不触发。SKILL.md 按官方规范写得规规矩矩,流程图、参数、执行逻辑一应俱全,结果对话框里一说话,模型照常泛泛应答,Skill 纹丝不动。
先别急着重写正文——卡点很可能不在正文,在 description 那一行。
 https://tmpf.smzdm.com/202611/16/6afae1241dd046779.png
为什么?模型看到的只是你的"目录"
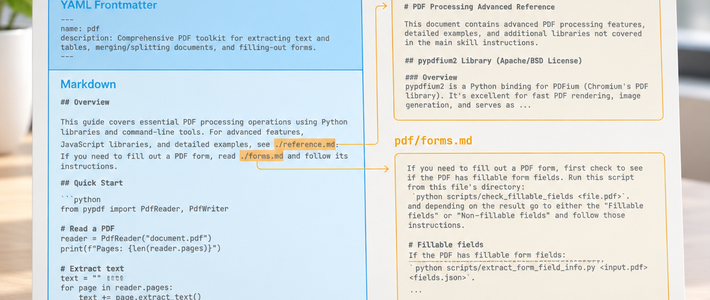
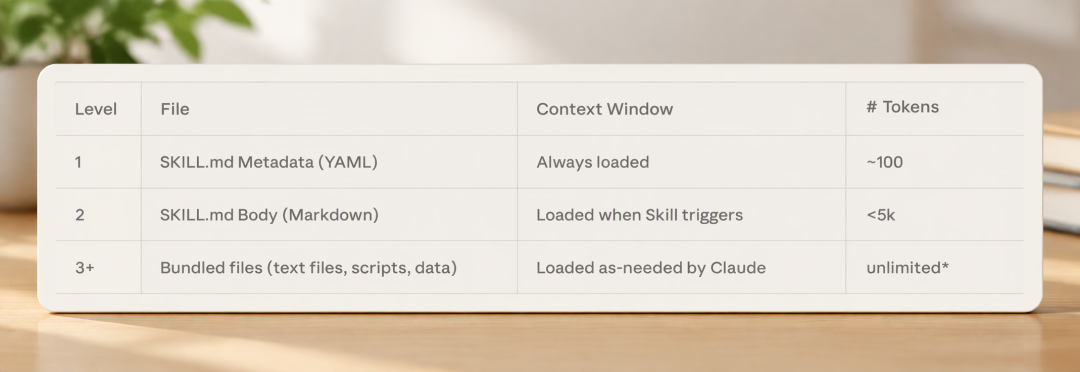
Claude Code 用的是渐进式披露:默认会话启动时,它不会把全局或项目下所有 Skill 的正文全量塞进系统上下文——十几个、每个动辄数百行,一开局就会消耗大量上下文 tokens,并稀释模型的注意力,启动阶段仅读取 frontmatter 里的 name 与 description 作为轻量索引常驻。知乎
只有当你的输入意图、操作动词或关键词命中了 description,或者显式输入斜杠命令时,才会加载正文;agent 先只读 SKILL.md,需要什么再打开对应的 references/。知乎知乎
所以 description 不是 README,是模型能搜到的门牌号,写得像泛化的功能概述、缺少具体的用户意图动词与高频提问词,模型在路由决策时往往会判定"普通问答能力即可应答",直接跳过你的 Skill。知乎
 https://tmpf.smzdm.com/202611/16/6afae13b945899152.png
怎么写?两个可以直接抄的工程样例
第一个是 unslop,专治"AI 味"界面:紫蓝渐变糊满按钮、导航项蹲着 emoji、标题写着 Welcome back。作者 10 月 29 日把方法开源,到今天 GitHub 已经冲到近 1.4 万 Star。它的玩法是动手之前先看屏——有源码读源码,能跑就先截图,再对着内置的症状清单逐条过,把每一处 AI 味标出来长在哪个组件里;屏幕本来就不错就直接认,最多给两三条带数值的微调,永远不为了显本事去改一个本来就好的屏。知乎
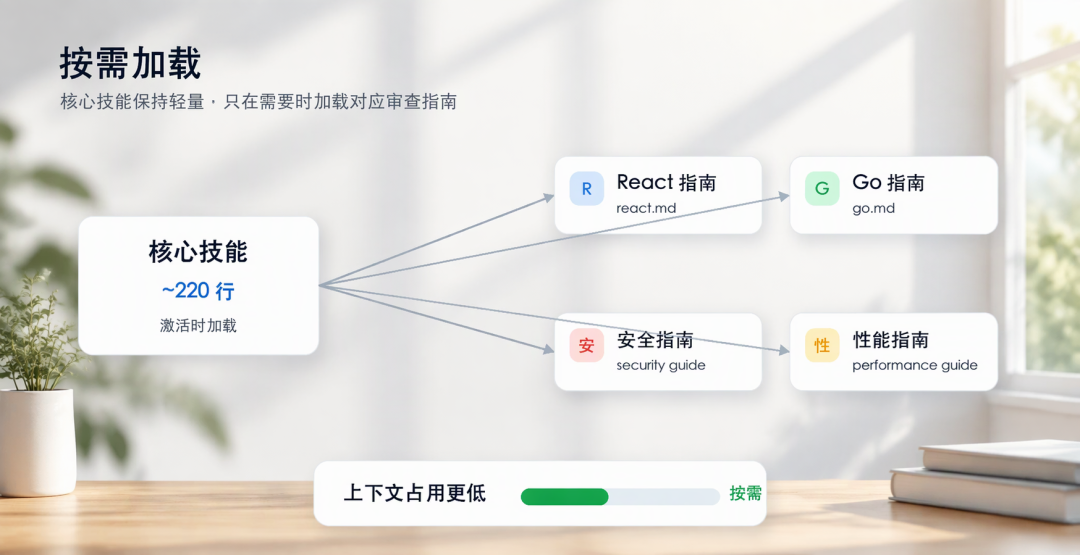
第二个是 code-review-skill:攒了两万一千行审查指南,但真正装进上下文的核心只有两百二十行左右——审 React 拉 react.md,审 Go 拉 go.md,其余文件躺在磁盘上不动。知乎
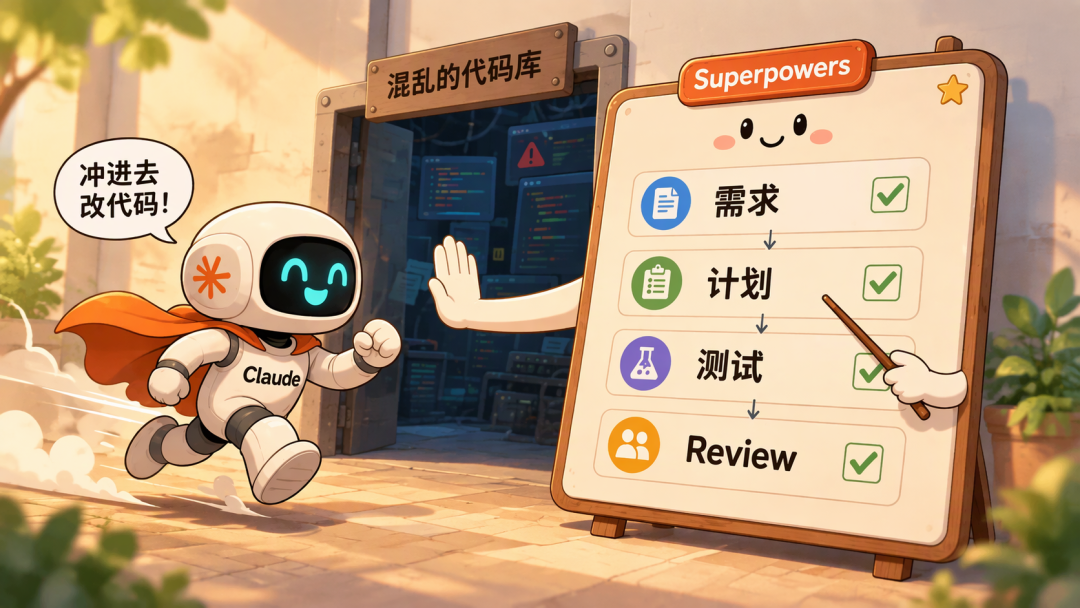
它也不让模型扫两眼就交差,流程硬拆成四个阶段:先搞懂这个 PR 想干什么,再查架构与性能,然后逐行抠逻辑、安全、边界,最后出结构化结论。每条发现打六档标签——blocking、important、nit、suggestion、learning、praise,时间紧就只看 blocking。知乎
两个例子指向同一件事:Skill 不是"更长的提示词",是一套能被按需加载的流程和清单。
 https://tmpf.smzdm.com/202611/16/6afae2d459a3c5514.png
三个坑:多数时候不是写的锅,是环境的锅
两个 Skill 的 description 语义撞车,谁都选不定,最后一起退化为使用默认对话能力直接作答。解法是各自收紧专有名词、描述互斥:“段落级查错别字"和"长文结构化评分"就不能都叫"帮你审文章”。知乎
Skill 放在团队共享仓库里,换个目录就 / 不出来了:它必须在全局 `~/.claude/skills/` 或项目的 `.claude/skills/` 下。
同一台机器上 Codex 和 Claude Code 还会因为 `–add-dir` 启动参数配置不同,各自能看到的 Skill 列表完全不一致,能差出 5 比 1。
SKILL.md 这个文件名不能改,frontmatter 里的 name 必须与目录名严格一致。评论区有人很认真地问"这几个字不能改,对吗"——对,不能改。小红书
最后一步:别随机问,按三层验证
排查修改后切忌盲目随机提问,推荐按三层递进做确定性验证。在输入框敲一个斜杠 `/`,看自动补全列表里有没有它;显式回车执行斜杠命令,确认正文真的加载了;然后 `/clear` 清空会话,丢一句业务口语——“这篇写得怎么样,能不能发”——测它会不会自然触发。三层全过,才算真的装上了。知乎
 https://tmpf.smzdm.com/202611/16/6afae2f1567e13838.png
已经有人把这套手艺做成了生意:Skillry 卖 Agent Skill,9 月收入 $1,608,10 月直接干到 $12,216。数据还挂着 Stripe 验证。但先别急着卖,回头检查你那一行 description——你的 Skill 是摆设还是硬通货,区别就在模型肯不肯通过那一行,给它正文一个被读到的机会。小红书