这两天「OpenAI 亲儿子叛变」的标题刷屏了。有的版本越传越离谱,说估值 110 亿美元的法律 AI 公司 Harvey「彻底抛弃 GPT、抛弃 Claude」。
事情是真的,但标题至少夸张了三处。把它拆清楚之后,你会发现真正值得在意的,不是谁「叛变」了谁,而是你每个月给 AI 交的钱,背后的定价逻辑正在变。
先说发生了什么
8 月 20 日(当地时间),Harvey 官宣了第一个自有模型 Harvey Tenet。Harvey官方博客几个关键事实:
底座是中国月之暗面的开源模型 Kimi K3——2.8 万亿参数 MoE、100 万 token 上下文,目前全球参数量最大的开放权重模型。新智元
Harvey 和 Fireworks AI 合作,用公开法律数据、合成数据和模拟长时程法律工作的专家数据做后训练。训练只用了约 150 块英伟达 B300,跑了两个月。Harvey官方博客
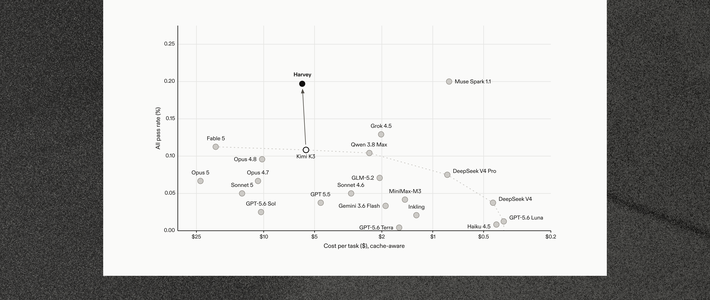
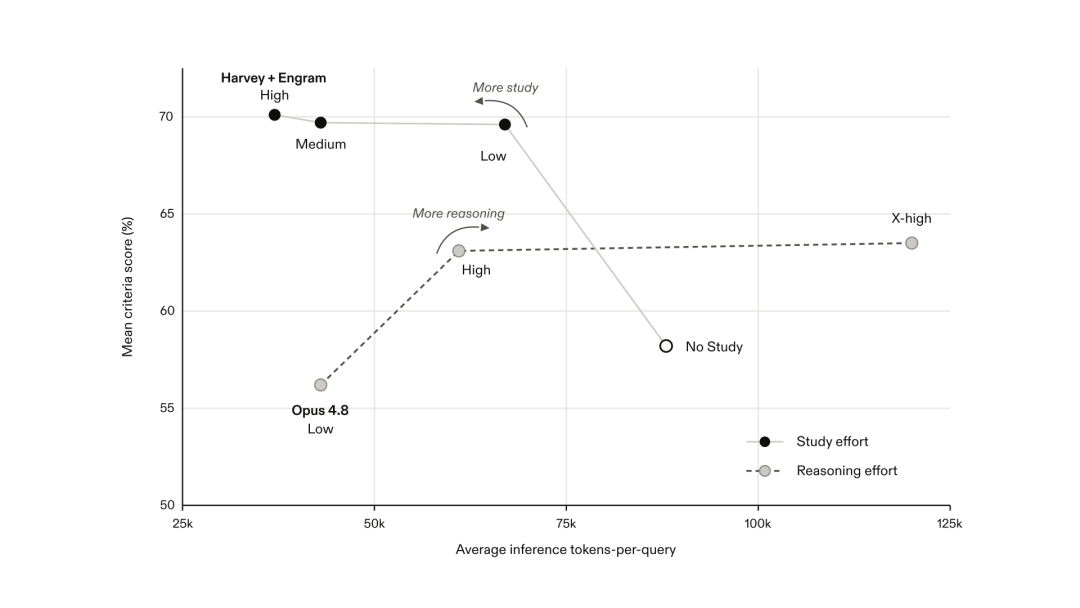
在 Harvey 自建并已开源的法律基准 LAB 上,Tenet 相对 K3 底座全通过率提升 82%,Contracts 子榜 SOTA;合作方 Mercor 拿公司法任务测试,Tenet 比底座高 15 分。
官方口径里最狠的一句:推理成本不到主流前沿模型的四分之一。
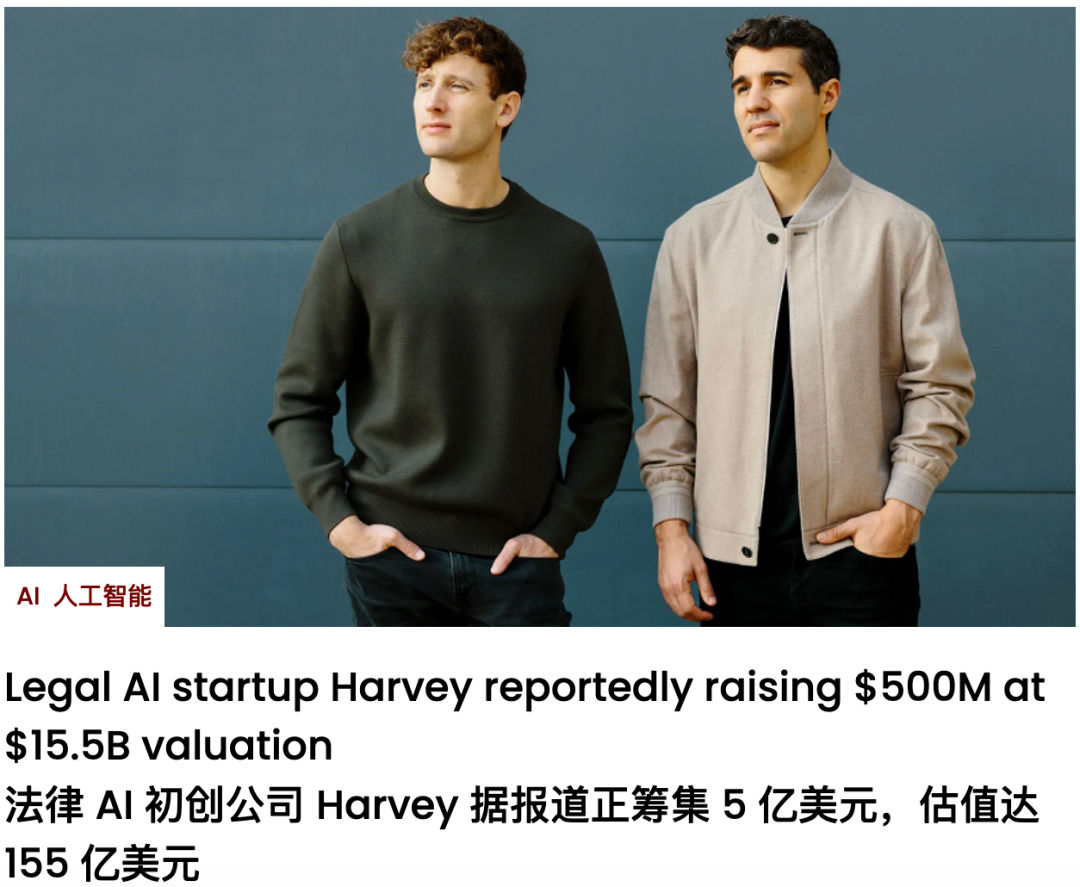
注意,Harvey 不是路边小团队。它是全球估值最高的法律 AI 公司,服务 1300 家机构、超过 10 万名律师,汇丰、普华永道、桥水、KKR 都在客户名单里。新智元而且 OpenAI 创业基金领投过它的种子轮——这就是「亲儿子」说法的来源。
三个被标题夸大的地方
第一,Harvey 没有「抛弃」GPT 和 Claude。Tenet 只是多了一个自有选项,Harvey 的平台上现在仍然同时接 Claude Opus 5 和 GPT-5.6 Sol。新智元准确的说法是:从「全靠买」变成「买 + 自己造」。
第二,Tenet 不是从零训练出来的。150 块卡两个月,做的是后训练——相当于别人盖好的楼里做精装修。真正从零预训练一个前沿模型,要几万张卡烧几个月、花数亿美元以上。新智元所以「自研模型」这个说法没错,但它的含义是「在开源底座上深度改造」,不是「从头造」。
第三,「性能超越 GPT-5.6 Sol」是有口径的。这个结论来自 Harvey 自己的法律基准:在 Artificial Analysis 独立评测的 Harvey LAB-AA 上,最严格口径里 Kimi K3 裸考拿 26.7%,几乎是 Fable 5(14.2%)的两倍——也就是说底座在法律任务上本来就强,Tenet 又往上提了一截。新智元法律之外它是不是全面更强,目前没有证据。
为什么是现在:一笔账 + 一个警觉
Harvey 联合创始人 Pereyra 的解释很直白,归结起来就是两件事。
一笔账:Harvey 每月要处理 13 万亿 token,每一个都是从 OpenAI、Anthropic、Google 那里按调用付费买来的。新智元模型厂说涨价就涨价,应用层毫无还手之力。手里有一个自己能改、能部署、成本只有四分之一的模型,再回去谈 API 价格,底气完全不同。
一个警觉:卖你 API 的人,开始惦记你的生意了。OpenAI 挖走了合同管理公司 Ironclad 的创始人 Jason Boehmig 去领导自己的法律业务;Anthropic 推出了面向律师的文档审查插件。新智元用 Pereyra 的话说,这不是「供应商」,这是「未来的竞争对手」。
所以 Tenet 的本质是谈判筹码 + 保险单,不是站队。
Harvey 不是第一个,这才是要点
把时间线拉长一点看,这事是一条正在成形的链条:
年初,Cursor 发布「自研」模型 Composer 2,三天后被开发者从 API 里扒出模型 ID:kimi-k2p5-rl-0317,底座是 Kimi K2.5,联创后来承认发布时没提底座「是一个失误」。新智元后来的 Composer 2.5 仍然沿用 Kimi 底座。
英国 Cosine 拿 Kimi K2.6 训出专修老代码的 LumenOutpost。
「全球第一位 AI 程序员」Devin 发布 SWE-1.7,公开承认用的是 Kimi K2.7。APPSO
Perplexity 在 K2 开源后就启动后训练,这家公司在开源圈的外号叫「验货官」。
连 OpenAI 前 CTO Mira Murati 的 Thinking Machines,其模型 Inkling 也参考了 DeepSeek V3 架构、用 Kimi K2.5 生成的合成数据启动微调。
编程、搜索、法律,半年之内,Kimi 的每一代几乎都被一家海外头部应用公司拿走当底座。CNBC 报道称,中国模型在 OpenRouter 上的美国企业 token 用量一度占到 46%,DoorDash、Airbnb 都在用中国模型控成本。新智元
这些公司不是图情怀,它们算的是同一笔账:闭源 API 越用越贵、越用越被动;开放权重可以拆开改(Harvey 拿 LoRA 深入 K3 的 50 万个专家张量做手术),还天然适配自己的长文本场景。底座模型正在变成「工业原材料」,真正的竞争壁垒往后移到了行业数据、专家反馈和后训练方法上。新智元
和你有什么关系
如果你在给 AI 工具付费——不管是 Cursor 这类编程订阅,还是各种 AI 办公、法律、翻译工具——这件事给的最实用的提醒是:标签上的「自研模型」不等于从零训练,付费之前值得搞清楚三件事:
它的技术报告或模型卡片里,有没有写清楚底座是谁、做了什么后训练;
不写的话,社区有没有人扒过 API 里的模型 ID(Cursor 就是这么被发现的);
计费规则是否透明,模型悄悄换代时会不会通知你。
底座是开源还是闭源本身不决定好坏,但「说清楚」这件事,值得成为你付钱的标准之一。
如果你是 ChatGPT 或 Claude 的会员:Tenet 不影响你现在能用什么,但它背后的成本松动是真实的。当头部应用公司都能用四分之一的成本自己造轮子,闭源厂商只剩降价留住客户这一条路——OpenAI 7 月 30 日已经把 GPT-5.6 Luna 降价 80%,发布才三周。新智元时代财经价格战还远没到头,所以不必急着为任何「涨价预期」提前囤年卡,按月付、随时看,是眼下更划算的姿势。
最后给一个继续观察的信号清单:Harvey 说下一步要把算力从 1000 卡扩到 10000 卡做全参数微调,还要试更多开放底座;Kimi 下一代开源时,会不会又有海外公司接力;以及闭源两家的下一次降价什么时候来。新智元这三件事任何一件发生,都值得回头看这篇。