霸榜OpenRouter整整10天的神秘模型,现形了。
10月19日,OpenRouter披露:匿名模型"太空兔"(Space Bunny)曾连续10天位居平台模型使用量榜首,累计处理56.7万亿Token。10月23日,MiniMax正式开源M3.1 Flash模型权重,总参数4280亿、每个Token激活约230亿,Hugging Face和魔搭同步上架。Qwen3.8-Flash、GLM-5.3-Flash、DeepSeek-V4.1-Flash这仨为"谁进你家终端"吵了几个月,现在第四个玩家上桌了。知乎知乎知乎
但别急着装,先对完三本账。
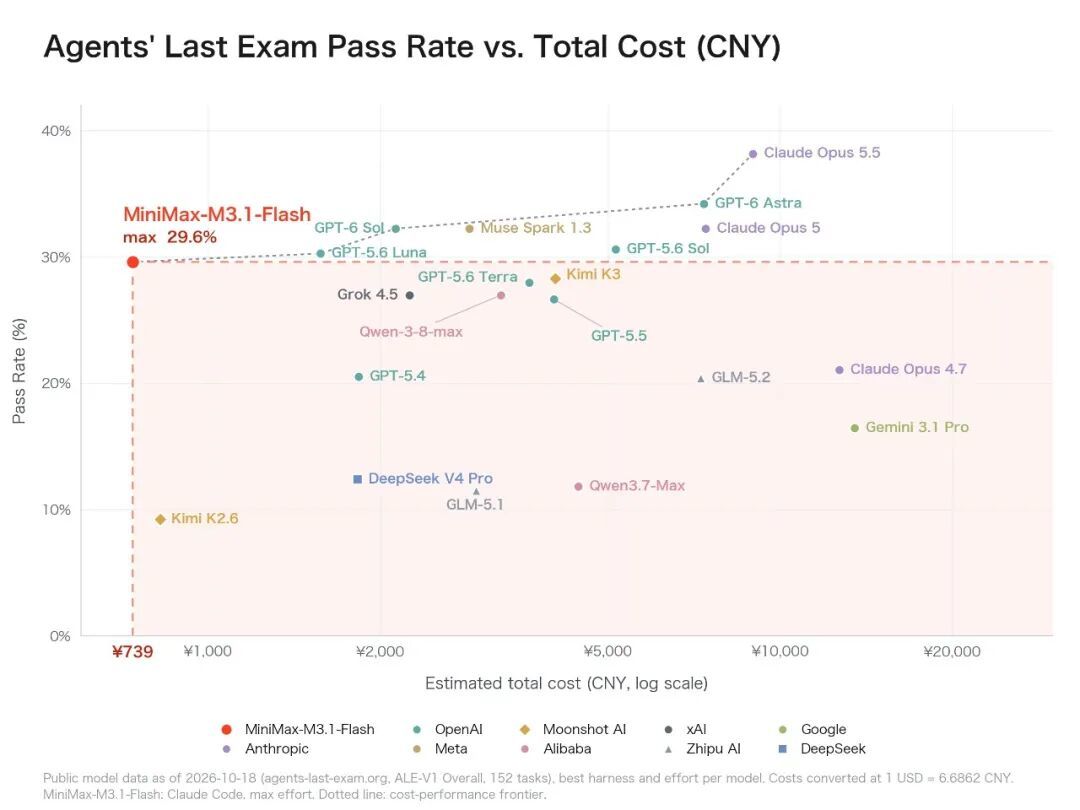
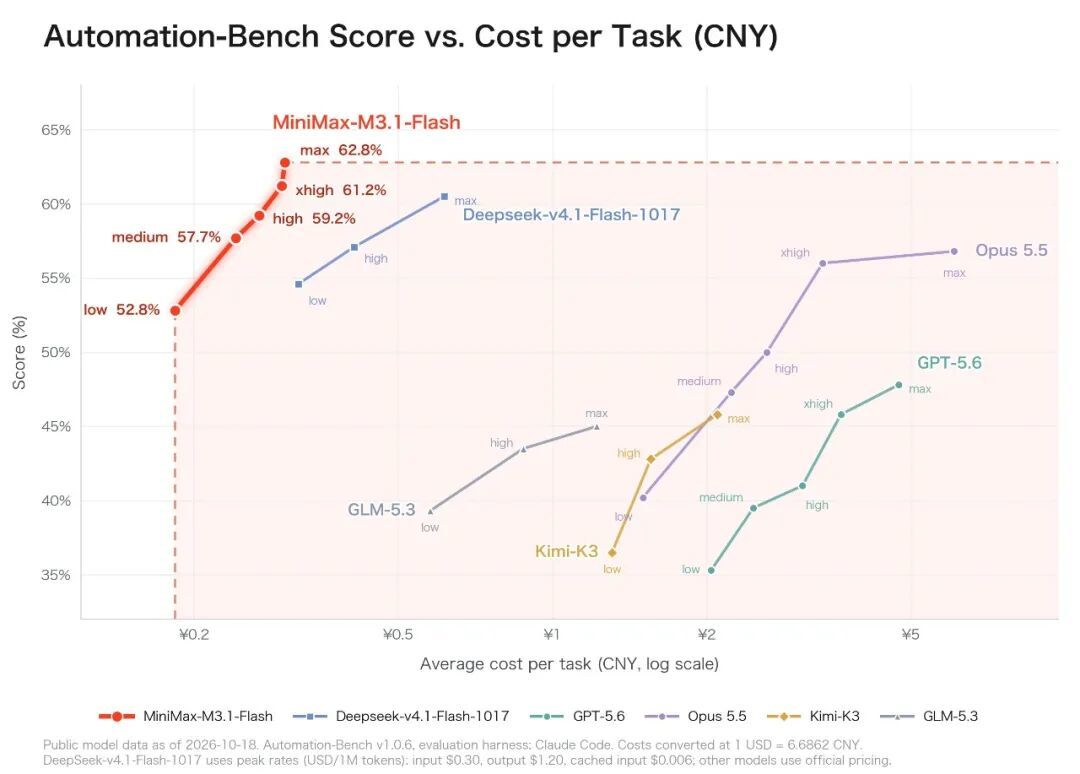
第一本账:开源了什么。 HF模型卡显示它是原生多模态MoE,文本/图像/视频都能喂,上下文最高约1M。它晒出的三项关键技术全是冲着部署去的:全模型稀疏注意力、量化感知训练(QAT)和功耗感知调度,相较上一代M3线上推理速度提升近3倍、智能体任务综合使用成本降低70%、日常使用输出速度可达每秒200多个Token。注意这是"量化感知训练"而不是训练后量化(PTQ),权重和激活在训练阶段就按低精度目标优化过。同门基准图放这儿,感受一下"低价高分"的走位:知乎知乎知乎
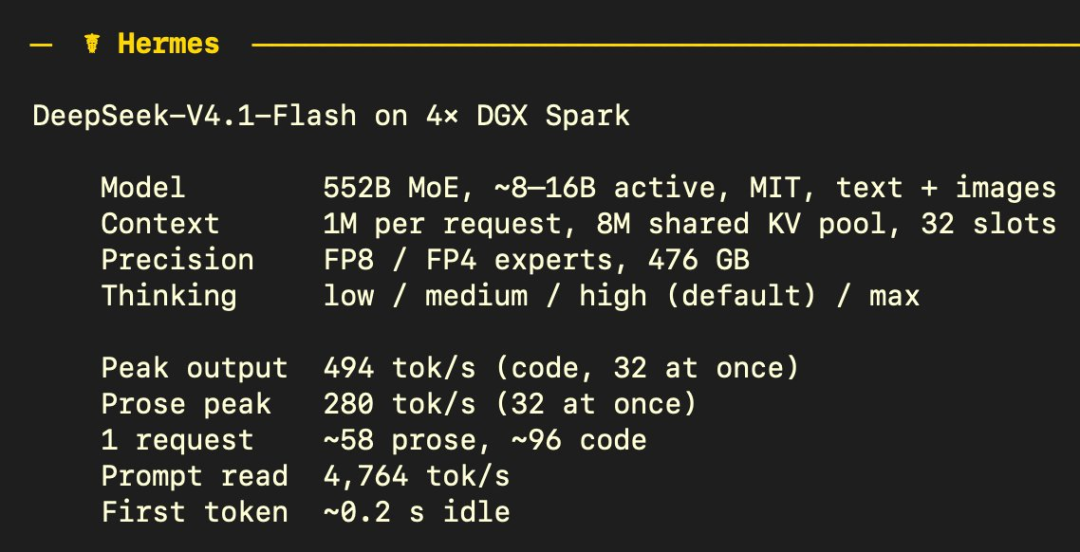
第二本账:你的电脑带不带得动。 坏消息先行:MoE的全体参数都要驻留显存/内存,428B就算按4bit量化,光权重也约214GB起(数量级估算,以社区实测为准),再叠上KV Cache——8G、12G显卡可以放弃了,这不是你的战场。这波开源真正的受众是大显存机器和多卡集群。小红书实测帖里那套双T5000、256G显存的机器,部署两大国模跑出了写代码68tok/s。AMD资深技术专家Patrick Moorhead家里4台DGX Spark组成本地推理系统,把552B参数的DeepSeek V4.1-Flash跑到峰值每秒494个token。玩的就是这个档位:小红书知乎
目前社区量化包(GGUF之类)还得再等等,就算出了,"装得下"和"跑得爽"也是两回事。
第三本账:自建划不划算。 官方API定价输入每百万Token 1元、输出4元、缓存读取0.1元。没硬件的别硬凑自建,这轮开源对普通用户反而是利好——云端用得便宜了:36氪
真有集群的,先读协议:MiniMax用的是MiniMax Community License,不是MIT/Apache,商业部署请先逐条看清楚再动手。知乎
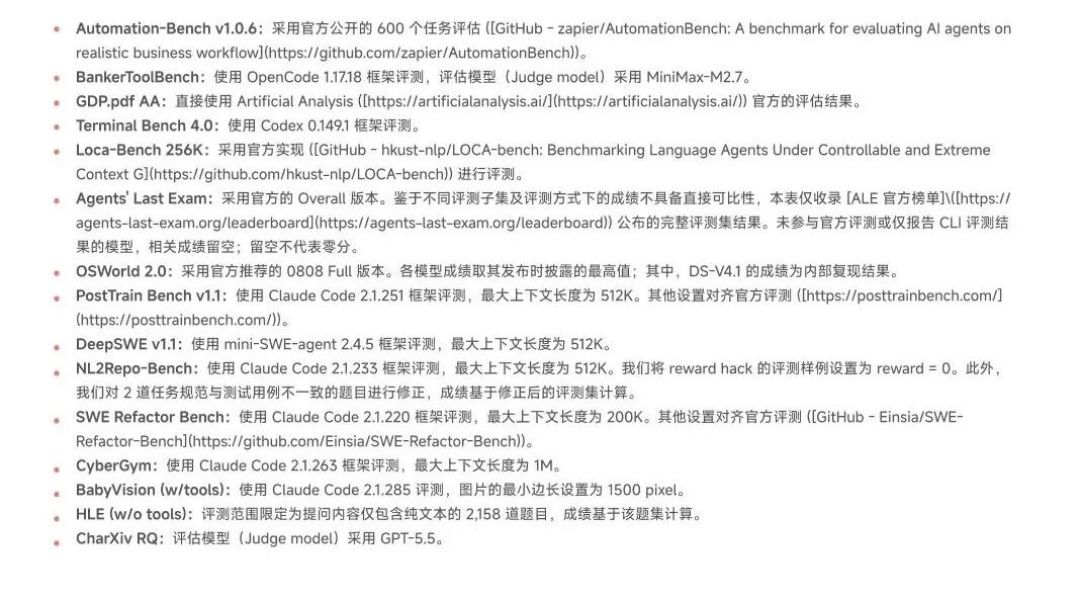
再泼一盆冷水:软件工程测试DeepSWE v1.1中M3.1 Flash取得73.7%的成绩,接近Claude Opus 5的74.0%——这些全是厂商自报数。知乎
权重公开才一天,第三方实测几乎还没存世;评论区已经有人直说"指令遵循不行,不敢用"——这些真实吐槽,恰恰是榜单照不到的角落。小红书
30秒决策。有512G大内存机/多卡集群→直接SGLang、vLLM部署开跑。只有12G小显卡→看戏就好,激活参数6B的Qwen3.8-Flash那类小激活模型才是你的正解。没硬件→等第一波本地实测出炉,再考虑拿它当DeepSeek高峰时段的平替。知乎知乎
兔子开源了,门开了,但实测的数字还没到。钱包可以准备好,结论别急着下。