10月24日凌晨1点多,月之暗面发布了 Kimi K3.1 Pro——Kimi 第一个带"Pro"后缀的模型。 接下来两天,社区讨论的不只是它的成绩:额度十分钟烧光、官方凌晨道歉、补偿返还。而在10月25日到26日,另一条消息在研究者和国产模型爱好者之间传开:唐杰担任通讯作者的论文曝光了智谱此前从未公开的内部模型 GLM-Omni,顺便揭了一个多数厂商不太愿意细说的尴尬:多模态模型能画对答案,却不一定能答对答案。小红书
这两件事撞在同一周,说的其实是同一句话——"原生多模态"已经成了旗舰大模型的主战场,但"会画"和"会知道"之间,还隔着一段可以被实测的距离。
一、K3.1 Pro:成绩冲上去,额度也炸了
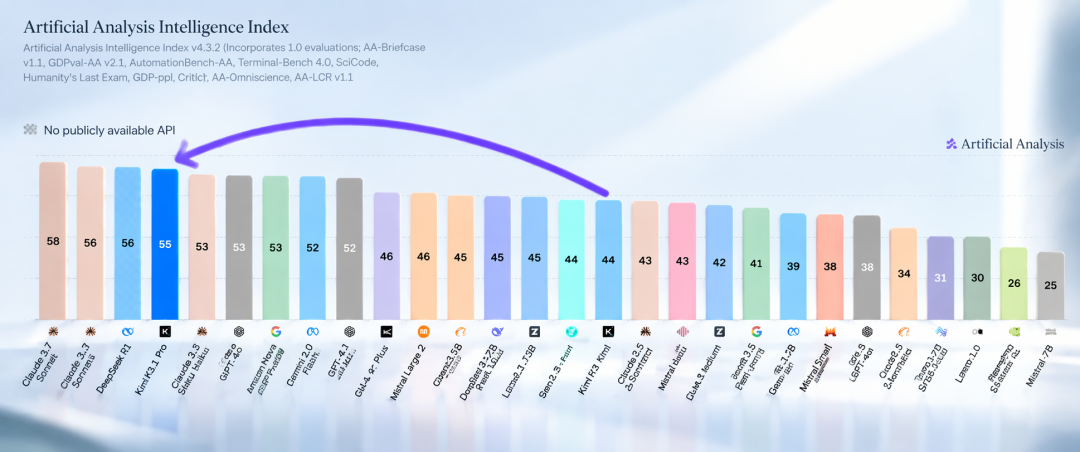
先看成绩。在最新的AA指数(Artificial Analysis)上,K3.1 Pro 从前代模型的44分直接飙到55分,仅次于 Claude 的5.5系列和 Meta 家的 Muse Wonder,是目前第一个杀进50分行列的国产模型。 36氪发布当天的战报标题则更直接:杀进全球前四,Agent第一。知乎36氪
一句话认识这个模型:基于 K3 后训练、3万亿参数、1M上下文、原生VLM(文/图/视频都能识别),而且依旧开源。 实测环节最有说服力的是一个"许愿式"任务:只给一句话——参考贵州侗族鼓楼的外形设计一盏可以直接3D打印的台灯——模型自己装依赖、下载资源、手写 Blender 和 FreeCAD 脚本,跑了约一个半小时,端到端交付了完整的源码、模型和说明书。从3D网页到立体书折纸这种对空间推理要求很高的案例,它的完成度都不错。一句话:Tool use 和空间推理,是这一代 K3.1 Pro 的招牌。知乎

但硬币的另一面,是发布当天就炸的社区:比K3快、性能逼近Opus,但额度10分钟就烧光了。 10月26日凌晨,Kimi 官方在X上发帖道歉,给被烧穿额度的用户做重置补偿。36氪小红书
技术层面的解释:Kimi Code 之前默认思考强度是 Max,subagent 又直接继承主Agent的思考强度,于是一堆"Max档"子代理同时跑;再加上 K3.1 本身输出啰嗦、主从Agent之间沟通频繁,消耗直接爆表。知乎
更值得琢磨的问题是:疯狂生成 subagent 很可能是RL训练带出来的行为,官方"减少不必要的子Agent调用和输出长度"这一改,效果会不会变差?有分析就指出,从官方贴出的 Terminal-Bench 4.0 结果看,high 跟 max 档位差很多。 与此同时,K3.1 Pro 开源版被讨论"刻意削弱网安能力",官方的说法是删除网安专项数据之后,还是比K3强了很多——这个争议也还在发酵。知乎知乎
顺便说个圈内乐子。B站UP主"伍斯特饿"自测了一个"奶蛙bench":只放图,问模型这是哪个中文网络梗角色。结果 K3.1 Pro 拿了83.3分,9个模型里排第4;上一代K3只有62.5分,排第7。 多模态模型的"网感",确实在一代一代变强。哔哩哔哩
二、画对的球衣号码31,和说出口的69
再看智谱这边。10月19日挂上arXiv的论文《Can Visual Generation Expand What Unified Multimodal Models Know?》,通讯作者是智谱首席科学家唐杰。 论文里出现了一个此前未公开的模型 GLM-Omni:以开源的GLM-4.1V-Thinking为基座,参数只有9B,属于较小的测试模型。微博36氪
这篇论文做了一件很聪明的事:它先造了一个叫 MagicWorld 的虚构世界,球队、人物、徽章全是新造的,颜色、数量、数字、形状、大小、空间位置、文字7类知识共350个知识单元、8552张训练图——属性值只画在图里,配文绝不透露,从根上排除了"模型早就背过"的可能。 然后分别考两件事:画图时能不能画对,纯文字问能不能答对。36氪
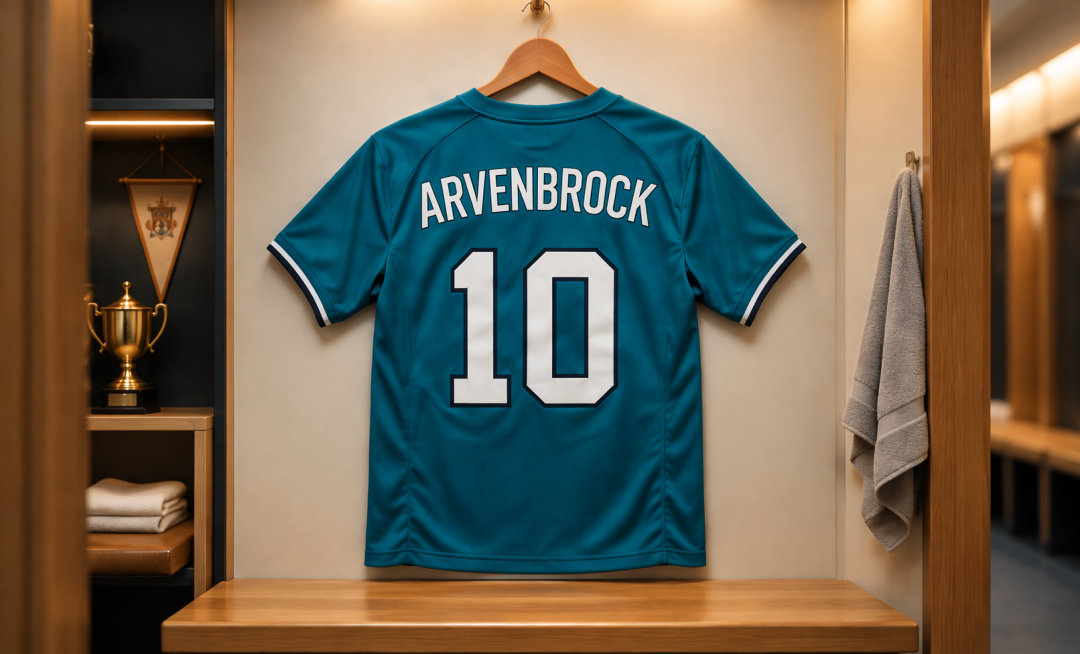
第一轮结果就是标题里的那组数字:GLM-Omni 平均图像生成正确率54%,同样的知识用文字问答只有14.57%;数字任务最夸张,72%能画对,文字问出来只剩2%。商汤 SenseNova-U1 的数字任务差距更大:画88%对,答0%。 论文给了个特别直观的案例:一个虚构球员的球衣号码,训练图里画的是31,模型能画对;直接用文字问它,它张口就答69。这类错误的隐蔽性在于:69 在形式上是合法号码,句子也通顺,错误发生在实体与取值的对应关系上,只检查回答格式的系统根本发现不了。36氪知乎
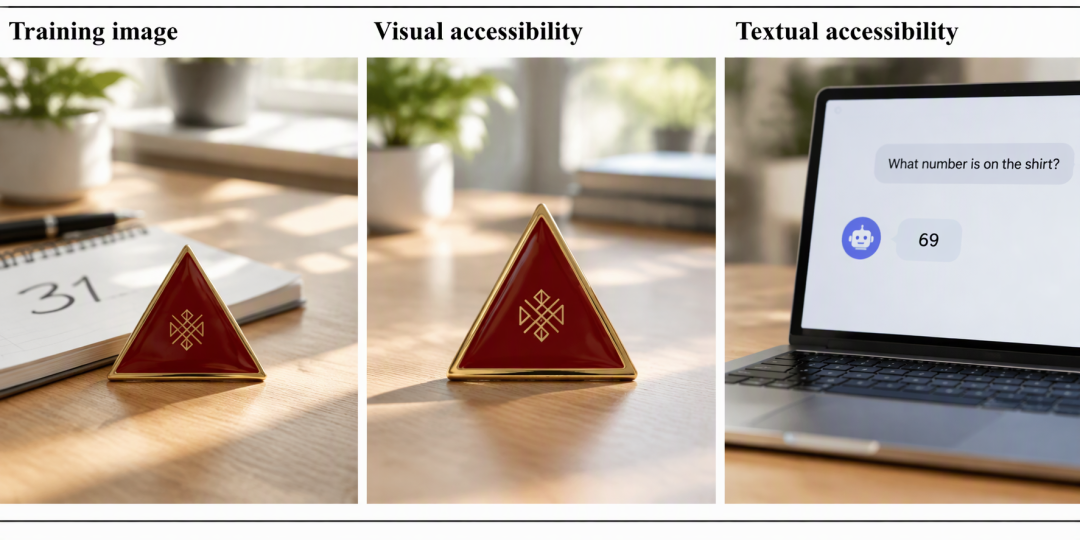
更有意思的是论文接下来的三轮"抢救"。整理成表格大概是这个样子:
训练/推理阶段(GLM-Omni 文字问答均值) | 正确率 |
|---|---|
直接迁移(只训生成) | 14.57% |
追加纯文本问答对齐 | 12.57%(不升反降) |
图文交错对齐(画-看-答同一条训练序列) | 26.86% |
交错训练但屏蔽图像损失(消融) | 13.71% |
交错对齐 + 推理时先画再答(Visual CoT) | 41.14% |
三个信号很硬核:单纯加文字问答没用甚至倒扣;把"生成、观察、回答"塞进同一条训练序列才真正建立联系(消融实验把图像损失一屏蔽,提升就塌回13.71%,说明增益确实来自生成信号);而到了推理阶段让模型"先画个图再看着图回答",准确率进一步提高至41.14%,数字任务直接从0%提到36%。 那个先画后看的小模型,把69改成了31。36氪
nano 从工程角度提的几点更值得从业者记下:生成侧和问答侧是两列独立的验收指标,产品属性问答必须单独测,并尽量在同一批受控的新知识上观察。知乎
而 Visual CoT 本质是用额外的算力与延迟换知识可及性:论文没有纯文本思维链或二次作答的对照,额外计算和观察图像各贡献多少还没有被独立确认,划不划算要按场景算账。知乎
AI前线的解读也明确泼了冷水:这篇论文并不是下一代GLM即将采用某种架构的直接证据,社区把它和"GLM 5.5"传言挂钩属于未证实。 眼下的智谱产品线其实是分工模式:8月发布的 GLM-5.3-Flash 负责多模态理解——那是GLM-5系列首款原生多模态模型、还用的国产卡——但输出仍然主要是文本,生成图像交给专门的GLM-Image。36氪36氪
三、为什么所有人突然都押注"原生多模态"
把时间线拉长一点,这个十月并不孤单,几乎每家都在同一个方向落子。
成本上,多模态理解已经卷进了价格战:8月,多模态版DeepSeek V4-Flash 被媒体形容为"长眼"了,1000张图只要1块钱。 MiniMax 发布并开源了多模态模型H3,性能又强价格又便宜,关键它还开源,喊话要做"多模态领域的DeepSeek"。36氪36氪
能力上,K3.1 Pro 抢的是"Agent第一"和空间推理,GLM-5.3-Flash 的价值在于在Coding Agent工作流里看懂界面、观察渲染结果再改代码——两边干的是同一件事:让模型用视觉信息去"干活",而不是去"聊天"。姚顺雨重整后的腾讯多模态路线,公开的说法也是从"生成内容"转向"理解上下文并在世界中行动"。 商汤首席科学家林达华8月底的采访判断是:多模态的涌现时刻会在一两年内到来。36氪36氪
但统一架构并没有公认赢家。2025年3月,OpenAI 曾将原生图像生成整合进GPT-4o,强调图像生成应当成为语言模型的核心能力,但在后续产品中又转向由GPT Image等专业模型承担生成;谷歌也在通用Gemini与Nano Banana图像模型之间形成了产品分工。36氪
原因很朴素:专业模型更容易针对画质、速度和成本单独优化。唐杰自己在2025年12月也曾表示,文本、多模态理解和多模态生成"可能最有效的方式还是分开发展",只是三者结合也值得探索。 这篇KTP论文给"结合"提供了第一个可验证的正面理由——生成训练能带来文字监督里没有的知识——但研究尚未证明这种收益足以覆盖统一架构的成本。路线之争,远没有到盖棺的时候。36氪
四、不下强结论:接下来看这四个信号

K3.1 Pro 的修复走向:开源权重落地后,"收敛subagent行为"会不会牺牲推理效果?看后续第三方评测里各思考档位的完整曲线,而不是只看Max档的榜单成绩。
下一代GLM的表述:智谱已在业绩交流会公告里写入提升"原生多模态统一建模能力",GLM-6.0还将探索模型的自我评估与持续改进能力,它是否把 GLM-Omni 这条探索变成产品架构,比任何传言都更值得等。36氪
KTP协议的外部复现:BAGEL 和 SenseNova-U1 是公开可测的,如果第三方在开源统一模型上复现"画对答错"缺口并测出新的对齐方案,这项研究才算真正立住。
对普通爱好者最实用的一条:下次测任意多模态模型,别只看它图生成得好不好——让它画一张带数字的图,再用纯文字问它图里的答案。会画和会答,是两回事。
写在最后
这一周,Kimi 把性能和争议一起摆上了台面,智谱则用一篇署名论文,把"统一多模态"从宣传话术打回了待验证的工程问题。对一个追热点追到疲的产业来说,这未必是坏消息:尴尬被量化了——72%对2%,12.57%对41.14%——而能被测量的问题,才有被解决的可能。