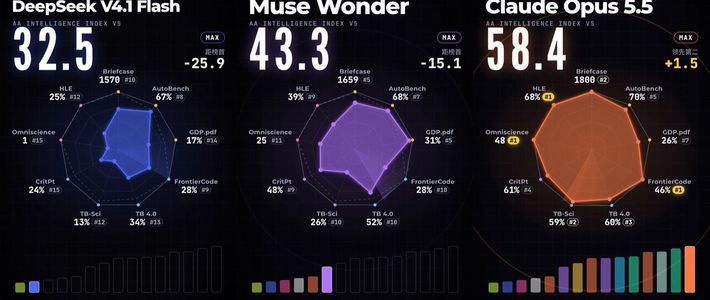
10月27日,独立AI评测机构Artificial Analysis(下称AA)把智能指数从v4升级到v5.0,这是今年1月以来最大的一次改版:考试项目几乎重排,私有题库的权重抬到六成,榜单随之大洗牌,一批国产与开源模型分数跳水。而同期被热议的“DeepSeek编码第一”,其实不是同一把尺子量出来的——它登顶的是Arena用户盲测榜单,口径是“开源模型第一”;在新AA标尺下,它max配置得分只有32分,属于已发布权重模型里的并列最高,但离榜首差着26分。想知道这个“第一”值多少,得先把两把尺子分别看清楚。微博
考场从“开卷答题”换成“闭卷交付”
v5.0一共九项评测,知识工作、编程、科学和通用能力各占25%,新增的代码修改与科研工作流就占了总分三成。原来的长篇文档与长文本测试则让位:单独考长文本推理的AA-LCR和备受争议的GDPval-AA,这次被直接移出总分。AI工具导航站知乎
新增的两道硬题都不留情面。代码修改用的是FrontierCode 2.0,132个任务全部来自真实代码库,按“改动是否达到维护者愿意合并”的标准评分,任何一项关键检查没过就记零分。科研项Terminal-Bench-Science要求在终端里独立完成整套科研工作流、由验收程序判分,AA发布时GPT-6 Astra完成率63%,DeepSeek V4.1 Flash只有13%。AI工具导航站微博
另一处关键变化是抗刷分机制:整套指数采用私有测试集或隐藏答案的评测权重从45%升到了60%,目的是减少测试内容提前进入训练数据的风险。换句话说,v5把考场从“开卷”改成了“闭卷实战”,过去靠公开题库刷分的老路基本被堵死。AI工具导航站
新榜第一换得很快,开源阵营掉得很惨
改版后的首轮总榜前三名依次是Opus 5.5、GPT-6 Astra和GPT-6.1 Sol,max配置分别拿到58、57和55分。但头名没坐热:AA在Carbon发布前一天把智能指数升级到v5,换上了更难的新测试集。谷歌的Gemini 4 Carbon随即以59分登顶,超过Claude Opus 5.5和GPT-6 Astra。不过这款模型本周只向少数网络安全防御团队开放,普通开发者暂时用不上。AI工具导航站赛博帕鲁华尔街见闻
时间点太巧也引来吐槽:Hacker News上有人说“榜单昨天刚更新,谷歌今天就登顶,真巧”。但也有长期批评AA的知乎答主认为,这次把最差的两块删掉后,榜单脱胎换骨:“以前的那个版本只能被看作随机数生成器”,如今已值得当成一个分数看。新尺子的公信力,就悬在这两种评价之间。赛博帕鲁知乎
开源这边则是另一番景象。Kimi K3.1 Pro从55分降到46分,仍是开源里的最高,但离榜首已差12分。在已经发布权重的模型里,DeepSeek V4.1 Flash 1017和GLM-5.3的max配置最高,也只有32分。分差拉大的根源不在模型一夜之间变差,而在评测重心转向了智能体实战与科研交付:过去奖励“知道答案”,现在奖励的是“把事做成”。微博AI工具导航站
DeepSeek的“编码第一”,到底在哪个榜
10月19日,AI模型评测平台Arena宣布,DeepSeek-V4.1-Flash-1017(Max)超过Kimi K3(Max),成为Code Arena: WebDev榜单排名最高的开源模型。它同时在Agent Arena和Code Arena: WebDev两个真实任务榜单上拿下开源模型第一名。智东西微博
具体成绩是:得分为1670分,超过了Muse Spark 1.3(Max)、Claude Opus 5(High)、Grok 4.7(xHigh)等闭源模型,仅落后榜首的GPT-6 Sol(Max)12分。其整体排名约第12,中位任务成本约0.19至0.20美元,综合成本只有Kimi K3的约十分之一。智东西未来图灵
官方成绩单这边,V4.1-Flash-1017在DeepSWE v1.1软件工程基准的通过率从74.2%提到77.0%,超过GPT-6 Astra和Claude Opus 5,单任务平均成本从约3.3元降到约1.3元。另一重热度来自真实使用:OpenRouter周榜上,它单周调用量达到33.6万亿Token,环比增幅高达801%。不过那是用量口径,和能力口径是两回事,读榜时要分开。程序员飞哥百数朝智网
含金量在哪里,边界又在哪里
把这个“第一”拆开看,有三处要限定。其一,它是“开源模型第一”,不是全球第一:评论区有网友质疑“全球第一”的说法,也有网友指出Qwen3.8 Max的WebDev分数更高,DeepSeek拿下的口径是开源模型中的第一,整体排名仍落后于顶尖闭源模型。其二,真实的部分同样不含糊:这个Elo来自真实用户会话的盲测投票,不是静态题库;Arena对比图显示它进入了“帕累托前沿”,即目前没有其他模型能同时做到比它更便宜且得分更高——“开源+编码+低成本”叠在一起,含金量是实的。其三,新尺子也照出了短板:13%的科研任务通过率、32分的综合分,说明差距集中在“从零自主推进长程复杂工作流”,而不是写功能、改前端这类日常编码。未来图灵智东西
对用户来说,这轮榜单地震的实际含义是:选型前先看清三件事——榜是谁做的、测什么场景、取的是max还是high档配置。成本敏感的网页开发、Agent日常任务,DeepSeek V4.1 Flash 1017这类开源模型已是极划算的选择;需要模型在陌生环境里连跑数天的科研级长任务,目前仍是闭源旗舰的领域。而AA刚把六成权重压进私有题库,接下来值得盯的是:下一个版本会不会再洗牌,以及Kimi K3.1 Pro们放出权重后,开源与闭源的真实差距还剩几层。