一周之内,两家巨头把同一行代码摆上桌
10月19日,亚马逊端出 TorchNeuron:一行 `.to(‘neuron’)`,PyTorch 代码就能指向 Trainium2/3,eager、torch.compile 和自研 NKI 内核全支持,次日上午在圣何塞 PyTorch 大会以 Apache 2.0 开源,配套 vLLM Neuron 推理插件。官方口径:已有 30 多家早期客户覆盖机器人、世界模型与语音 AI,自研芯片业务年化营收超 250 亿美元。知乎
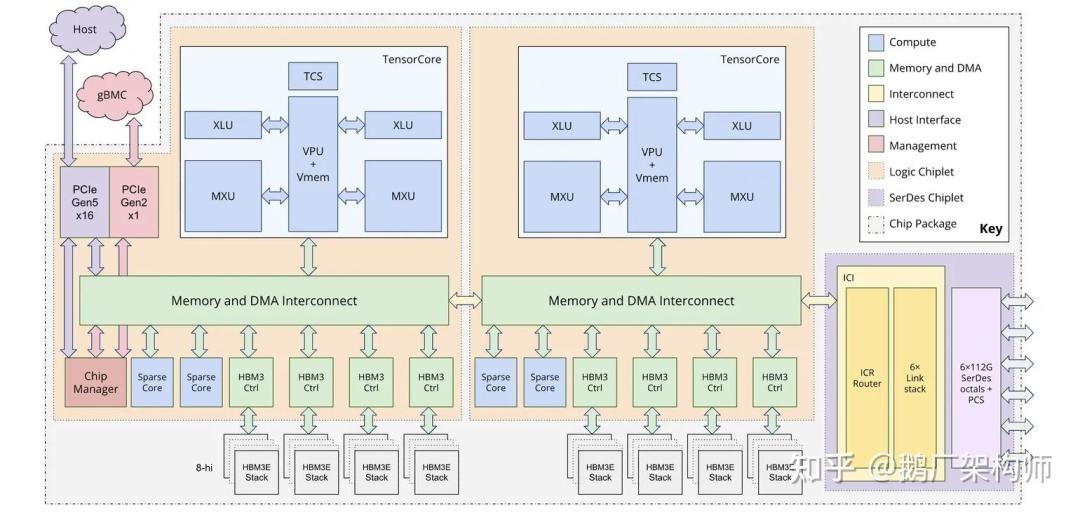
10月20日,谷歌在 PyTorch Conference 2026 上把 TorchTPU 开源了——一个由谷歌和 Meta 的 PyTorch 团队共建的原生 TPU 后端,卖点同样是那一行:`.to(“cuda”)` 改成 `.to(“tpu”)`。 同一天,vLLM、SGLang、Hugging Face Transformers v5、TorchTitan 齐发 TPU 集成(Transformers v5 里设一个 `device_map=“tpu”` 就能加载模型),`torch_tpu` 已上 PyPI(0.2.0,Apache-2.0)。谷歌称训练路径已在最多 8000 颗 Ironwood TPU(v7x)上完成验证,Qwen3-8B 测试最高做到 52% 的模型浮点运算利用率(MFU)。推理侧,谷歌与红帽、IBM 等 25 家机构共同发布 llm-d 1.0,在 GKE 上通过统一端点在 GPU 和 TPU 之间调度负载。印度公司 Zenteiq.ai 称在 1000 颗 TPU v6e 上把日生成 token 从 14.7 亿提到 59.7 亿,整体推理吞吐量提升超过 4 倍。 DeepInfer 开源也在同一周落地,Apache 2.0,兼容英伟达与昇腾,官方称每秒解码超 2.5 万 token。 几件事拼在一起,这两天的标题都在说同一件事:CUDA 的护城河被正面进攻了。知乎知乎知乎
但对靠 CUDA 吃饭的人,"护城河塌了"值钱的不是情绪,是成本表。先把这篇账本的三笔噪音、一套机制、四行迁移清单算清楚。
先拆三个噪音
第一,这不是横空出世。 TorchTPU 在谷歌内部 2025 年中就立了项,"Eager First"设计 2026 年 4 月已在 Google Developers Blog 公开讲过,路透社去年 12 月就写过它,标题直接点明目的:《谷歌联手 Meta,侵蚀英伟达的软件优势》。 10月20日是正式开源加生态全家桶齐发,四个仓库同一天开的整齐程度,更像排练过的发布节奏。知乎
第二,XLA 没被杀死,JAX 也没完。 TorchTPU 的编译路径仍然是 TorchDynamo 抓图 → StableHLO → OpenXLA,被替代的只是接入方式:2020 年推出的 PyTorch/XLA Lazy Tensor 老路。它的痛点被谷歌官方自己点名:要改源码划定编译区、编译延迟大、没有原生 eager、分布式原语滞后。但截至目前没有找到 PyTorch/XLA 的正式弃用/EOL 公告,发布博客里还明说 vLLM-JAX 和 SGLang-JAX “仍是重要项目,将继续维护”。 写"旧路线已死"的,都没读原始公告。知乎
第三,性能数字目前全是官方口径。 52% MFU 是谷歌自己提交的数字,“4 倍吞吐"出自客户 Zenteiq.ai 的转述,每秒 2.5 万 token、30 多家客户也都还是厂商口径——没有一条有第三方在你的业务负载上独立复现。证据覆盖到哪里,结论就只能说到哪里:现在能确认的是"路修好了”,不是"你的车开上去有多快"。知乎
"改一行换芯片"到底改了什么:PyTorch 的 JVM 时刻
写 CUDA 的人熟悉 `.to(“cuda”)` 背后的约定:tensor 的 storage 指向一块物理显存,kernel 立刻 launch。把 TorchTPU 的源码拆开看(Apache 2.0 可直接读),它走的是完全另一套约定:
整个后端挂在 PyTorch 的 PrivateUse1 树外接口上:`import torch` 时自动装载,把 PrivateUse1 改名成 tpu,生成 `torch.tpu`、`is_tpu`、编译后端、`tpu_dist` 分布式后端和 profiler/DTensor 等补丁。知乎
算子下去不立刻算:`y = x + 1` 返回的是一个记着 StableHLO 的延迟算子 DeferredOp,此刻 HBM 里还没有数;storage 拿到的是一层 DeviceBufferRef 间接引用,要等 `.cpu()`、`.item()` 这类同步点,后台的 MaterializationWorker 才物化执行。
编译有三级缓存:进程内内存、本机共享内存(多卡默认开)、远程持久化(默认关);cache key 包含图结构、shape、编译选项和 TPU/libtpu/PjRt 版本——shape 一变就可能 miss,重编译。
`torch.compile` 在该后端默认 `dynamic=False`;动态 shape 不是随便动,是bounded dynamism:按桶最多 8 档,避免每个新序列长度都重编译。
集体通信 all_reduce/all_gather 同样变成带设备分配的 DeferredOp,和计算排在同一条 Stream 上,让 XLA 做计算与通信的 overlap;死代码消除会特意跳过集体通信,防止各卡图不一致死锁。
这就是当年 JVM 的同一个剧本:字节码和虚拟机都还在,换掉的是"你写代码时要伺候的规矩"。TechCrunch 给了一个背景数:PyTorch 大约跑着 85% 的 AI 应用。 当 `.to(“tpu”)` 和 `.to(“neuron”)` 变得和 `.to(“cuda”)` 一样无聊时,被标准化的不是硬件性能,是接口层。知乎
抽象层盖不住的钱:迁移台账四行
demo 模型一行配置成立,断点在你仓库底层:
自研 CUDA kernel 首当其冲。 一行配置的前提是代码规矩走在 PyTorch 标准路径上。凡是手写过 CUTLASS GEMM、Triton 融合算子、为特定模型调过 kernel launch 的存量项目,抽象层盖不住,该重写的还得重写。 Trainium 侧的逃生口是 NKI 自研内核,TPU 侧则要回到 XLA/StableHLO 的心智模型——对 CUDA 深度用户,这不是换设备,是换一套世界观。知乎
数值漂移是最贵的隐性成本。 bf16/fp8 的累加顺序、split-K 策略、舍入行为在不同硬件上都不一样,"差一点"的 loss 和偶发的输出差异,排查成本极高。知乎上讨论这条新闻时被反复引用的工程原话是:重新迁移一次,谁来解释速度变化,谁来排查偶发错误,谁又能保证交付日期不动?知乎
工具链要换路。 nsys/ncu 的 profile 习惯、"盯 SM 利用率和带宽看气泡"的调试直觉,在 XLA 栈里全部失效,要看的是另一组颗粒度:编译缓存命中率、bucket 边界、通信 overlap 比例。这部分学习曲线没有任何开源能替你省。
供给本身。 Hacker News 上那条 256 分、62 评论的讨论(截至 10月21 日凌晨),最高赞评论不是技术问题:"Google Cloud 之外有 TPU 吗?"答案基本是没有——除非你是 Anthropic 那个量级的直采客户(它 2025 年 10 月确认的交易:最多 100 万颗 TPU、数百亿美元、2026 年上线超 1GW 容量,且刻意让 TPU、Trainium、英伟达 GPU 三平台并行)。知乎
护城河没塌,是往下沉了一层
结论不是"英伟达完了"。知乎一条高赞回答把话说明白了:100 家公司在突破英伟达的护城河,可能只有一家会成功。 真正的变化是护城河往下沉:框架层一旦标准化,竞争就回到框架之下那层——谁能造出加速器、并把它分配给谁。注意 Meta 在这件事里的双重身份:既是 TorchTPU 共同开发方,又是生产用户(SGLang-TorchTPU 已在生产跑,TorchRec 是合作项目)。它的 PyTorch 工程总监把动机说得很直白:"不能被单一硬件架构绑住。"全球最大 PyTorch 用户亲手修一条离开 CUDA 的路,不是开源情怀,是在它的采购量级上,"可选项"本身就是议价权——TorchTPU 就是这份议价权的代码形态。 但护城河沉下去不等于护城河消失:锁定的风险不会消失,只会换形式——从锁在芯片厂商手里,变成部分锁在框架维护方的更新节奏上。 抽象层的损耗是确定的、可测的;锁定的代价是不确定的、赌命的。你为哪种不确定性付钱,取决于你的规模。知乎知乎知乎
对买算力的人,这个逻辑同样成立:供应商越容易被换掉,续约报价就越讲道理。
三类人三本账
入门/本地推理党: 先不动。数字全是官方口径,等第三方在你这类负载上的复现出现再决定。
中度训练/部署、有续约压力的: 不用迁移,但值得做两件事——盘点仓库里有多少 CUDA 专属依赖(自研 kernel、通信库、profiler),算清重写账;然后带着"我随时能走"的底气去谈续约。这本账本身就能省钱。
深度写 kernel、优化运行时的: 这反而是新的考题。同一个月里 AMD 展示了另一半真相:8 张 MI355X 上只换运行时和内核,15 秒视频成品 MP4 产出从 SGLang 基线的 150.5 秒降到 6.49 秒,约 23.2 倍(官方博客口径)。 硬件只是分母,工程才是分子。PrivateUse1 + StableHLO + bounded dynamism 这套编译栈,就是下一代运行时工程的主战场。知乎
接下来盯四个信号
PyTorch/XLA 是否发布正式 EOL 公告——那才意味着谷歌真把旧路封了;
TorchTPU 出现第一个业务负载级的第三方复现数字;
TPU 自研内核逃生口的算子覆盖率,对比 Trainium NKI 的成熟度;
TPU 在 Google Cloud 之外是否可采购——这是"真选项"和"谈判筹码"的分界线。
改一行代码换芯片,这事是真的;一行代码之后还要花掉多少钱,现在还没有人替你测过。