机器人不翻跟头,改算账了:8小时数据只剩3.5小时能用

源自69位全网作者

20:09

今年11月的具身智能圈,风向微妙地变了:没人再翻跟头了,所有人都在算账。

截至10月30日,国内具身智能VC/PE投资额约1618亿元,是去年全年的3倍多;但7月起融资开始回落,10月单月已不足80亿元,环比降超40%。"资本寒冬"的说法又上了热搜。知乎·智能纪元AGI

先别急着唱衰。11月12日的百度世界大会具身智能分会场上,业内人当场摆出了一组行业数据账单。我听完的感受是:这不是泡沫破了,是机器人准备开始上班了。知乎·智能纪元AGI
机器人不翻跟头,改算账了:8小时数据只剩3.5小时能用

第一笔:数据账——采集员干8小时,只有3.5小时能用

大语言模型命好:互联网几十年的文本摆在那,捞起来洗洗就能训。机器人没这个福气,它每一条"动作经验"都要从零制造。

数字很残酷:一个采集员干8小时,真正能进训练管线的数据只有3.5小时;每新增1万小时第一视角数据,光相机位姿处理就要烧掉3.7万到11.4万GPU卡时。原始数据要过15到20道工序才能下锅,有公司光处理数据就干了两年;100万小时层层筛完,进得了模型的可能只剩几万小时。知乎·智能纪元AGI

上海交大副教授李永露给的对照是:目前行业最强的具身模型约7B,能吃下100万小时数据,而想要理想能力,可能需要1亿小时数据来"洗"。36氪的类比更直观:GPT-3的训练数据是GPT-2的约30倍,如果具身模型照同样的幅度扩数据,从50万小时出发,下一阶段可能需要1500万小时。这就是业内说的"30倍数据缺口"。知乎·智能纪元AGI36氪
机器人不翻跟头,改算账了:8小时数据只剩3.5小时能用

第二笔:算力账——16卡想压成8卡,不寒碜

“现在两机16卡,能不能压到单机8卡,效果不变?”——这是具身智能公司眼下问云厂商最多的问题。知乎·智能纪元AGI
不是抠门。卡越来越贵、供应越来越紧,省下来的每一分钱,都是下一轮动辄10亿级的模型迭代费。算账能力,正在取代讲故事能力,成为创始人的一号位技能。

第三笔:交付账——Demo成功一次,干活要成功一万次

这笔最要命:Demo可以只成功一次,交付必须成功一万次。
银河通用联合创始人张直政举过一个很诚实的例子:他们的机器人能把30分钟家务零失误做完,前提是它是在"刷过题"的场景里干活——换个没见过的厨房、锅、油温,很难说还灵不灵。华为云具身智能团队的吴小东说得更直白:当下的机器人,一遮挡就"瞎",一动起来就"傻"。知乎·智能纪元AGI知乎·AI早餐汇

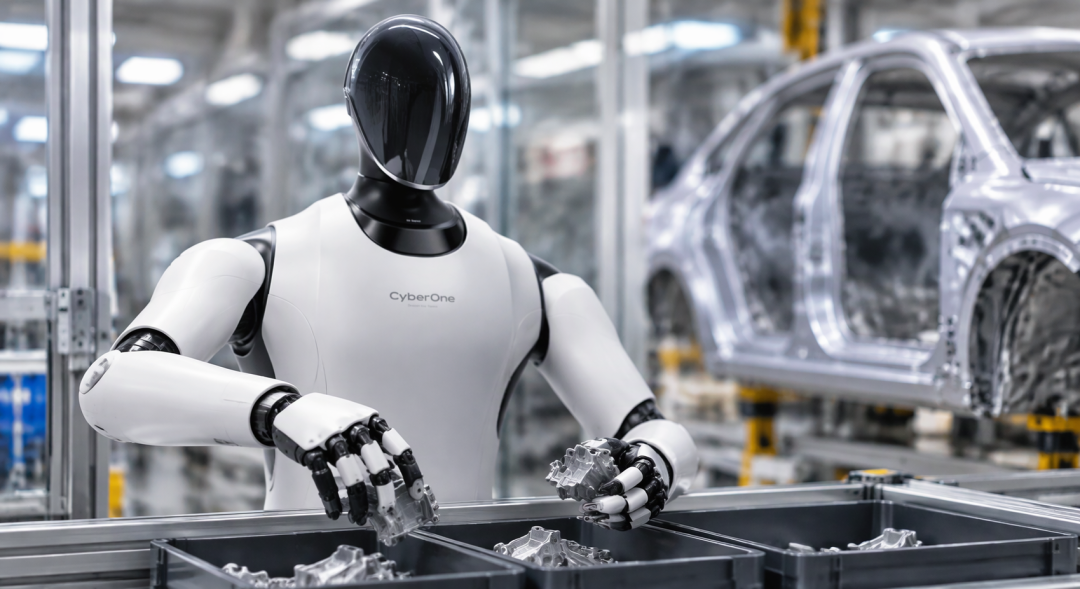
所以11月初,小米CyberOne02在汽车工厂连续8小时分拣零件,才会被当成标志性事件。评论区直接分裂:一边说"这么简单的动作也要吹?“;一边是去过汽车工厂的人回"你才知道这含金量”。两边其实都对:单个动作不难,难的是8小时不停、不错、没人盯。微博·包容万物恒河水
机器人不翻跟头,改算账了:8小时数据只剩3.5小时能用

普通人该看什么

下次再刷到机器人演示视频,你手里有了一套评分标准:看场景有没有刷过题、看它出错后能不能自己恢复、看后台有没有人盯着。整个行业的期末考题其实早就统一了——机器人独立干完一个班次,连续八小时稳定运行、不需要工程师守在旁边,遇到意外能自主恢复,第二天还能重复。36氪

宇树王兴兴给"ChatGPT时刻"划了一条清晰标尺:在约80%的陌生场景里,靠语音或文字指令完成约80%的任务,他认为2027年很大概率会成为机器人行业的临界点。微博·21世纪经济报道微博·极客公园
从这三笔账看:账算平的那天,才是那个时刻真的来的那天。
内容由AI生成

精选参考来源

1. 具身智能开始算账:1万小时数据,先烧掉37000张GPU卡时

2. 30倍的数据缺口,谁来给具身智能续命?

3. 遮挡就瞎、一动就傻:华为云吴小东讲透具身智能这道坎

4. 🔻CyberOne 02 人形机器人在小米电动汽车工厂连续完成了 8 小时工作,与 AMR 协作分拣和放置零件,标志着其首次实现产线级作业能力。🔻由小米机器人基础模型 Xiaomi-Robotics-1 驱动(10 万小时的 UMI 预训练)。#热点聚焦##人工智能机器人##微博视频精选大赏# 包容万物恒河水的微博视频

5. #王兴兴谈机器人自进化#【王兴兴:建立机器人领域自进化循环,人的价值只剩打分和设目标】“具身智能很快就会迎来具身智能的ChatGPT时刻。”11月4日,在#2026年世界互联网大会乌镇峰会#的互联网企业家论坛上,宇树科技董事长、创始人、首席执行官王兴兴再度谈及这一近期其多次提及的观点。具身智能的ChatGPT时刻,意味着“基本上在80%的陌生场景中,通过语音或文字指令,机器人就能够顺利实现80%的任务。”谈及机器人领域的自进化,王兴兴表示,目前全球最顶尖的模型某种意义上已经在内部实现了自进化,也就是让AI模型自己采集数据、自己训练和自己迭代,在这样的自进化循环中,人类仅需很少地参与对模型的打分。然而,在机器人领域,全球头部机器人企业尚未建立这样的自进化循环。在王兴兴看来,建立机器人领域的自进化循环,目前人最大的价值只剩下给AI模型打分来评价模型输出的结果,以及设置目标让AI模型去实现。“但是渐渐AI模型也会学会人类的这些评价指标和偏好,就可以自己进化成越来越强的模型。”网页链接 (@21世纪经济报道 记者 陈归辞) 21世纪经济报道的微博视频

6. #极客热点播报# 【# 王兴兴判断明年是机器人行业临界点 #,具身智能迎「ChatGPT 时刻」】据证券时报报道,在 2026 年世界互联网大会乌镇峰会互联网企业家论坛上,宇树科技创始人、董事长王兴兴表示,具身智能正在迎来「ChatGPT 时刻」,2027 年很大概率会成为整个机器人行业或机器人模型发展的一个临界点。他进一步解释,具身智能的「GPT 时刻」,是指机器人能够在约 80% 的陌生场景中,通过语音指令完成约 80% 的任务,目前全球顶尖模型距离这一目标已经非常接近,但仍存在关键技术障碍。#宇树科技# 王兴兴将当前最大的障碍概括为「最后几毫米的问题」——AI 模型对物理世界的接触,尤其是拆机、装配等细微操作中的触觉接触与物理对齐,做得还不够好,「AI 模型的输入输出和真实世界的对齐还是差了一点」。他认为,机器人对触觉等信息仍缺乏足够准确的理解,而这恰恰是完成复杂操作的关键,预计这类问题有望在未来一至三年内得到解决。据财联社报道,王兴兴同时透露了宇树科技在技术路径上的最新探索:公司已在内部启动物理 AI 模型自进化的尝试,让 AI 模型自己编写代码,在仿真或真实环境中训练,再部署到机器人上测试,由人类或机器人对结果打分并反馈给模型,形成迭代闭环。他指出,目前包括宇树在内,机器人数据的利用率仍然偏低,大量数据没有得到充分利用,而随着基础模型能力增强,模型的自我进化能力和数据利用效率有望显著提高。(来源:36氪)

0
扫一下,分享更方便,购买更轻松
0评论

当前文章无评论,是时候发表评论了
提示信息

取消
确认
评论举报

最新文章 热门文章
相关兴趣推荐