很多团队都有这样的知识库问答经验:把整本产品手册塞进模型上下文,心想「都在里面了,总不会漏」。一位从业者分享过类似的经历:一个团队把完整的180页手册塞进200K窗口,用户问「保修期多久」,模型反而答错;改成只检索手册里最相关的3段,反而答对了。知乎
窗口越大,模型越稳——这个默认假设并不成立。
Anthropic在2025年9月发布的工程文章《Effective context engineering for AI agents》把这种现象命名为context rot(上下文腐烂):窗口里token越多,模型从中准确抽出关键信息的能力反而下降。Chroma在2025年的测量同样发现,性能随窗口占用率上升单调走低,哪怕塞进去的内容全部相关。更早的2023年研究《Lost in the Middle》则显示:模型对开头和结尾的信息利用得好,中间的信息明显变淡,正确率随位置呈一条U形曲线。知乎知乎知乎知乎
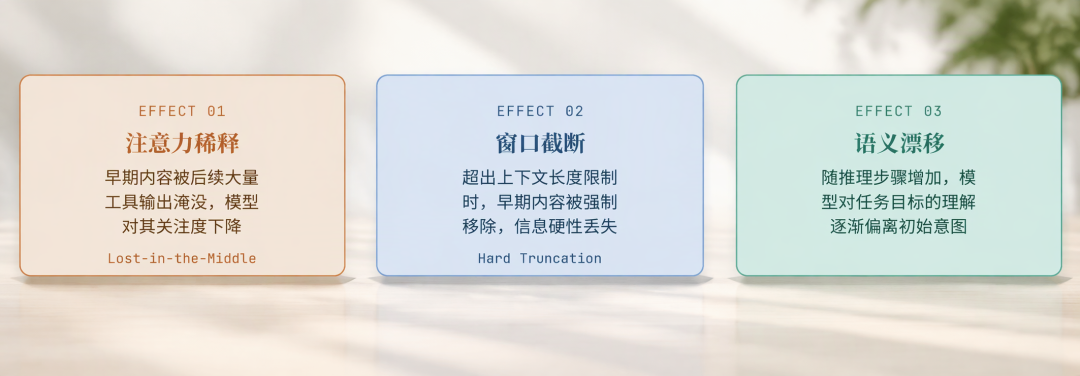
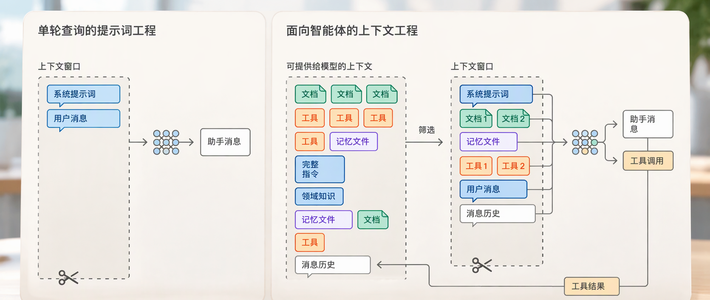
窗口是工作台,不是硬盘。「塞得进去」和「会被用上」是两回事。提示词工程占据焦点数年之后,讨论重心如今转到「上下文工程」:往窗口里放什么、放在哪、放多少,成了决定产品效果的主要变量。知乎知乎
日常开发里,有可以动手的地方。
每次调用前先做一次分类:哪些材料必须每次都带着,哪些用到再取,哪些用完就可以清掉。Claude Code走的就是混合路线:CLAUDE.md项目说明默认预装,具体文件用glob、grep按名字或关键词现取,而不是每次把整个代码库塞进去。这并非没有代价:运行时现翻通常赶不上预先算好的检索。工具没设计好,模型还可能走错路,把窗口浪费掉。所以在法律、财务这类内容相对稳定的场景,常见做法是预放一部分资料,其余留给模型按需再查。知乎知乎
另一个性价比更高的动作,是把系统提示词这类固定前缀稳定下来,命中KV缓存。从业者的经验是,缓存命中率的提升,收益往往大于打磨提示词措辞。知乎
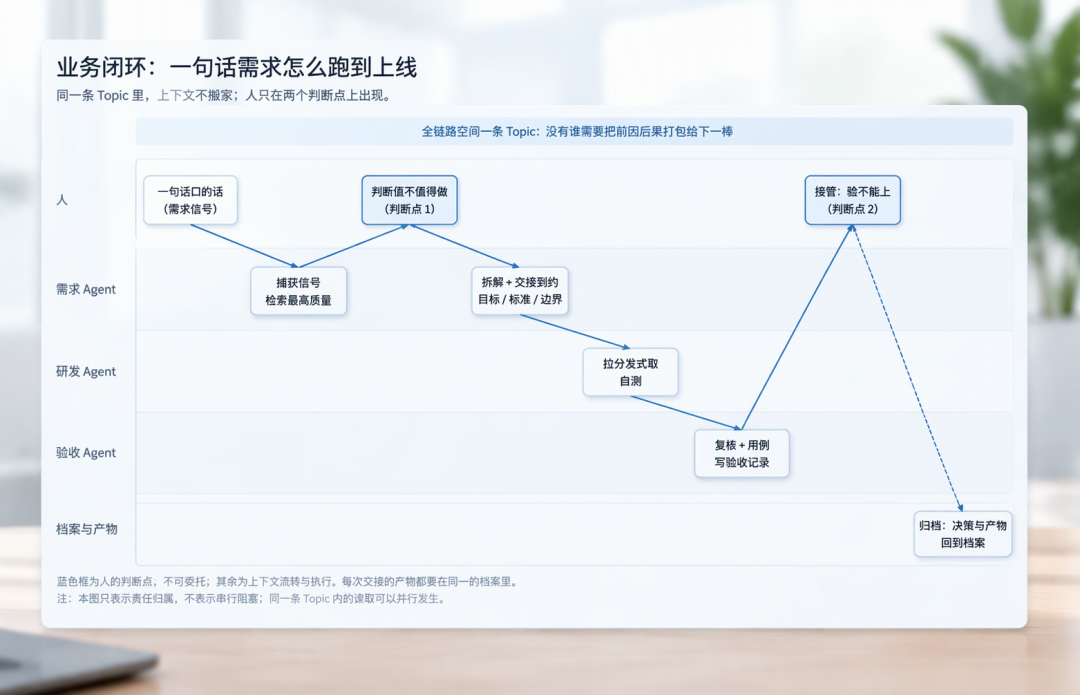
长任务跑起来,不能只靠把窗口撑大。Anthropic给出了三种接力:来回对话多的任务,用压缩(compaction),把内容做成摘要带进新窗口——但被压掉的信息回不来,压缩不是无损兜底;有明确里程碑的迭代任务,用结构化笔记,把进度写到窗口之外,形式可以是待办列表或一份NOTES.md,窗口里只留指针;可以并行的深入研究,用子智能体,在干净窗口里独立跑完,只回传一两千token的摘要,不把检索全过程装进主窗口。知乎
下一次调用模型之前,先看看窗口里已经放了什么。别问「还剩多少地方」,问「可以拿走什么」。