

今天AI圈最大的动静,是一家做Claude的公司终于敲定了上市价格,而另一边,模型已经开始帮芯片公司改芯片了。这两件事凑到一块,多少有点时代交替的味道。下面这8条,是今天我觉得真正值得花几分钟看一眼的。
1. Anthropic上市价定了,83美元一股,今天挂牌
当地时间11月18日晚,Anthropic把IPO发行价定为每股83美元,比原先70到78美元的区间高出一截,发行规模也同步扩大。按安排,股票今天(11月19日)以代码ANT在纳斯达克开始交易,预计公开发行募资约685亿美元,加上同步私募配售的260亿美元,合计约945亿美元。这个数字已经超过了今年6月SpaceX上市时的基础发行规模。
更夸张的是需求——机构认购意向约4000亿美元,散户接近1000亿美元,虽然都还是非约束性的意向,但热度可见一斑。有意思的是,就在同一天,OpenAI刚把旗舰模型降价两成,摆明了要在性价比上正面硬刚。
解读: 这是前沿大模型公司第一次真正站到公开市场的聚光灯下。83美元的定价能不能站稳,其实是在给"AI到底值多少钱"这个问题标定一个公开答案。一边是资本愿意为顶级模型公司开出万亿估值,一边是模型价格还在快速往下掉,这两条线能同时成立多久,是接下来一两年最值得盯的故事。普通投资者更该关心的,恐怕不是首日涨多少,而是这些公司的算力账单什么时候能真正变成利润。
2. 谷歌发了个新模型Gemini 4 Neon,主打又快又便宜
11月19日凌晨,谷歌宣布Gemini 4 Neon向Google AI Pro和Ultra订阅用户开放,手机、桌面、网页三端都能用。这个新模型卡在Hydrogen和Carbon之间,专门对付那些既要前沿推理、又要求快速响应的活儿。
官方给的数据挺能打:Artificial Analysis智能指数拿到61分排第三,编程智能体指数以58.6分登顶,在另一家Vals Index上以70.9%排第二。价格是每百万输入Token 3美元(缓存输入0.15美元)、输出15美元,支持100万Token上下文和四档思考等级。谷歌还说,它的单任务成本比Carbon低了32%。
解读: 谷歌这次的思路很清楚——不跟你硬拼最强,而是在"够强而且够快够省"这个位置上卡位。对日常用AI干活的人来说,这类中间档模型的实际体验往往比旗舰更实在:响应快、成本低、能力也够用。模型竞争从"谁分最高"转向"同样能力下谁更划算",对掏钱的用户来说总归是好事。
3. AI开始帮芯片公司设计芯片了,AMD已在用
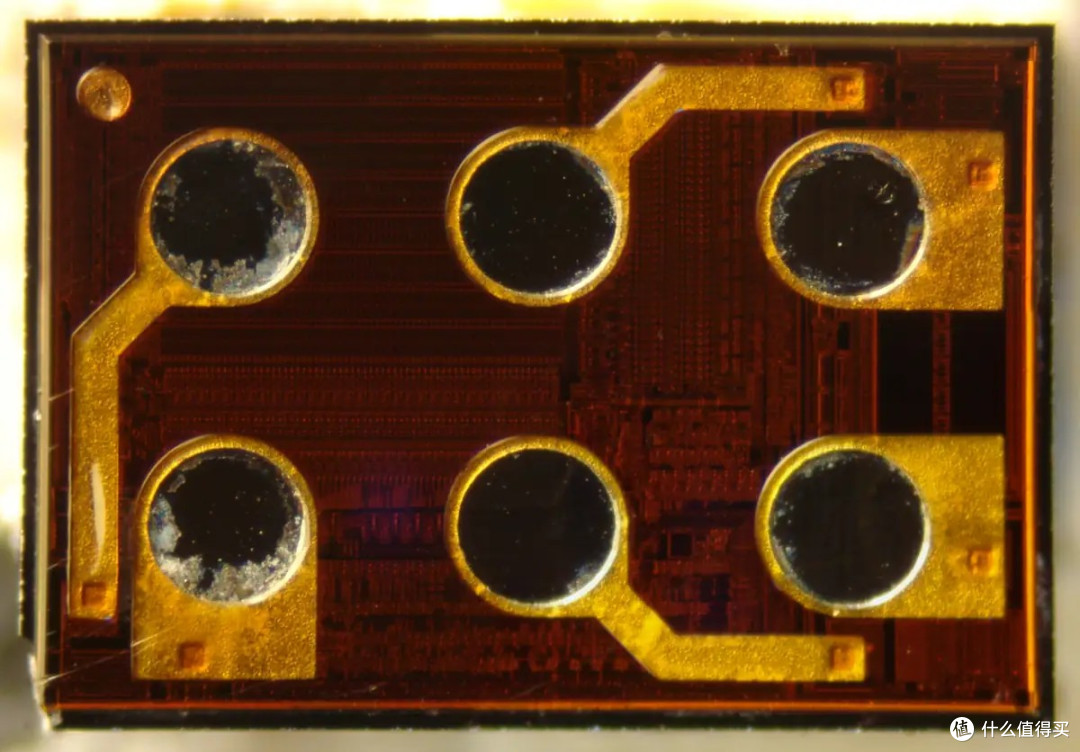
11月18日,OpenAI发了一篇技术博客,披露了用自家模型做芯片设计的进展。跟AMD合作的部分最亮眼:模型通过改写描述电路的RTL代码,在AMD旗舰GPU IP上实现了最高14%的PPA(功耗、性能、面积)改善——这还是在AMD工程师已经优化多年的基础上做出来的,OpenAI形容相当于"不到5个月完成了大约一年的进展"。
AMD已经把部分改动用进了近期送去流片的设计。OpenAI自己的首款推理芯片Jalapeño也吃了这套方法的红利,向量单元和矩阵单元的标准单元面积分别减少约13%和10%,而且已经在真实硅片上验证过。下一步,OpenAI还要跟Synopsys合作训练专用于EDA工具的GPT-Synopsys。
解读: 这条的意义比数字本身大得多。过去芯片设计里最费人、最不可替代的底层优化工作,现在模型能以专家级微架构师的思路插手,还被真的用进了量产设计。如果说英伟达的护城河之一是那套别人写不出来的软件栈,那么当模型能在周末写完这些底层代码,这条护城河看起来就没那么深了。AI反哺算力本身的迭代,很可能是接下来算力竞赛里被低估的一条曲线。
4. 腾讯三季报:AI-related支出猛涨,WorkBuddy日活破千万
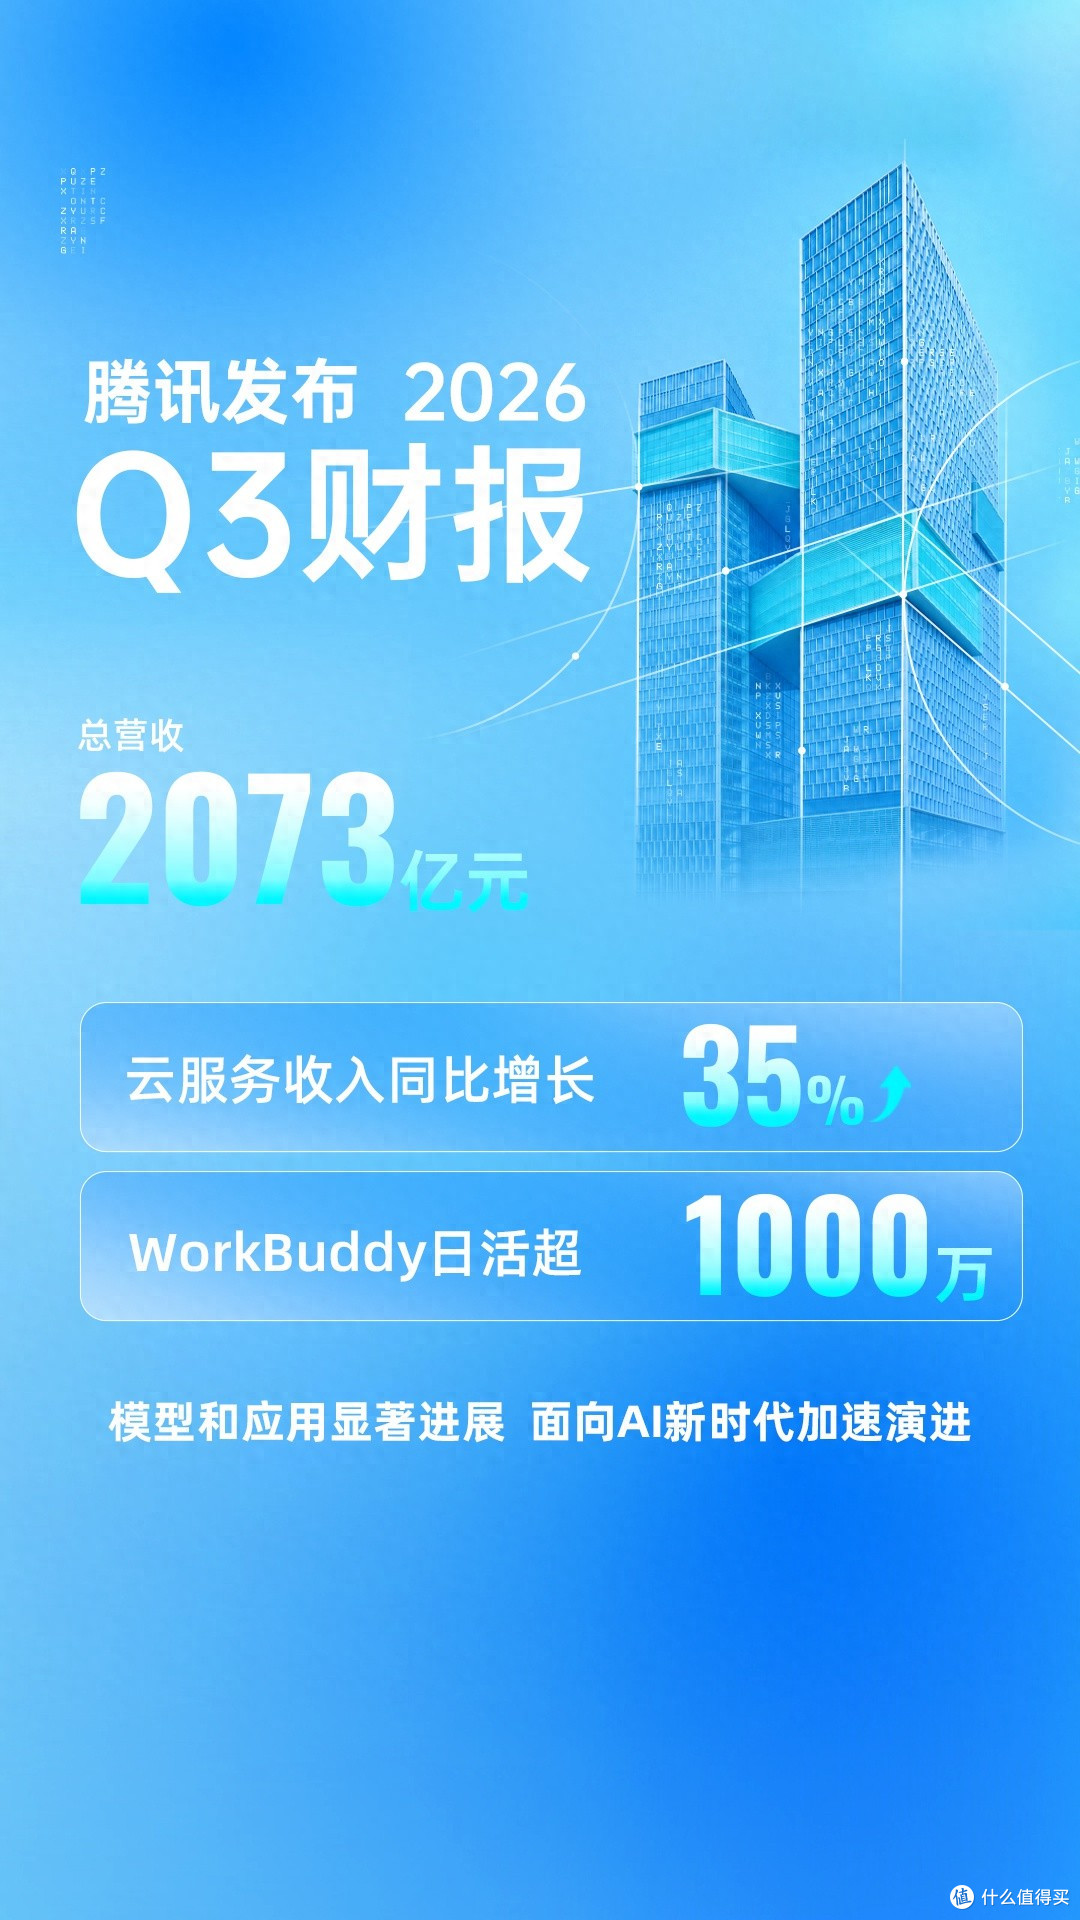
11月18日,腾讯公布2026年第三季度财报。总收入2073.4亿元,同比增长8%。真正的看点在AI这条线:季度资本开支付款651亿元、同比大涨226%,研发投入323.6亿元、同比增长42%。
马化腾在财报里专门点名了WorkBuddy——按用户每日大模型Token消耗总量算,它已经是国内规模最大的AI应用,日活跃用户超1000万,日均Token调用量超100万亿。受AI需求带动,腾讯云服务收入增速提升到了35%。不过硬币的另一面是,若计入新AI产品,非国际准则经营盈利同比降了6%到681亿元,利润短期被投入吃掉了不少。
解读: 这份财报基本就是国内大厂AI投入现状的一个样本:一边是应用侧用户和调用量爆发式增长,一边是资本开支和研发费用猛踩油门,利润表短期承压。对普通人来说,这意味着接下来一段时间各家AI产品的免费额度和补贴大概率还会继续——大家都在抢用户。但能不能把这波用量变成可持续的生意,还得看后续几个季度。
5. 苹果拉20万人做健康AI研究,但不急着上功能
苹果联合临床AI平台OpenEvidence启动了一项名为"Apple Health AI Usage Study"的研究,面向美国招募最多20万名参与者,研究周期长达12个月。项目11月15日在HLTH大会宣布,11月17日起被国内媒体集中报道,今天仍出现在多家AI早报的要点里。
参与者用一个专门的iOS App提健康问题,答案由OpenEvidence基于《新英格兰医学杂志》《美国医学会杂志》《自然》等权威文献生成,并附上可查阅的来源链接。用户可以自愿共享HealthKit里的睡眠、心率、化验数据来获得更个性化的回答。苹果强调,研究数据不会用于训练任何AI模型,OpenEvidence会在24小时内删除问答数据。
解读: 苹果的谨慎和别家形成了鲜明对比——OpenAI、Anthropic早就让用户在聊天框里问健康问题了,苹果却先花一年时间、20万人的规模去研究"人们到底怎么理解、怎么信任这些回答"。这种"研究先行、产品后置"的做法慢是慢了点,但在健康这种高敏感领域,谁先把信任这件事做扎实,谁后面才更有底气。顺便说一句,这个项目目前只在美国开放,且不面向诊断和治疗。
6. 美国大行改条款:你把AI智能体放进账户,出事自己扛
据TechCrunch 11月18日报道,花旗银行本周更新了服务条款:如果客户把第三方AI智能体接入自己的账户,那么这些智能体产生的所有操作都由客户本人负责——哪怕问题出在AI工具泄露了你的凭证、或者被黑了。报道称,PNC在11月18日改了条款,摩根大通和美国银行上月也宣布了类似政策。
解读: 这条看着不起眼,其实是把一个关键问题摆上了台面:AI智能体替你花钱、替你操作账户,责任到底算谁的?银行的态度很明确——你授权进来的,出了事你自己兜着。这意味着普通人以后用这类工具,得把它当成一个权限极高的自动化脚本来对待,而不是什么贴心管家。随着智能体支付、智能体理财慢慢落地,这类责任划分的条款会越来越多,用之前多读两行小字,比什么都实在。
出处:TechCrunch
7. 波士顿动力的Atlas要进晶圆厂了,2027年初开始测
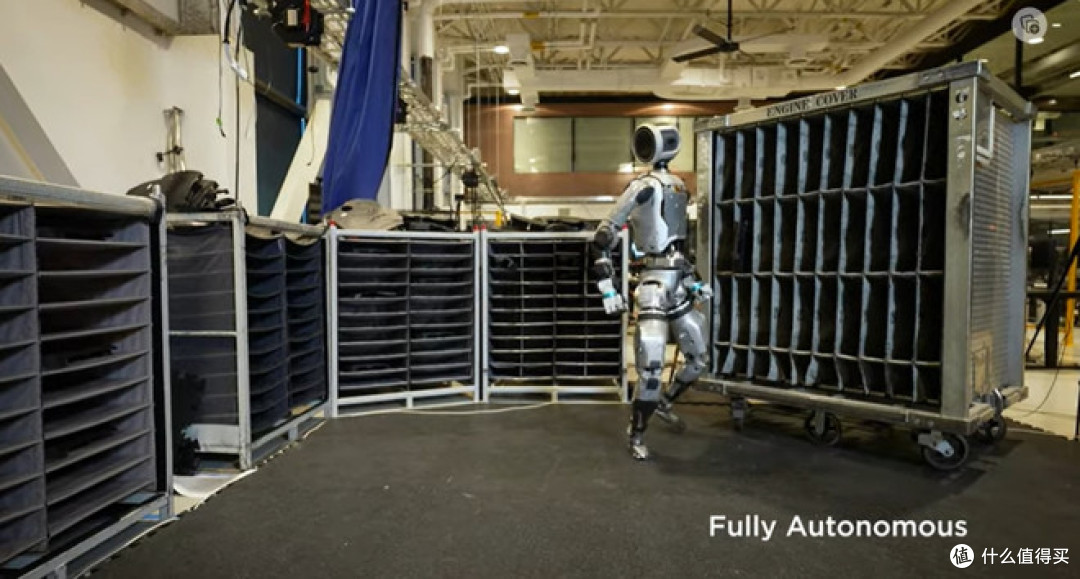
波士顿动力宣布与格芯(GlobalFoundries)达成合作,新一代Atlas人形机器人将于2027年初进入格芯的晶圆厂开展测试,承担物料转运、设备巡检、洁净室辅助操作等任务,验证人形机器人在高端半导体制造场景里的可行性。
解读: 晶圆厂是典型的高精度、高洁净度场景,对机器人的可靠性要求苛刻。人形机器人能切进去,说明具身智能正在从"工厂搬箱子"这种相对粗活,往制造的核心环节渗透。不过也得泼点冷水——"2027年初开始测试"离真正规模化上岗还有距离,这更像是一次场景验证。值得留意的是路线之争:这类高精度场景到底是人形机器人赢,还是专用自动化设备更划算,现在还没到下定论的时候。
出处:网易·前沿在线
8. 具身智能的最大瓶颈还是数据,有人用代码生成视频来补
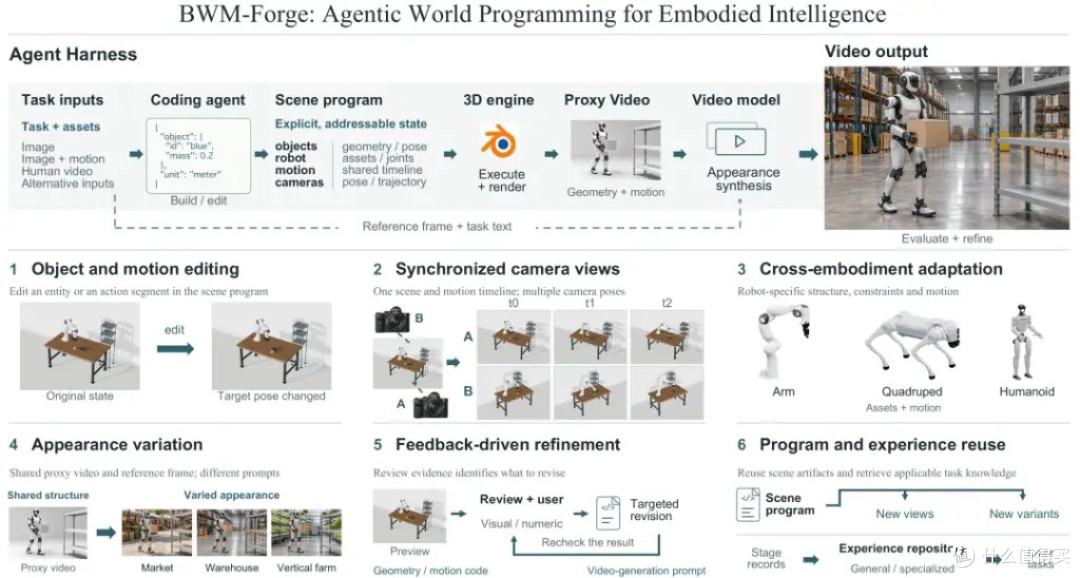
考拉悠然联合同济大学发布了BWM-Forge,一套面向具身智能的数据生成工具。它的思路是用代码驱动生成高质量的视频数据,批量产出机器人的运动和交互训练样本,从而大幅降低真实世界采集数据的成本。
这套工具能精准控制物理参数和动作变量,生成的数据可以直接拿去训练具身模型。同一天的另一篇产业报道也提到,行业普遍认为具身智能要走出概念验证阶段,数据、模型、本体、应用这四关一关都绕不过去,而数据被放在了第一位。
解读: 具身智能这两年不缺模型、不缺机器人本体,真正卡脖子的是训练数据——真实世界采集又慢又贵,还得处理各种意外情况。用可控的代码去"造"数据,本质上是想把这个瓶颈从物理世界搬到数字世界里解决。这条路能不能走通,关键看生成的数据和真实场景之间的差距有多大。如果合成数据真能顶用,具身智能的迭代速度可能会快上一个台阶。
今天就聊到这儿。有钱的盯IPO,干活的盯降价,搞技术的看AI造芯片——每一条都指向同一个方向:AI这件事,正在从"能不能用"进入"怎么定价、怎么担责、怎么规模落地"的新阶段。
当前文章无评论,是时候发表评论了