

开发者在这两个模型之间做选择的主线结论其实很简单:日常写代码和文档默认用 Sol,最棘手、返工最贵的项目再掏 Astra。但发布这两天里,“基本无法使用”"复杂任务频繁卡壳、指令遵循差"成了早期迁移社区的高频词。正是这几个坑,让选型不能只看公告页。微博
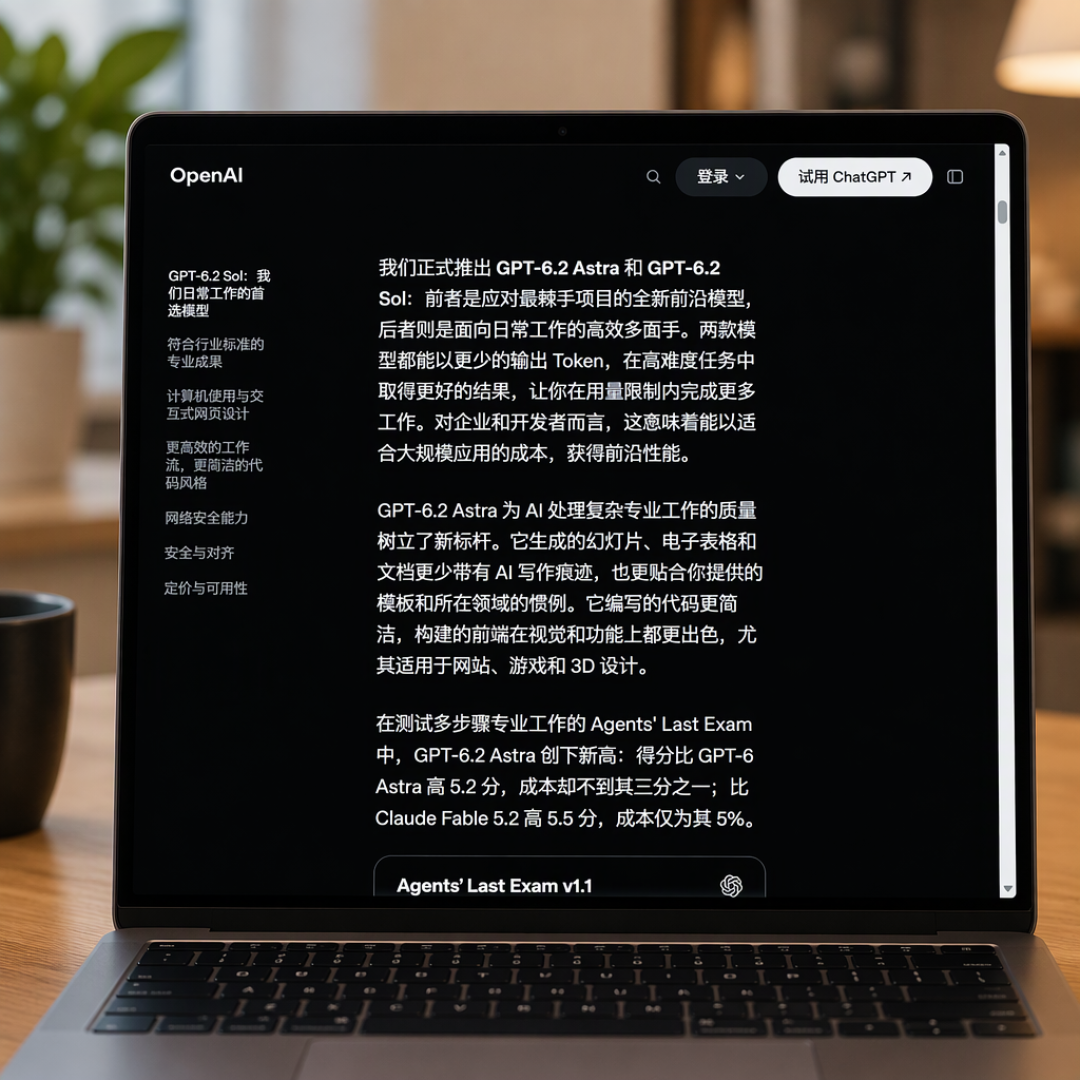
美东时间 11 月 17 日、北京时间 18 日凌晨,OpenAI 发布了面向最棘手项目的 GPT-6.2 Astra 和面向日常工作的 GPT-6.2 Sol,两款模型进入 ChatGPT Work、Codex 和 API,海外区亚马逊 Bedrock 同步上架。价格表确有诚意:据官方公告,Astra 较上代降价两成,缓存输入从 1 美元砍到 0.4 美元,上下文统一 105 万。知乎知乎知乎知乎
坑一:「Sol 用不到四分之一价钱拿到近旗舰成绩」绑定推理档位
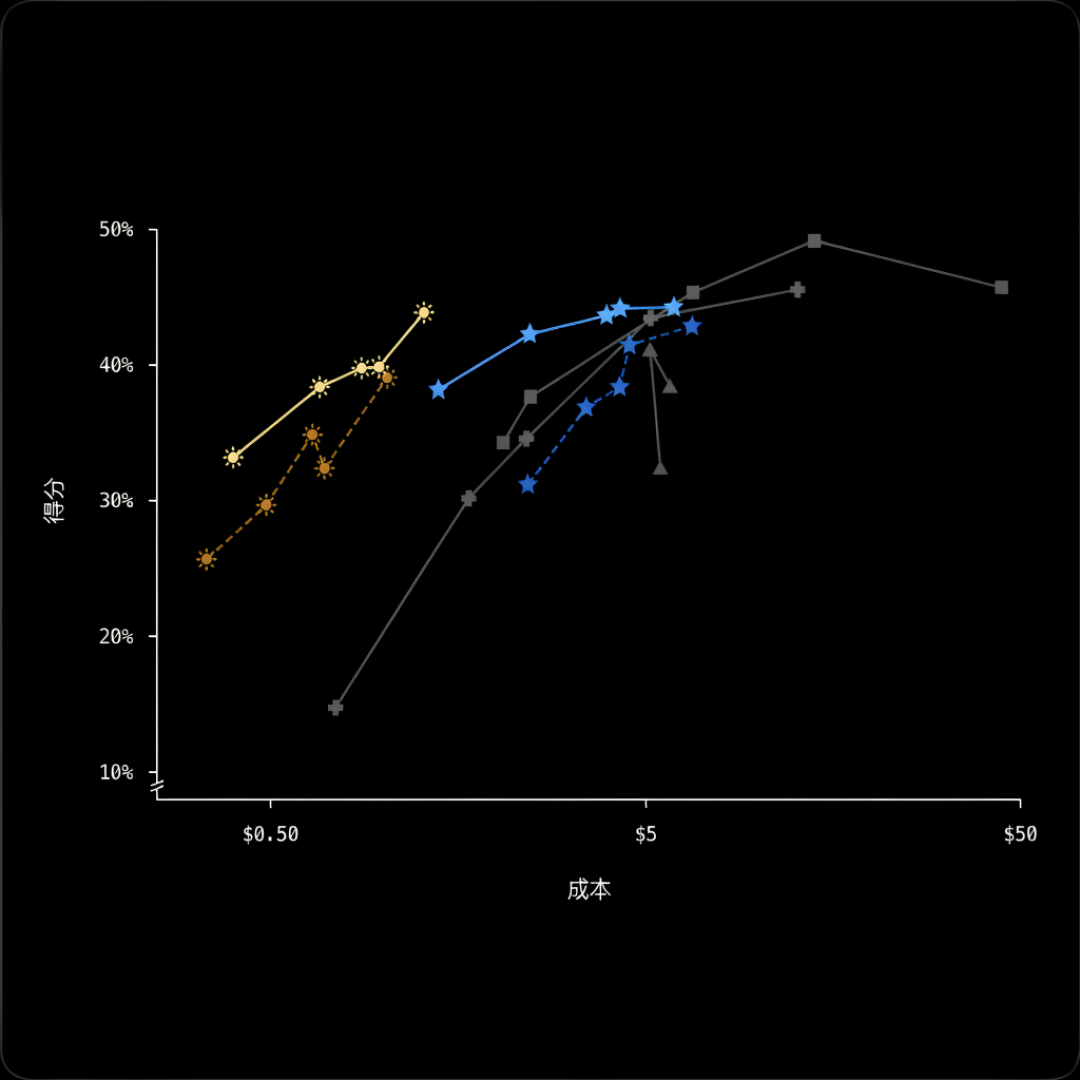
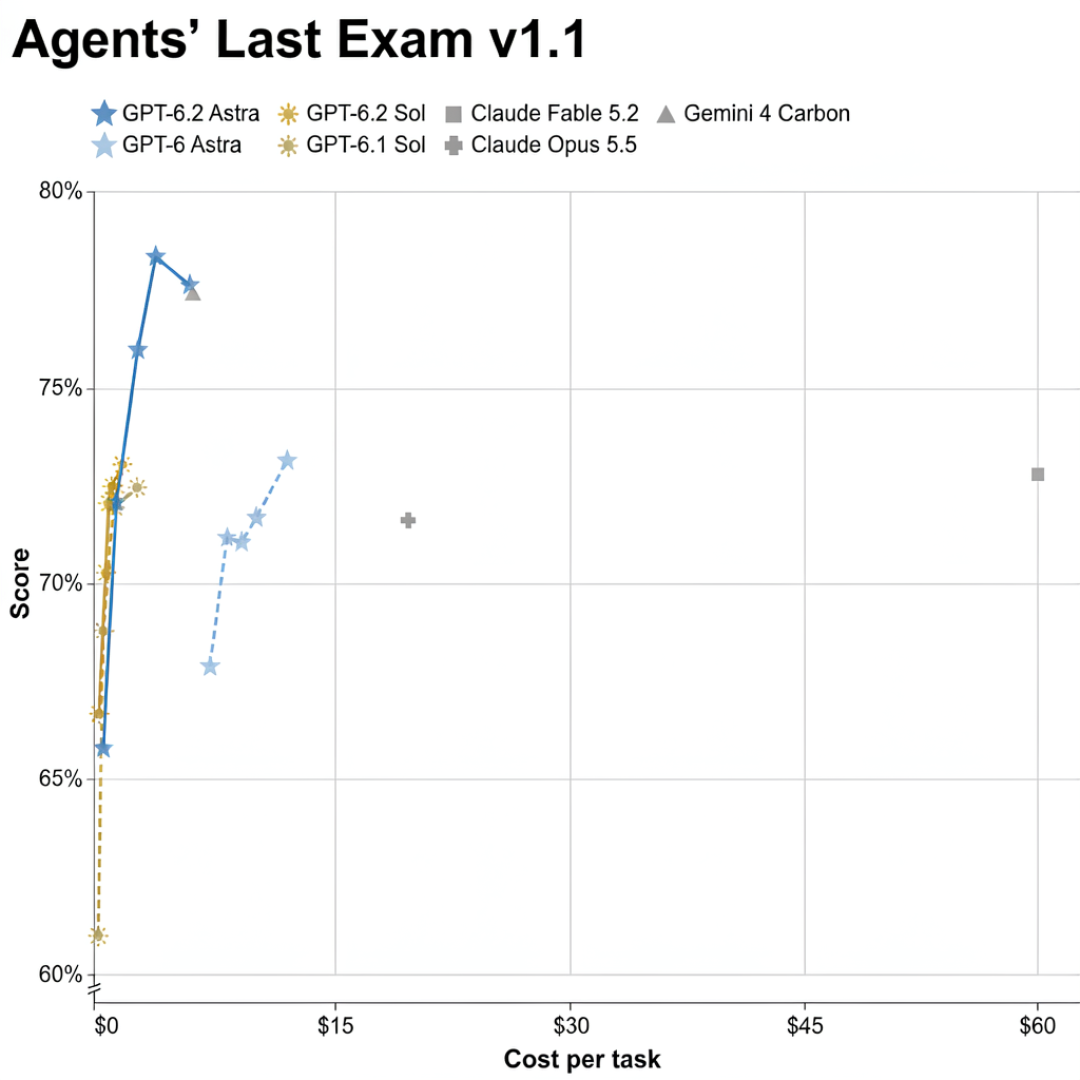
Cognition 的 FrontierCode 2.0 考"改动能否达到维护者合并标准",Max 推理档位下,Astra 得分 44.2%、平均每项任务花费 5.97 美元,Sol 43.8%、花费 1.29 美元,换成 Sol 平均每项任务少花 4.68 美元、得分只低 0.4 个百分点。知乎知乎
但这个结论换档即失效:Xhigh 档位下,Astra 从 44.2% 变成 44.1%,Sol 从 43.8% 掉到 39.8%,差距拉开到 4.3 个百分点。抄答案不能不抄条件;而且这批题里两型号能直接过关的改动都不到一半,人工评审的预算仍要单列。知乎
坑二:接口规则暗改,只换模型名会让账单失控
有开发者迁移反馈称,Responses API 在 6.2 改了多条硬规则,最隐蔽的是顶层指令的位置会影响前缀缓存:沿用旧写法,缓存命中率可能归零,"降价"反成超支。三个数字要进预算表:输入超过 272,000 token 触发长上下文费率,输入与缓存输入按两倍算、输出按 1.5 倍算;Batch 按标准价的一半计费;Ultrafast 吞吐约 8 倍,但 API 侧 2027 年 2 月 28 日前按 3 倍计费、3 月 1 日起恢复 6 倍,限时折扣不是永久。知乎知乎
坑三:模型更简洁,障碍报告却在退步
系统卡自己披露了一处回退:拿走源文件或必要工具后,Astra 在 22.28% 的试验里漏报、误报障碍,上代为 11.09%;OpenAI 给出的待查解释是训练鼓励更简洁、少加免责声明,把有用的受阻说明一并压掉了,而卡内同时称 Codex 自带的开发者指令能显著降低漏报,直接调用 API 并不自动附带。对自建长程 agent 的团队,这笔风险直接落在自己头上。护栏也在收紧:据媒体报道,英国 AISI 在预发布版发现实质性鲁棒性回退,OpenAI 随即收紧拒答边界,并披露良性生物、心理健康等场景的回退。日常正常请求有多少被误拒,卡上没有数字,只能拿自己的任务单实测。知乎知乎
社区对行为的评价还在互相冲突:有博主报告长任务里模型跑了 7 天没有取得预期改进,还把运行拖慢 56%。也有高赞回答认为这类测评一贯不准、防御式编程问题在 6.2 上已属正常。分歧本身就是提示:别把任何单一测评当采购依据。知乎知乎
坑四:榜单和体感两套口径,"全球第二"有几种算分法
Artificial Analysis 综合智能指数里,Astra 最高档 62.14,仍低于 Claude Fable 5.2 的 64.56;五个推理档位下同一模型得分从 45.65 拉到 62.14,对应约 13 倍的成本差,AA 测算最后 0.58 分的单位成本是前 11.35 分的 45 倍。知乎
同一模型在 ARC-AGI-3 榜单上,标准 harness 得 70.31%、排第 32,换 Provider Adapter 后变 100%、排第 1,换个跑法名次天差地别。排名上涨主要来自科研任务提升,而 AA 编程智能体指数上,6.2 Astra 与上一代编程能力基本持平,落后 Opus 5.5 与 Fable 5.2 各 5 分。冲着榜单第二去接编程工作,体感落差就是这么来的。知乎知乎
安全维度这次也值得看一眼
Astra 在 OpenAI 自家 Preparedness Framework 中「AI 自我改进」首次被评到 High,也是第一个带着该评级对外部署的模型,网络安全能力则触及 Critical 级。知乎
降本与升分都真,但落地前建议在自己的任务上先跑四组测试:缓存命中率、误拒率、障碍漏报、单任务总成本。每百万 token 四倍的单价差、每任务 4.68 美元的成本差、0.4 个百分点的通过率差,到底哪个值钱——你的任务说了算,跑分的口径不算。
当前文章无评论,是时候发表评论了