3060本地跑125B!显卡只是守门员,真正扛住的是那条内存

源自25位全网作者

15:45

2026年尾声,本地推理圈发生了一件反直觉的事:显卡开始摸鱼,内存开始加班。

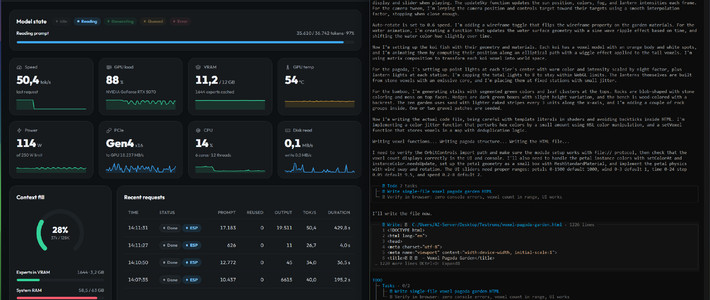
11月14日,B站UP主"玩客笔记"发了个实测:Xeon E5十二核老平台、96G内存、RTX 3060只有12G显存,跑Qwen3.8-Flash-Next 125B(IQ3_XXS量化),生成速度43-68 tokens/s——UP主自己标注仅单机验证。内存峰值59.5G,显存只占11.3G。评论区最扎心的一条留言:“12G显卡只是守门员,真正扛住的是那96G内存。”哔哩哔哩
3060本地跑125B!显卡只是守门员,真正扛住的是那条内存

同天知乎郑世录用5060 Ti 16G+64G内存也测了一遍:71.5GB的Qwen3.8 IQ3_XXS跑得稳,45-50 tok/s;换84.3GB的IQ3_S,内存只剩4.4GB,开几个浏览器标签就开始换页,速度直接跌进个位数。

为什么显卡能摸鱼?两篇实测指向同一个原因,MoE模型每次只激活一部分专家,显存不是用来"装模型"的,只放热点专家和注意力缓存,剩下大半权重躺在内存和磁盘里靠mmap按需读入。大模型的门票,从显存容量换成了内存容量。知乎

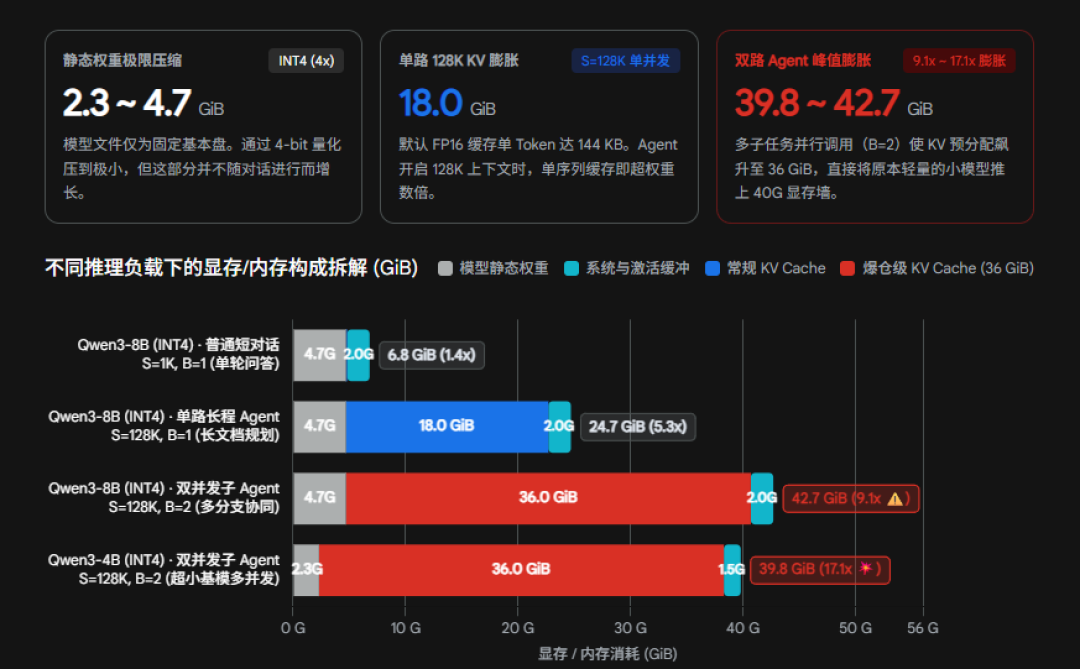
那内存为什么还是差点不够?知乎用户Tableau算过一笔账:模型文件只是冰山露出水面的十分之一。2.2GB的小模型日常聊天很轻,可128K上下文的KV cache就一口吃掉18GB;稍大点的8B INT4模型,双并发子Agent直接堆到42.7GB,撞上40G显存墙。Ollama、llama.cpp、vLLM这些框架还有内存预分配机制,上下文允许开多大,内存就先圈多大。瘦身也没什么玄学:KV量化到q8_0、上下文裁到64K、并发限1,42.7GB收回8.45GB,重回16G显存射程。知乎
3060本地跑125B!显卡只是守门员,真正扛住的是那条内存

新档位抄作业(综合显存表与多篇实测):

  • 8-16GB显存:目前天花板是Qwen3.6-35B,通吃;

  • 24GB显存:Q4的Qwen3.8-27B,个人用户基本到头,32G/48G显存跑的同一档,只是上下文更长;

  • 100B级MoE:看内存下菜——64G内存想稳,模型文件最好压在80GB以内,128K上下文还得留6G给系统。哔哩哔哩知乎
3060本地跑125B!显卡只是守门员,真正扛住的是那条内存

所以要不要升级显卡?两位作者的立场倒是罕见一致——郑世录把"一次做对"的复杂任务交给云端;黑虾的显存表写得更直白,“如果是正经写代码干活,还是建议订阅云端模型”。本地的舒适区是单文件代码、文档改写、批量脚本,外加数据不出自己硬盘。老显卡、小内存的组合,加内存条排在换卡前面。知乎
3060本地跑125B!显卡只是守门员,真正扛住的是那条内存

最后三个小坑。第一个,别迷信最小量化档,IQ3_XXS日常稳、IQ3_S难题更强,甜点在中间。第二个,读得快不算快,郑世录等1794个输出token干坐了317秒,“写得长就是慢”。第三个,国内HuggingFace下载常只有几百KB/s,换ModelScope镜像加aria2 -x8,能跑到10MB/s上下。知乎

评论区那条471赞的省流,已经替这轮判了胜负:“CPU?不是很重要。”。这轮赢的是内存。哔哩哔哩
内容由AI生成

精选参考来源

1. 125B 大模型做成全离线一键软件!12GB RTX 3060 实测 43-68 tok/s,直接给内网用

2. 16GB 显卡跑 176B 大模型:64GB 内存本地部署实战(Strata + Claude Code)

3. 本地跑大模型做 Agent,内存占用为什么会比模型文件大十倍?

4. 2026年本地大模型,显存需要表,8GB、12GB、16GB、24GB到底分别能跑什么?

5. 本地AI推理CPU重要吗?Strata框架上手测试|显卡日报

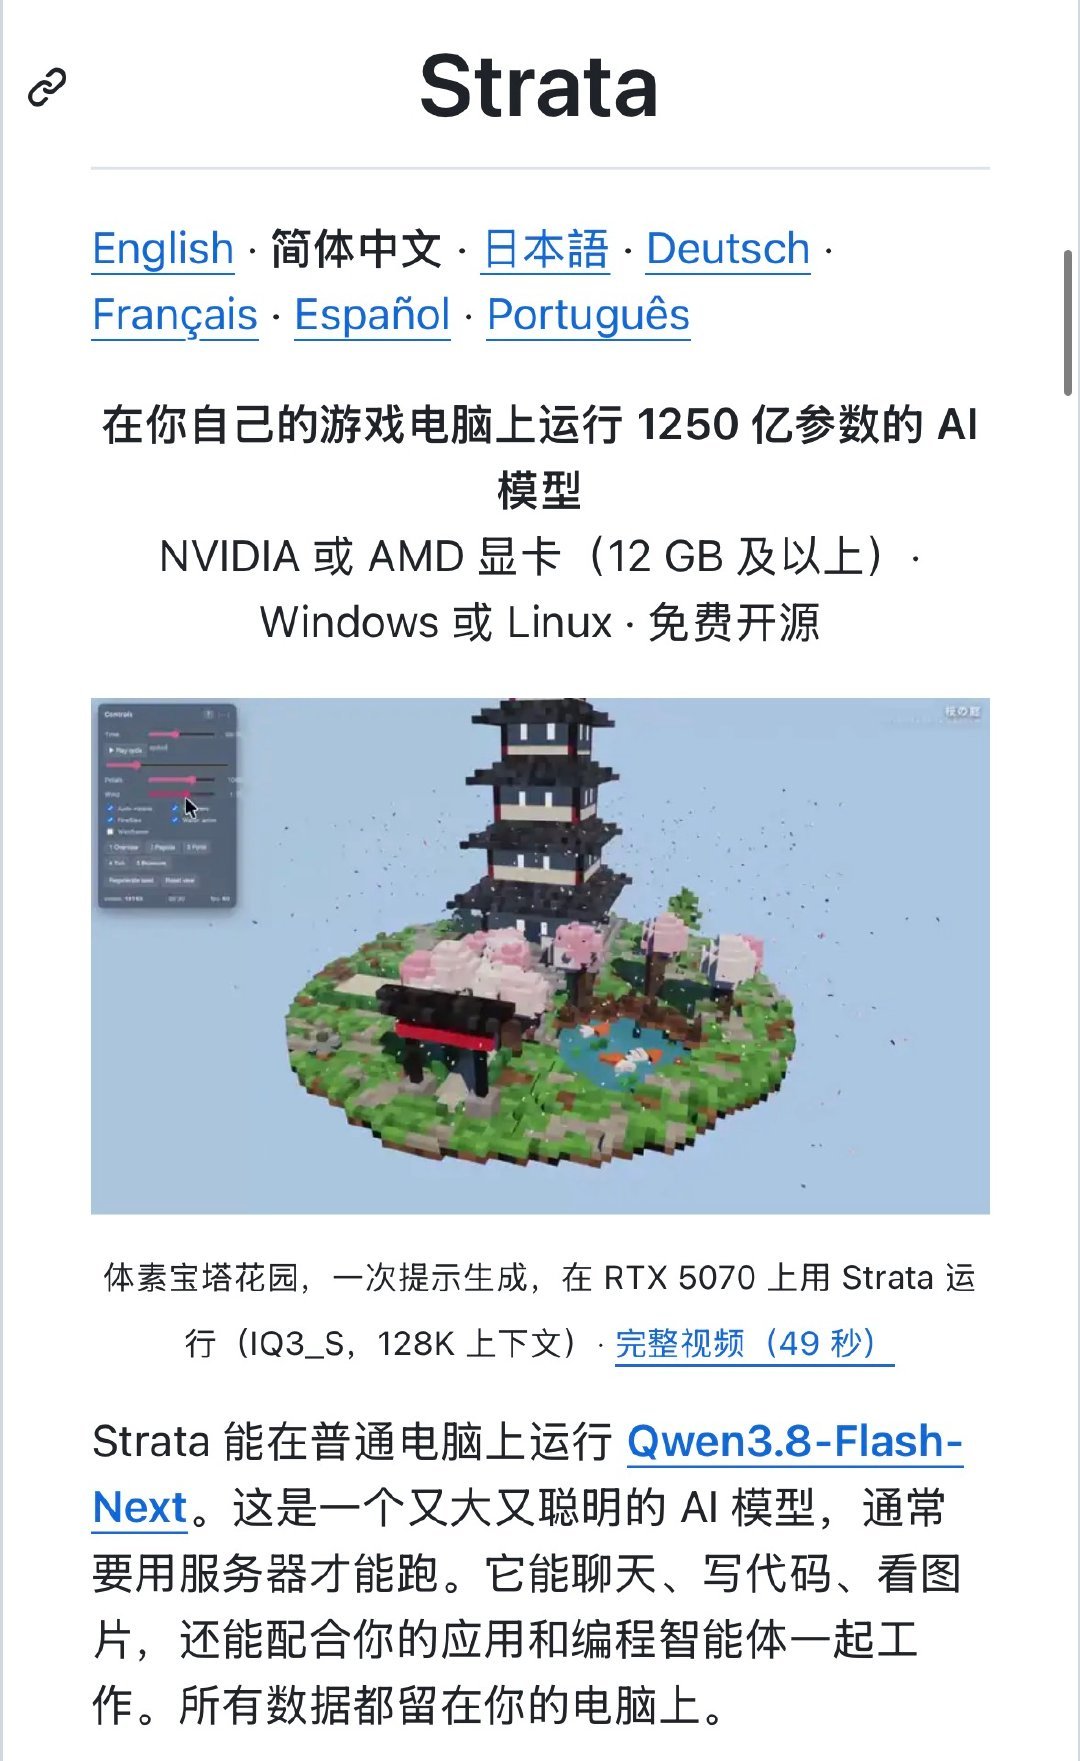
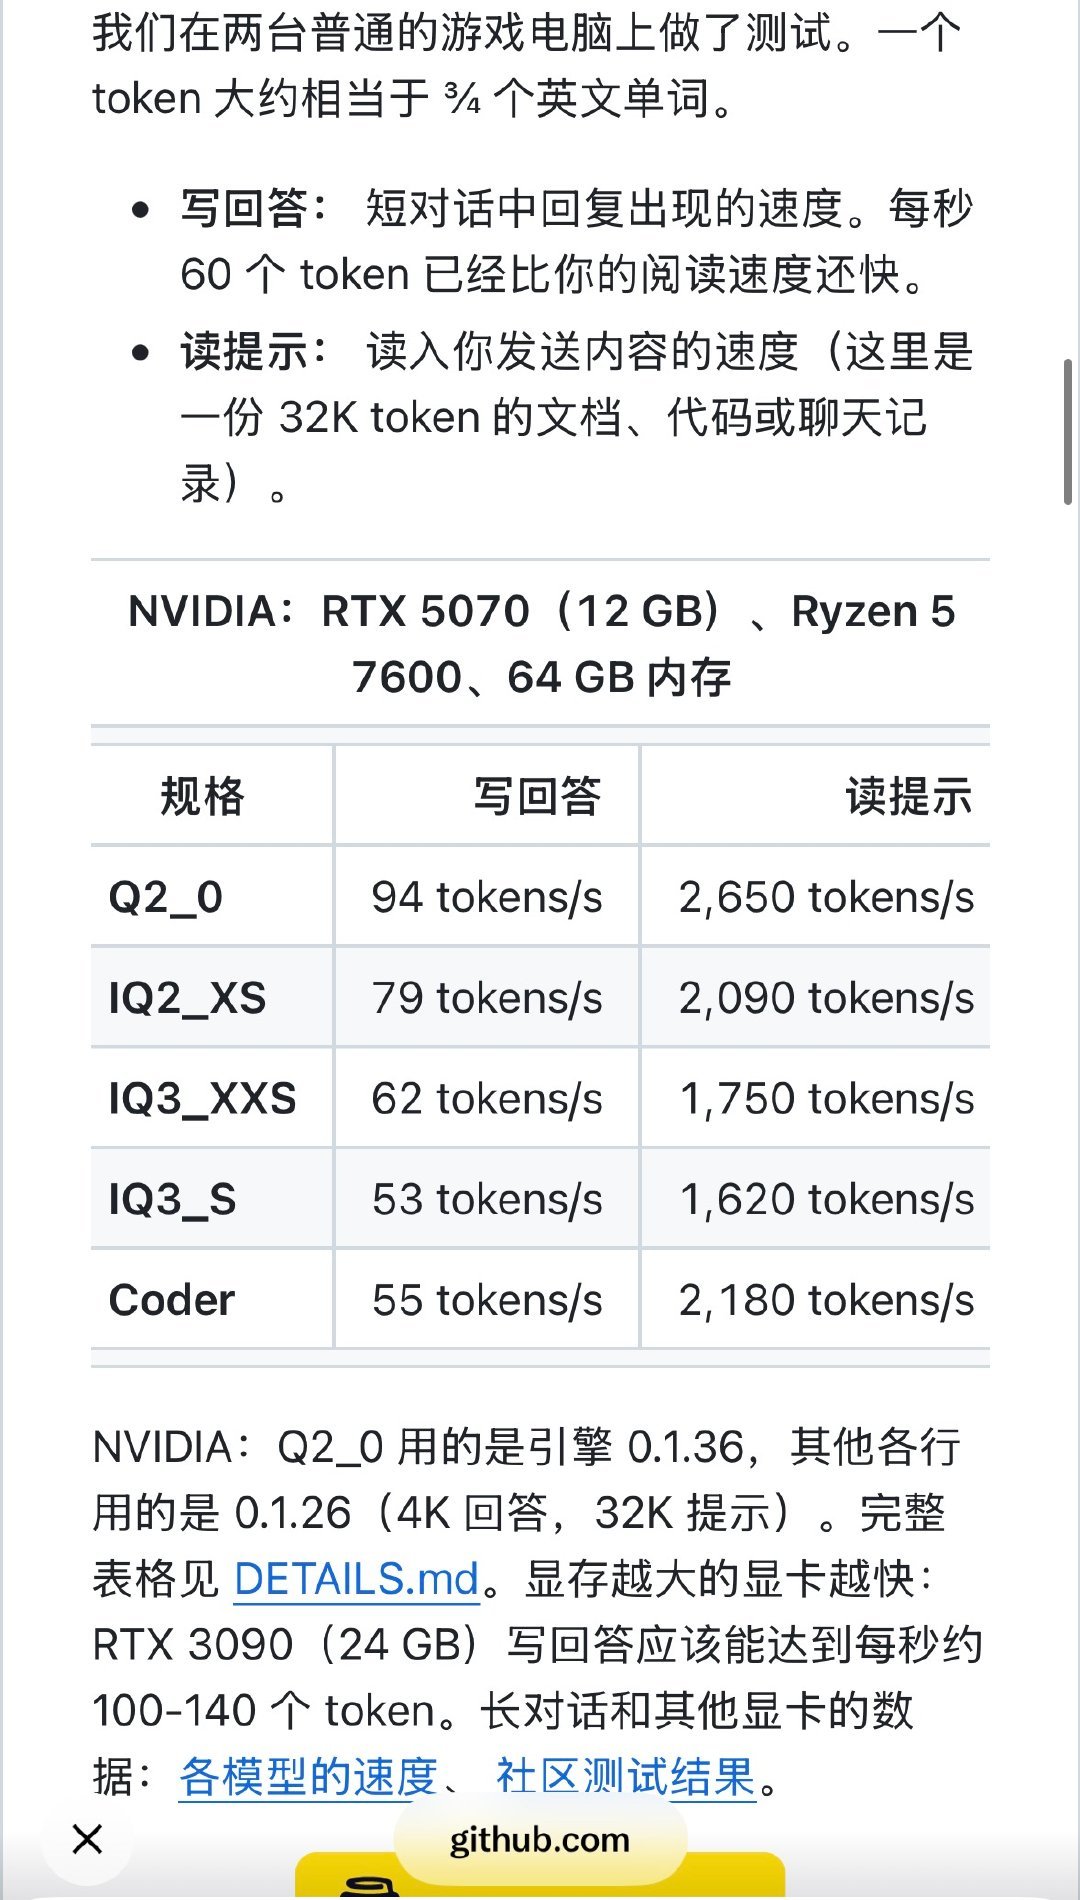
6. Strata 这个项目现在火爆了,确实有点强的离谱Strata 能在普通电脑上运行 Qwen3.8-Flash-Next!而且速率并不低!这个项目利用 MoE 模型每次只调用一部分“专家”的特点,常用的放显存,其余由内存和 CPU 配合处理,SSD 还负责一张查询表,负责调度作者的测试配置是 RTX 5070(12GB 显存)+ Ryzen 5 7600 + 64GB 内存,短聊天生成速度:Q2_0 版约 94 token/sIQ3_S 版约 53 token/s当然请注意,这个针对的目标还是2~3位量化,速率很快,准确率多少会差一些地址:github.com/Niko1221/Strata

7. 本地跑大模型的同学,可以试一下新出的推理引擎 Strata(github.com/Niko1221/Strata)。Strata 是专为 Qwen3.8-Flash-Next 开发的,针对模型做了深度优化。微博群里的同学实际试了一下:用 RTX 3090 跑 Qwen3.8-Flash-Next IQ3_S,短问答输出速度能到 67 tok/s,而同样硬件下 llama.cpp 只有 20 tok/s。我看了一下 Paper,Strata 针对 Qwen3.8-Flash-Next 的特点,把模型权重拆开:显存放常驻计算部分和热点 experts,内存放路由 experts,SSD 上放 n-gram embedding 表,通过系统页缓存提前读取所需行。缓存命中的 experts 直接由 GPU 计算,未命中的则由 CPU 和 GPU 分担,并且尽可能让计算和数据搬运同时进行。为了让 CPU 算的更快,Strata 甚至还专门针对 Q2_0 量化写了 AVX-512 VNNI 内核。因为只需要把权重的很少一部分放在显存里,其余放在内存和 SSD,所以 Strata 甚至不需要 RTX 3090 这样 24G 的卡,作者自己用 12G 的 RTX 5070 跑 IQ3_XXS 的 Qwen3.8-Flash-Next 也能有 65.6 tok/s。

8. 这已经是我组装的第6台电脑了,现在内存涨价,只能用“E5邪修”配DDR3服务器内存条,要不然如果是DDR4,两根16G就要一千块,DDR5单根16G就要一千块,而采用洋垃圾E5处理器,则可以搭配两根16G合计32G的DDR3服务器内存条,且价格仅需200块(虽然涨价之前是35块一根,但因基数小涨幅可以接受),这台电脑合计成本大约1700左右,我收别人2500,会不会太黑了

9. 2026内存条选购指南 11月版 小白可看[DDR4 DDR5颗粒性能天梯图 高频率低时序大容量 双通道RAM电脑DIY硬件组装]光威/金百达/金士顿/宏碁

0
扫一下,分享更方便,购买更轻松
0评论

当前文章无评论,是时候发表评论了
提示信息

取消
确认
评论举报

最新文章 热门文章