














26
36
个性化配音怎么制作?AI声音定制与专属音色设计方法
2026-11-17 18:05:22
0点赞
0收藏
0评论
翻了半个多小时音色库,我关掉了页面。
不是没有好声音,是那些“热门推荐”里,我已经在至少五个同行的视频里听过了。做知识科普,内容本来就不容易做出差异,声音再撞车,观众划走的时候连印象都留不下。
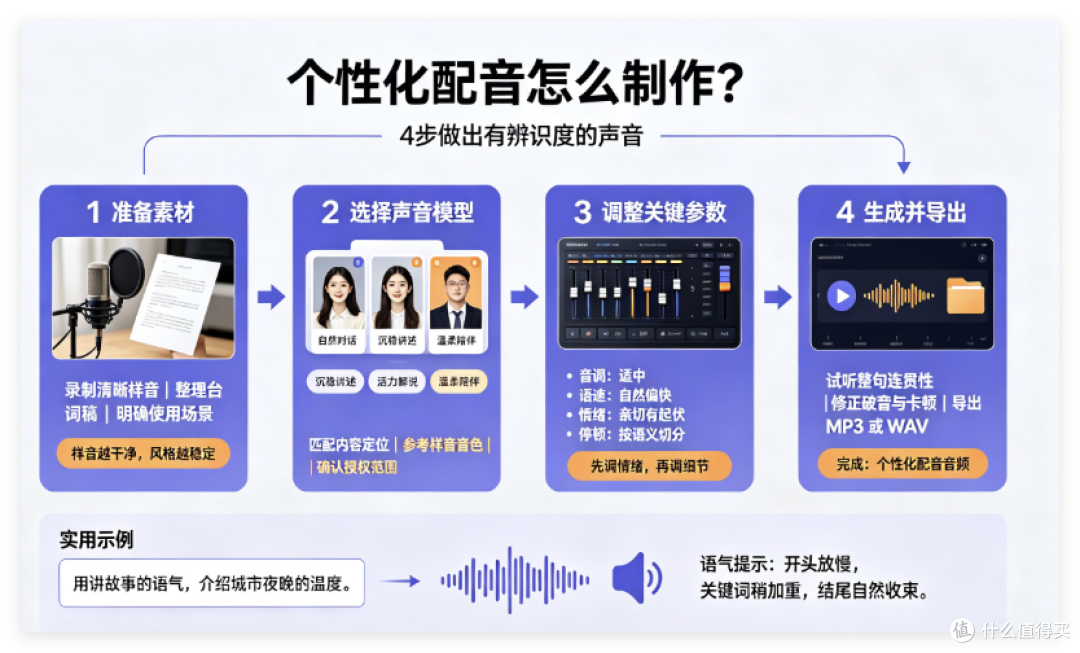
那次之后我开始琢磨声音定制这件事。试下来发现,它没有宣传得那么万能,但也确实解决了我的问题。这篇把三种方式和我踩过的坑说清楚。
如果你只是偶尔发几条视频,工具里现成的音色够用。
真正需要折腾声音的,是这两类人:一是账号要做长期,声音得成为识别符号;二是内容类型固定,比如专做历史讲解或者情感故事,需要一个从头到尾稳得住的声线。
其他人,先调参数就行。
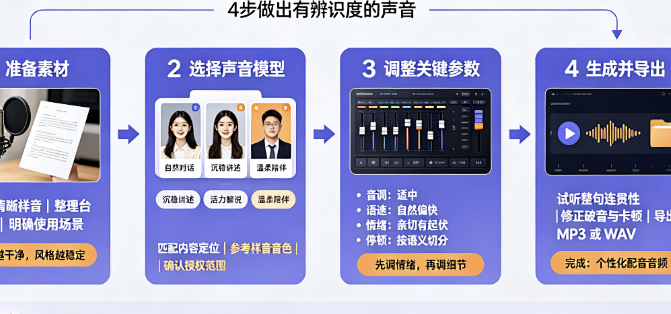
选音色的思路很简单:先按内容定方向,再用参数补细节。
调参这块有个细节:不同音色对同一组参数的响应不一样。给 A 音色调的 1.1 倍速,换到 B 可能就是赶。所以每换一个音色,都得重新试一段。
这套逻辑适用的内容类型挺广——个人 IP、影视解说、知识课程、企业宣传、有声故事,路径都一样:先定方向,再补细节。
想让声音不一样,可以“捏”一个
这是我最后选的路。
所谓捏声音,就是用文字描述你想要的声音,让 AI 生成。不用提供素材,也不用在音色库里翻。
听起来简单,但描述写不好,出来的东西会很怪。
我第一次写的是“好听的女声,有磁性,适合讲故事”——生成的结果甜得发腻,完全不是我要的。后来才明白,“好听”“高级”“有磁性”这些词对 AI 没有意义,它需要的是可执行的参数。
有效的描述大概包含五块:
性别和年龄感。 成年男性、年轻女性、中年,先定这个。
音调和音质。 低沉、清亮、柔和、浑厚,选一两个,别贪多。
表达方式。 聊天式还是播报式?温柔叙述还是有力量感?
语速和节奏。 知识讲解要稳,剧情解说要有起伏,情感内容要留白。
使用场景。 这条最重要——声音是给影视解说用的,还是给课程用的,出来的结果差很远。
想用自己的声音,先把授权想清楚
另一条路是声音克隆:提供自己的声音素材,生成一个能念任意文字的模型。
适合谁?主要是那些本来就有稳定声音形象的人。比如做课程的老师,每节课都要录,一次录两小时,改一版重录一遍。有了模型,改稿只需要改文字。
但这件事有个前提,必须说清楚:只能用本人的声音,或者已经拿到明确授权的声音。平台在这方面卡得很严,也只能这样。拿别人的声音做模型,不管出于什么目的,法律上都站不住。
如果只是想换个风格,不是要复现自己,那就别走这条路,用捏声音更快。
三种方式怎么选
按成本从低到高排:
现成音色 + 调参——最快,零成本,适合大部分人。缺点是可能撞声。
捏声音——不用素材,几分钟能出一个,适合想要独特声线但没录音条件的人。缺点是需要试几轮,描述写不好会跑偏。
声音克隆——克隆自己的声音,没有任何版权
顺序别搞反。我见过有人一上来就做克隆,做完发现自己的录音环境不行,素材质量拖累了模型,白折腾。
几个我踩过的坑
别为了特别而特别。 我试过一个很有辨识度的沙哑男声,单听很抓人,放进知识科普里像在念悬疑小说。声音得服务内容,不是反过来。
别只听几个字。 工具里的示例音都念短句,听不出问题。拿你自己的稿子试,重点听长句、数字、专有名词。数字读法是最容易翻车的地方。
风格定了就别老换。 我前两个月换过三次声音,结果老观众根本不记得我是谁。声音和封面、片头一样,属于识别系统,定了就得稳一段时间。
文案不行,声音救不回来。 这个最容易被忽略。句子太长、标点乱、一段里塞五个人名,再好的音色念出来也是一团。生成之前先读一遍,读着别扭的地方,机器念出来也别扭。
声音定制这件事,本质上是把“配音”从一次性动作变成账号资产。
但要提醒一句:它不是必需品。内容不行的时候,换什么声音都没用。先把选题和结构跑通,再考虑声音要不要做差异化。
真想试,可以从捏声音开始——成本最低,试错最快。媒小三配音里就有这个功能,先用一段真实文案试,别用示例句。