

11月12日,豆包工作面向普通用户开放了多款第三方模型的自选。更关键的变化在价格侧:模型选择页面上,每款模型旁边挂出了一个「额度消耗倍率」,以前用哪个模型便宜大概要凭感觉,现在可以直接比。选模型不浪费额度,关键是把倍率机制、任务匹配和优惠规则这三层都看懂。知乎·技术领导力知乎·极客公园知乎·fish
倍率把「计价口径」摆上了台面
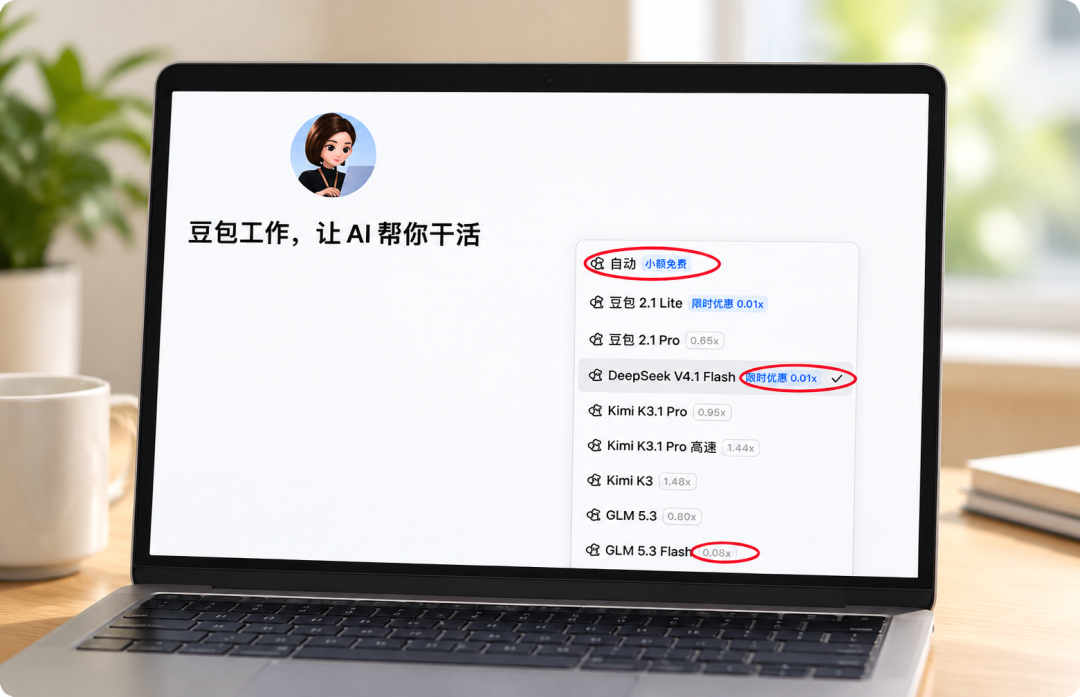
官方口径是倍率越低,完成同类任务消耗额度越少,倍率本身不改变任务复杂度、但决定额度消耗速度,另有「自动」一档标注小额免费、不计入倍率档位。把列表数字排开看更直观:豆包2.1 Pro 0.65×、DeepSeek V4 Pro 0.46×、GLM 5.3 0.80×、Kimi K3.1 Pro 0.95×、Kimi K3 1.48×,而豆包2.1 Lite与DeepSeek V4.1 Flash限时优惠降到0.01×——最高与最低正好相差148倍。也就是说,同样一份活,选错档位确实可能贵出上百倍,选对档位则几乎贴着免费线。知乎·AI探索家
低倍率用来跑日常,高倍率留给不能返工的活
0.01×、0.08×这档模型是日常高频任务的「节省流」。一期第三方横评实测了同一个群聊信息图任务:WorkBuddy消耗8.49积分,豆包工作则直接免费。高倍率模型要留给不能返工的活:Kimi 3.1 Pro主打百万字级超长上下文,GLM 5.3侧重中文语言理解与生成,DeepSeek V4.1 Flash以高响应速度和高性价比定位轻量日常任务。豆包2.1 Pro则由平台深度优化、适合复杂长程任务,一项「调研加分析再出PPT」的实测跑了30多分钟。一位标准套餐用户提醒得很直接:用Kimi K3问了四个问题,这周额度花掉一半。高倍率模型有它的位置,但它不是随手问问题的默认选项。知乎·沃垠AI知乎·极客公园知乎·技术领导力小红书
真正的浪费不是「贵」,是「返工」
额度消耗等于单价乘以次数,最容易被忽略的恰是次数:便宜模型没一次做对、换强模型重来,实际成本是两轮相加。社区里流传的「日常用DeepSeek、高难任务再切Kimi」分工,其实是同一笔账的两面——先把返工率降下来,再谈省。另一个争议值得留意:有用户声称平台托管的第三方模型上下文相比官方版本缩水,这些说法未获官方确认;在把某款模型固定用于关键任务之前,最好先用它跑一遍、验一次交付效果再定。
规则层,一条都别让闲置
这次的优惠有两类:工作日及节假日指定时段内使用参与活动的模型,额度消耗可再打折,细节以App内活动页为准。另一类是豆包2.1 Lite与DeepSeek V4.1 Flash的限时倍率下调,同等任务消耗额度更少。额度规则本身也在变:11月6日起,豆包工作个人版取消5小时额度限制,只剩按套餐计的周额度。新用户(限纯新用户)可免费领30天体验套餐,老用户每日签到领额度、攒着集中处理任务。标准套餐连续包月68元/月、含9000额度,在上述横评的多个任务中豆包工作侧消耗总体占优。知乎·技术领导力知乎·极客公园小红书知乎·多多说钱知乎·沃垠AI
结语:把账算在任务上,而不是算在模型上
豆包工作这轮开放不是单纯上新:上线三个月后,官方披露其日活跃用户突破800万、企业客户ARR突破20亿元,多模型加透明倍率正是它给「用得划算」的答案。回到标题的问题——怎么看额度消耗才不浪费:先看倍率定单价,再看任务定档位,最后用交付效果验证次数。额度不是省着用出来的,是把每一份额度都花在能把活干成的模型上。微博
当前文章无评论,是时候发表评论了