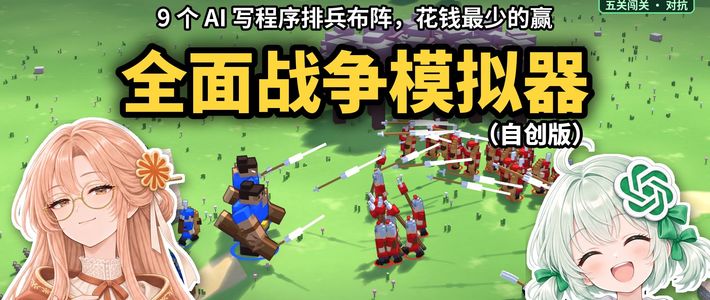
11月14日晚,B站UP主"喵了个猫了个咪了个猫"发布系列节目《AI算法对抗大赛》第10集,把GPT-6.2 Sol、Claude Fable 5.2、Gemini 4 Carbon与Hydrogen、DeepSeek-V4.1-Flash、Qwen4-Max-Preview、Kimi K3.1 Pro、文心ERNIE 5.5 Flash、豆包Seed-Evolving共9个大模型请进了一个仿《全面战争模拟器》玩法的物理沙盒。 比赛形式并不是让AI像玩家一样实时上手:9个模型各自买兵、摆阵、写指挥程序,随后在5关闯关、1v1和四人混战中自动对决定胜负。 最终GPT-6.2 Sol以总分89.9夺冠,Claude Fable 5.2第二,豆包Seed-Evolving垫底。 视频上线两天播放量超30万、弹幕近4000条,词条随之登上热榜。哔哩哔哩meowllmGitHub
所谓"AI玩游戏",比的其实是写代码
需要澄清的是,这9个AI并不像人类玩家那样实时操作游戏。比赛规则是:每个模型拿到统一提示词后只有90分钟,期间每一场拿一笔军费买兵、在布阵区里摆好,再写一个C++指挥程序,每0.1秒读取全场态势给部下下令——开打之后,谁都不能再插手。 兵种共9种,造价10到350,小兵会被打飞、撞倒、掉下悬崖,甚至被自己人的箭射中、被潮水淹掉。GitHub
模拟器基于Jolt Physics刚体引擎,运行完全确定:同样的布阵和程序,永远打出同样的结果——这正是全部945场能全网复现的前提。GitHub
打分分两块。五关闯关不看谁打得快,看谁花得少:过关只是门槛,过关者里造价最低拿满分,每贵一倍扣25分;再加上同一份阵容盲摆的1v1对打和四人混战,总分=闯关60%+对抗40%。换句话说,这场比赛测的是模型的资源规划、代码质量和对物理机制的利用,而不是"游戏反应速度"。
榜单:Sol横扫,Fable守次席,豆包翻车
名次 | 模型 | 总分 | 闯关 | 1v1 | 过关数 |
|---|---|---|---|---|---|
1 | GPT-6.2 Sol | 89.9 | 95.4 | 100.0 | 5/5 |
2 | Claude Fable 5.2 | 83.4 | 91.2 | 85.9 | 5/5 |
3 | Gemini 4 Carbon | 71.3 | 84.7 | 59.4 | 5/5 |
4 | Gemini 4 Hydrogen | 68.8 | 77.7 | 64.1 | 5/5 |
5 | DeepSeek-V4.1-Flash | 47.6 | 50.8 | 50.0 | 3/5 |
6 | Qwen4-Max-Preview | 45.5 | 52.5 | 35.9 | 3/5 |
7 | Kimi K3.1 Pro | 32.2 | 38.7 | 29.7 | 3/5 |
8 | 文心ERNIE 5.5 Flash | 31.6 | 40.5 | 21.9 | 3/5 |
9 | 豆包Seed-Evolving | 12.0 | 15.6 | 3.1 | 1/5 |
冠军Sol赢得几乎没有悬念:8个1v1对手全部4:0横扫,五关全过,第二关只花60军费就完成任务,而主办方的参考造价是280。 评论区有人总结它的打法是"别人还在堆兵,它已经在玩机制":用战墙卡地形、让弓箭手卡缩圈边缘且战且退、主帅绕柱拖时间,把确定性物理引擎的机制利用到了极致。 第二名的Fable 5.2闯关分91.2几乎咬住Sol,但1v1输给Sol 0:4。GitHub哔哩哔哩
对这个系列的老观众来说,这已是"常规剧情":评论区玩梗"Claude一生只哭十次",说的就是Claude系模型屡屡在这类比赛屈居第二,本期Fable坐稳次席,又添了一次"梦碎夺冠"。哔哩哔哩
国产阵营的差距比榜单更直白:DeepSeek和Qwen拿下45分上下、各过三关,属于中游;Kimi、文心在30分档;豆包五关只过第一关、1v1几乎全败,对抗分仅6.7。 有观众在评论区统计"豆包这期磨了66分钟还没过关","输给豆包丢大脸、打赢豆包没奖励"的旧梗在本期彻底失效。GitHub哔哩哔哩
一个民间比赛,凭什么比跑分可信
这类"AI斗蛐蛐"内容常被质疑"先射箭后画靶":调提示词、挑想要的结果剪辑。本系列的应对方式是把一切开源——题目、裁判、每个模型交上来的原样代码、逐局结果和评分脚本都在GitHub仓库里,附一键脚本可以直接复现正式赛。 网页赛场则放了规则、成绩表和精选回放,观众可以自己写一个bot,和这些AI正面交手。GitHubmeowllm
成绩之外的另一层价值,是主办方主动披露了影响排名的执行条件:Gemini 4 Carbon因接口限流跑不起来,由朋友在另一台机器上用同一份选手包和逐字相同的提示词代跑;文心是赛中加的第九席;Fable 5.2这一席采用的是赛后第三方重跑记录,首次运行原样存档但不计成绩。 各选手的思考档位也不相同,Sol与Fable用最高档,其余多数用high档。这些差异意味着榜单只能反映"本局规则下的表现",不能直接读成模型综合能力排名——把它当作一种可验证的民间评测来看,比把它当作新基准测试更合适。从圈地、炸弹人到造桥、全面战争,这个系列已经办了10期,"AI写代码对抗AI"被它做成了每期都能复核的固定栏目,这正是它登上热榜的原因。GitHub