失败任务占17%,却烧掉32%账单:微软给编程Agent开了外挂
如果你天天用 Claude Code、Codex 这类编程 Agent,大概率有过一个灵魂拷问:这玩意儿烧的钱,有多少真花在干活上?
微软研究院最近正面给出了数据:同一个项目做过 5 次以上后,Agent 仍有约 30% 的工具调用在重复“摸环境”;而失败任务只占全部任务的 17%,却烧掉了 32% 的账单。烧钱的不是干完的活,是 Agent“不记得上次怎么来的”。微博
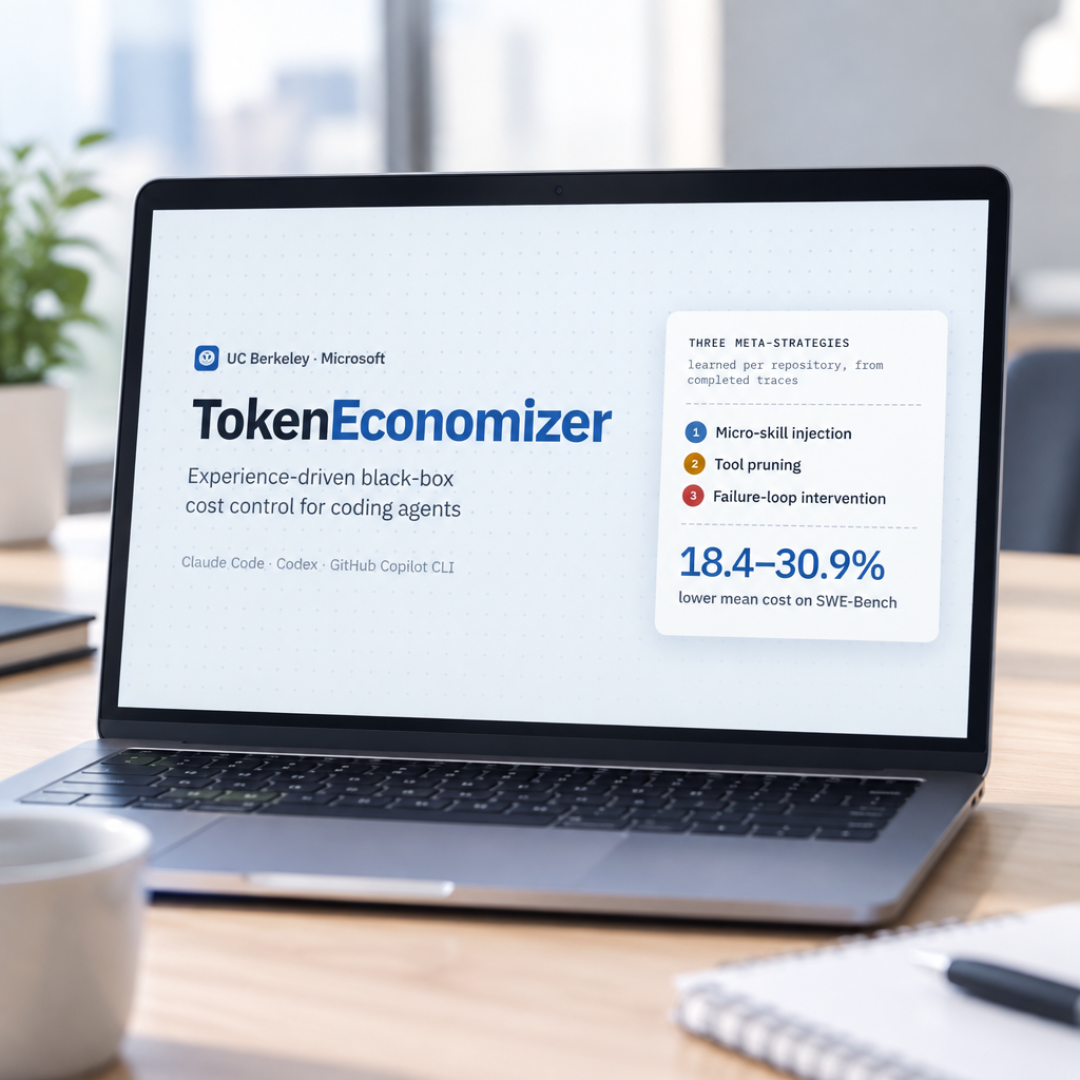
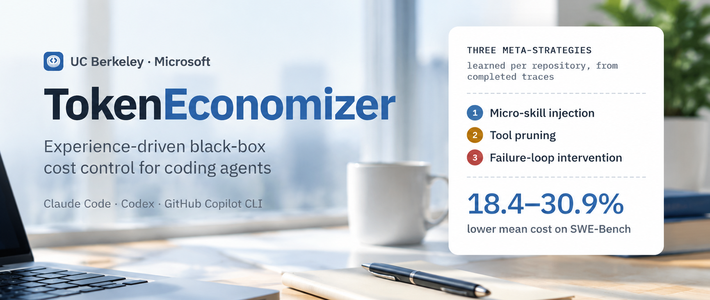
11 月 16 日,微软研究院介绍了开源插件 TokenEconomizer,想让编码智能体从仓库的历史会话中学习,减少后续任务的重复消耗。知乎
这款外挂由微软和伯克利联手开源,核心卖点是克制:不改底层模型、不侵入 Agent。挂到 Claude Code、Codex、Copilot CLI 现有流程上就能用,opencode、Cursor Agent 属实验性支持,作者名单里还有 Ion Stoica 和高剑锋。微博微博
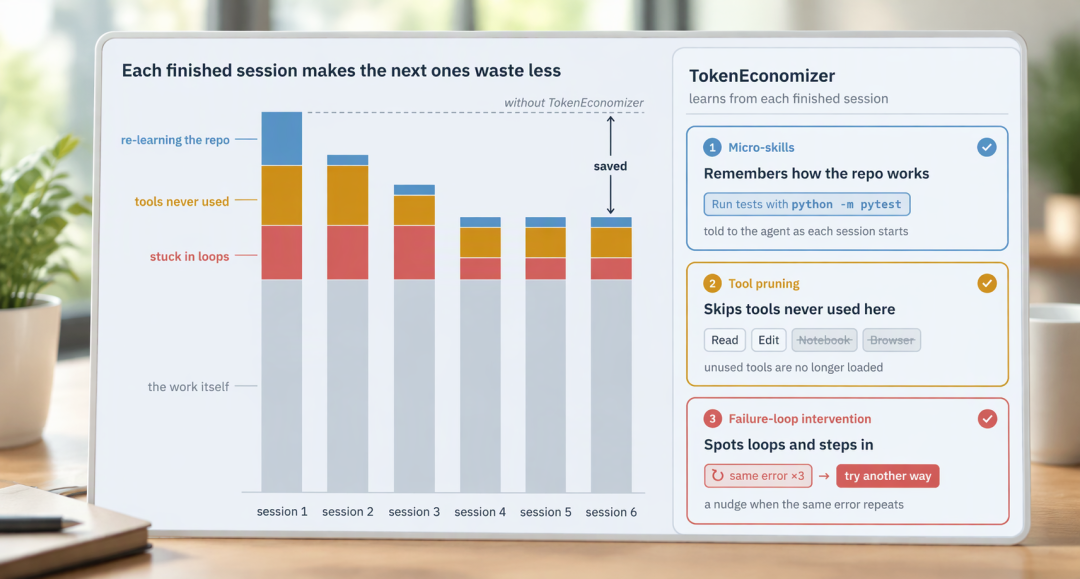
它干活主要靠三招:
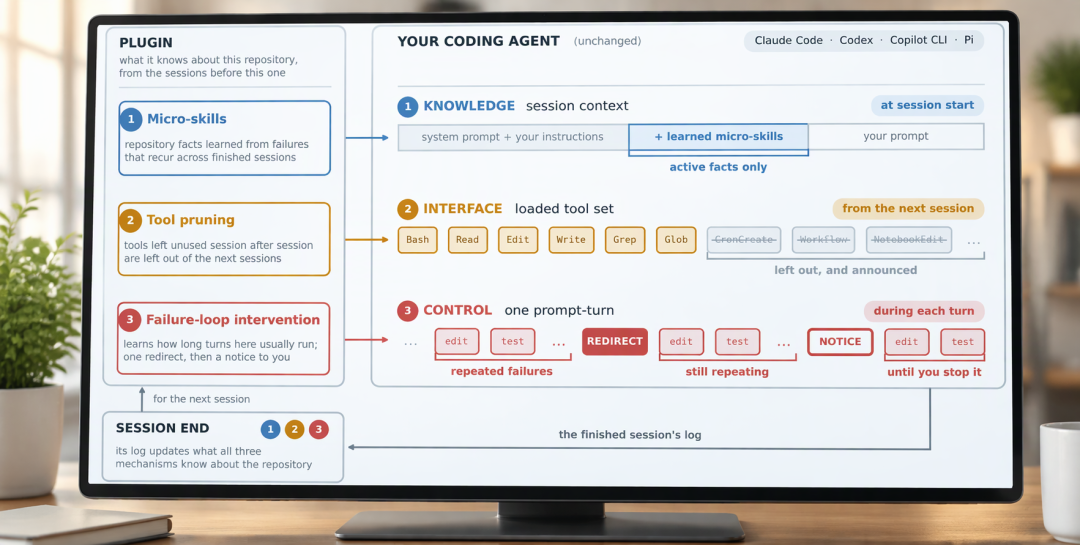
第一招,微技能。仓库知识被 3 个会话反复确认后,固化成一条简短的“微技能”,后续任务直接查表,不再重新探索;如果后来的证据把它推翻,再删掉。相当于给项目立了块小白板:此路已探明。知乎微博
第二招,精简工具描述。长期用不上的工具描述被暂时压缩,命令、文件编辑等核心工具完整保留,需要时再恢复。删的是上下文,不是能力。知乎
第三招,拦截失败循环。一个判断模型盯着 Agent 是不是在原地打转:卡住了,提示它换思路;提醒后还卡,插件就喊开发者来处理。不需要模型变强,需要的是有个裁判。知乎
研究团队在六个仓库的 277 个 SWE-Bench 修复任务、五种智能体×模型组合中做了测试,报告平均任务成本降低 18.4%–30.9%,成功率整体大致稳定。知乎微博
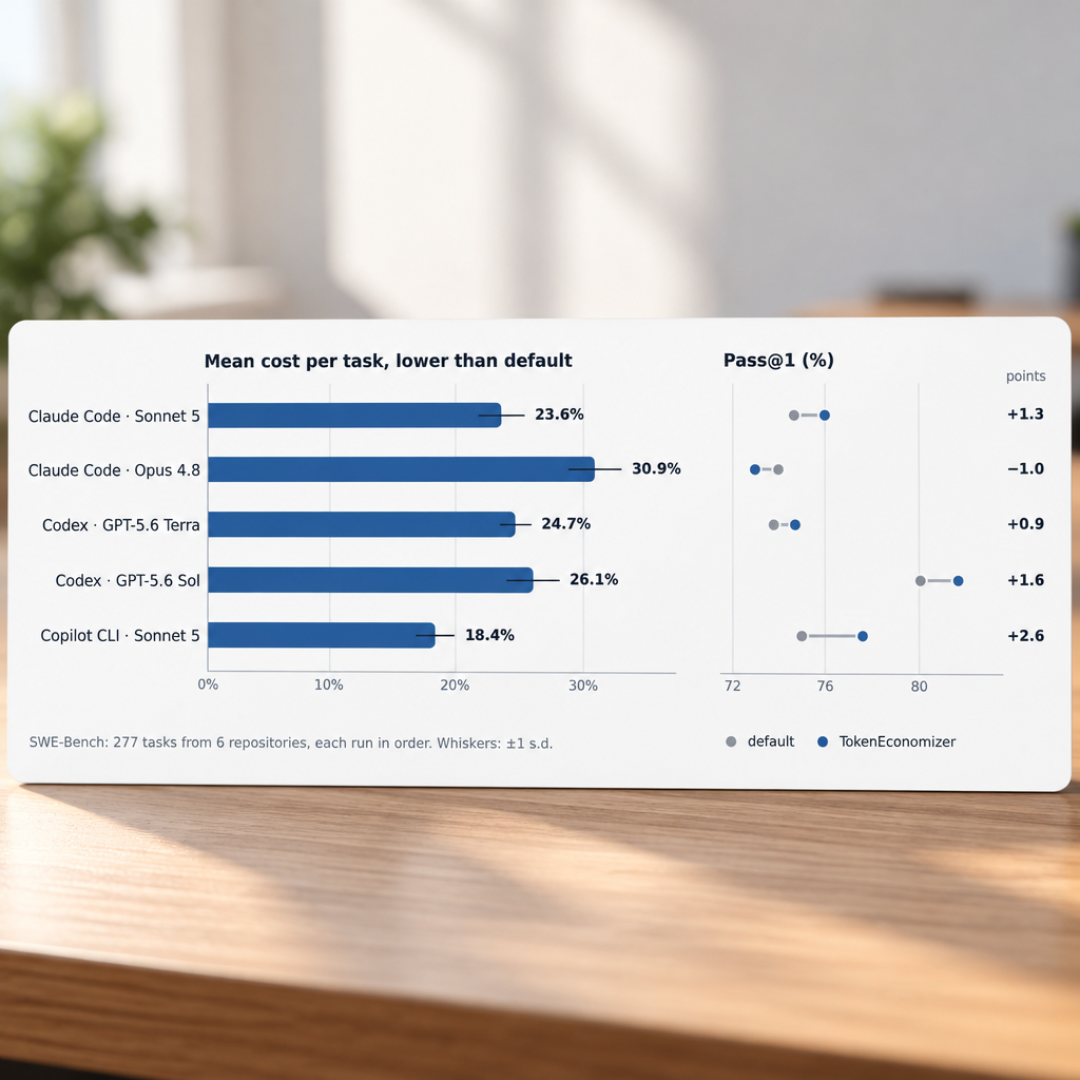
但两盆冷水也得泼:这个数字已包含插件自身的模型调用开销,且只代表该研究的测试条件;新项目初期积累经验时,任务可能反而更贵。知乎
所以就算暂时不装插件,这份研究也给了现成的抄作业姿势:把项目里真实可用的构建方式、测试命令、常见约束写成文档,记下哪些错误反复出现;更要定期核验这些记录——错误、过期的经验,同样会误导 AI。知乎
打算试用的话,建议先弄清它支持的环境、怎么处理会话日志,再挑自己项目里的代表性任务对比成本和任务成功率;但请记住,省 Token 不是跳过必要测试的理由。知乎
最贵的代码,从来不是 AI 写出来的,是它走第二遍的老路。