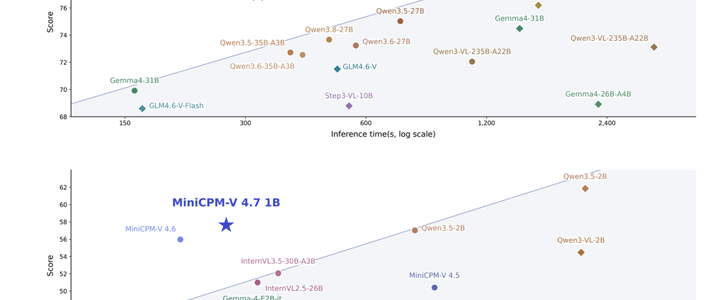
这几年手机本地AI的天花板,一直是"几个亿参数的小玩具"。10月13日面壁智能联合OpenBMB发布了MiniCPM-V 4.7,一个350亿参数的多模态模型,按Apache 2.0彻底开源,直接塞进手机跑,官方给的名头是全球首个能在端侧无损流畅运行的开源MoE多模态大模型。魔乐社区知乎
35B是账面数字,每次真正干活的只有3B
秘密在MoE(混合专家)架构。模型内部有一大堆"专家"子模块,每生成一个字只激活约3B参数,剩下的专家平时躺在手机闪存里,用到才读进内存。所以35B模型运行时内存占用只要约3GB——旗舰机标称16GB,扣掉系统和后台,真正能给App用的本来就不多,这个设计等于绕开了内存这条死路。魔乐社区
但闪存读写会带来等待。团队搞了个"前瞻专家调度(LES)":算当前层的时候,提前预测下一层要用哪些专家,后台先把它们读进来,把闪存读取的时间藏进计算时间里。官方数据:多数场景能提前备好超过80%的专家,整体提速约5倍,而且预测不改变最终路由,输出和不开提速时逐字一致。知乎
实测速度:单轮问答真的够用了
iPad Pro M4(16GB):生成17+ token/秒
iPhone 17 Pro Max:13+ token/秒,仅占约3GB内存
安卓端官方演示覆盖骁龙8 Gen3/4/5,8 Gen 4上约17 token/秒,输入处理约100 token/秒
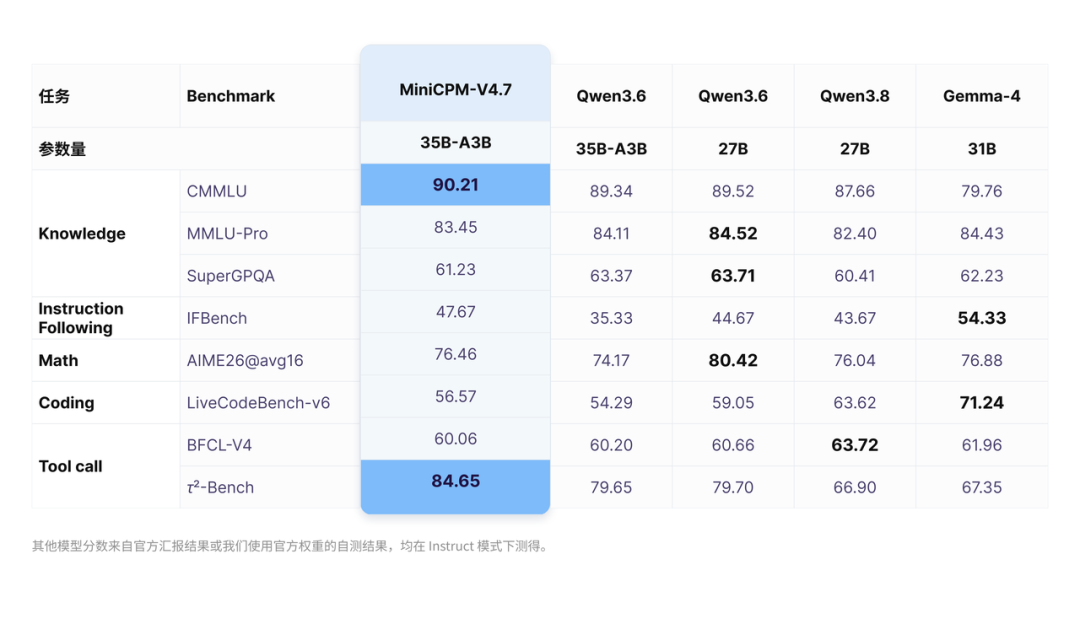
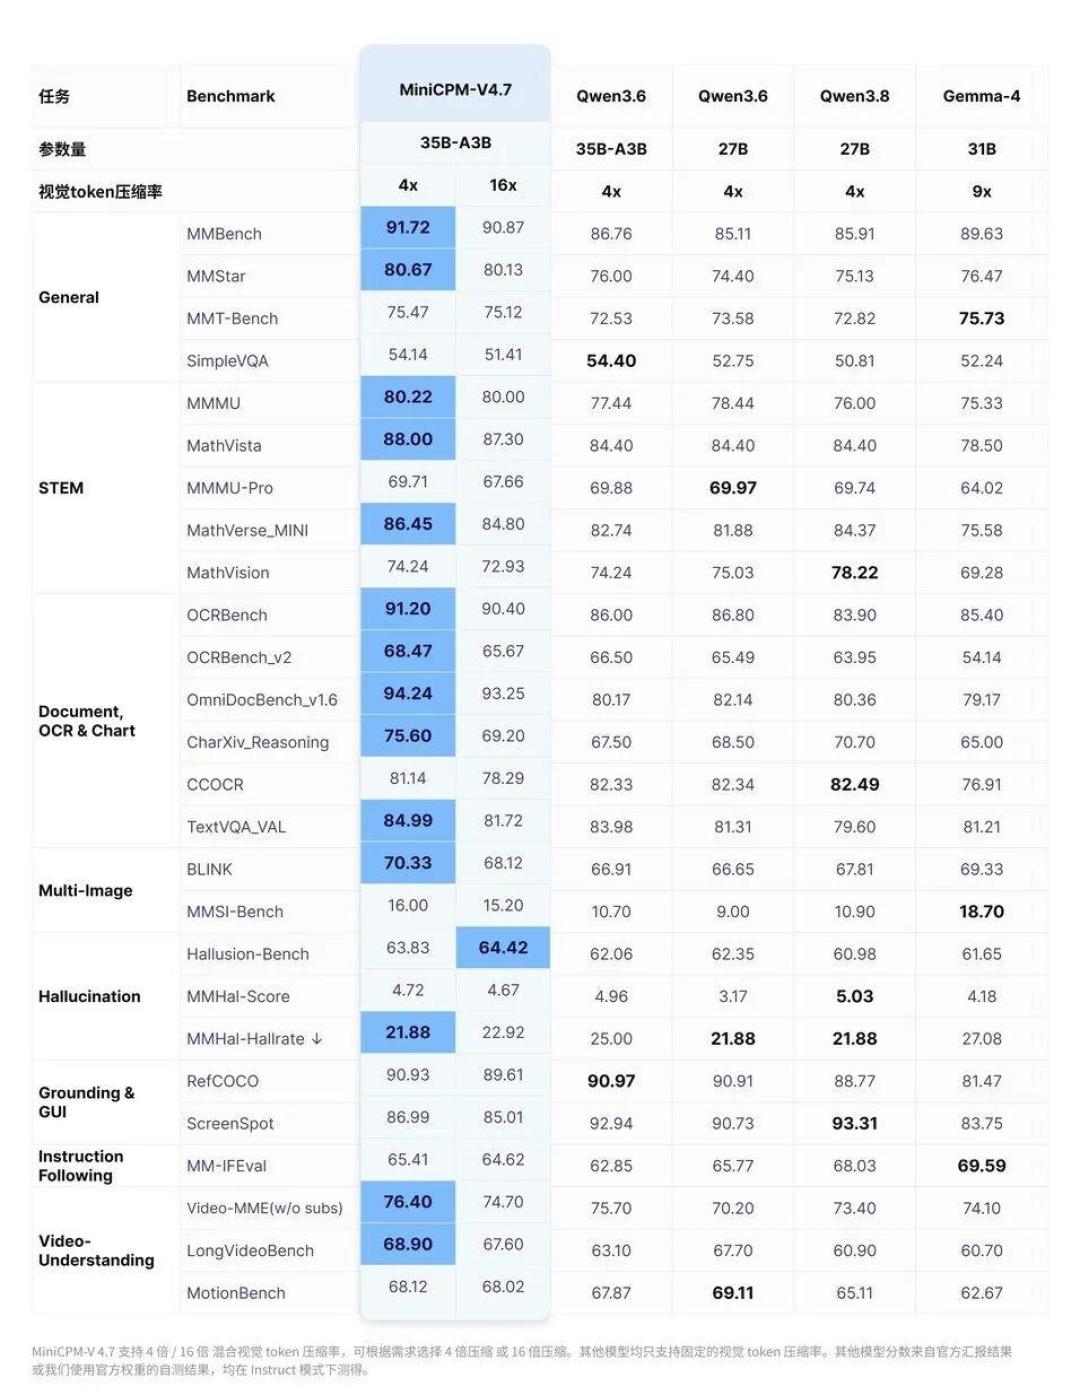
MMBench 91.72、OCRBench 91.2,官方称34项测评全面领先同档的Qwen3.6-35B-A3B,部分科目反超体量更大的Qwen 27B和Gemma-4 31B。看图、读文档、OCR、做题、看视频都在能力范围内——注意,它是"看懂"模型,不是生图模型,指望它出画的可以散了。魔乐社区
先别急着欢呼,评论区已经替你把坑踩了
第一,存储是真吃。完整权重约65.6GiB,128GB的手机装上就少一半空间,下载一次还得看路由器脸色。第二,稳定性和发热是现状不是历史。试用用户反馈锁屏会中断生成、部分机型长时间输出会闪退;有人用手机端开源方案跑35B加本地生图,实测机身43℃,全程离线约3字/秒——能用,和好用之间还有距离。第三,断网可用、数据不出手机才是它的杀手锏,比拼速度它短期打不过云端。魔乐社区哔哩哔哩
对普通人意味着什么
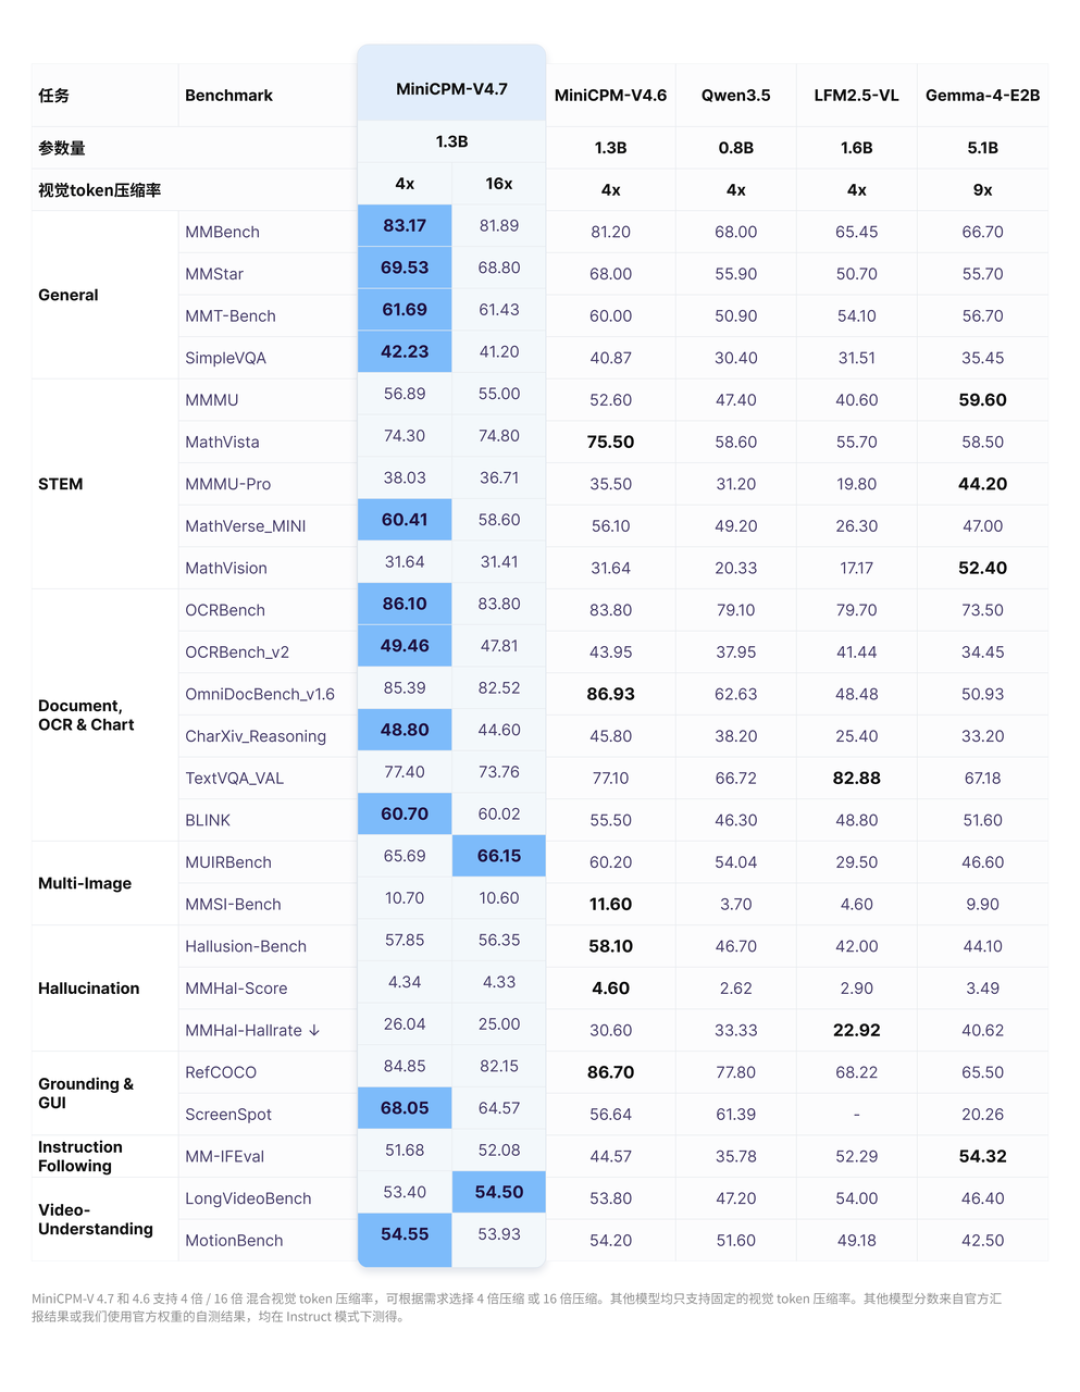
先别为新AI功能换手机。名单里最老的骁龙8 Gen3是2023年底的芯片,你的两年旧旗舰大概率就是入场券;想尝鲜,把抽屉里的旧手机捡出来装个端侧App,当个不联网、不上传的看图识字助手更实际。入门机用户等1B版生态铺开就行,官方明确它就是给广泛移动终端准备的,瑞芯微、苹果、高通、NVIDIA这些平台都已Day 0适配。小红书知乎
端侧AI从"演示"跨到"能日用",这次信号确实到了。但记住顺序:先清存储,再谈信仰。