搞GPU并行计算的,都懂一条不成文规矩:选了PyTorch,就等于选了英伟达。十年里AMD来过、英特尔来过、谁家发布新卡都喊一遍"挑战CUDA护城河",评论区永远是那句祖传回应:护城河哪有那么好拆的。
10月下旬,谷歌不喊口号,直接改规则:在PyTorch Conference 2026上,TorchTPU整套软件栈开源,让PyTorch原生运行在TPU上。以前用TPU得套一层PyTorch/XLA"转接头",侵入式改源码、编译慢到怀疑人生;现在,.to(“cuda”)改成.to(“tpu”),一行代码,换一颗芯片。机器之心知乎
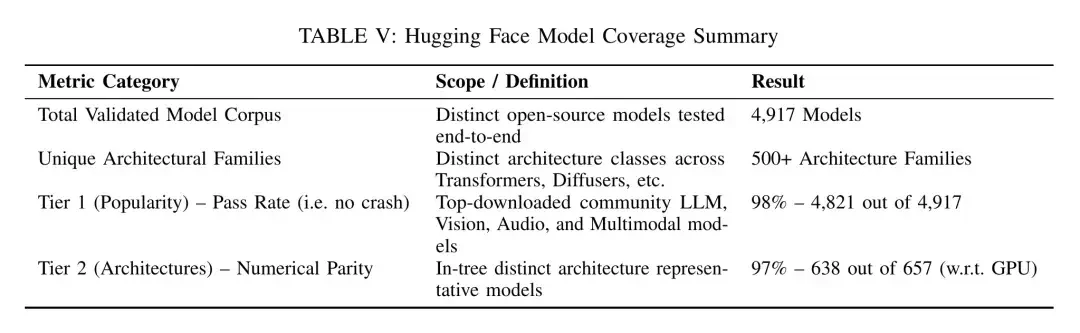
谷歌交出的成绩单挺猛:持续实测Hugging Face下载量最高的约5000个模型,4917个里98%能跑通不崩溃;657个代表性架构中97%的输出与GPU数值一致。规模上,Qwen3 235B MoE在64颗TPU v7上跑到谷歌自家JAX方案约94%的吞吐;从1024颗扩到8192颗一整排Pod,每颗芯片的吞吐只掉6%。推理端更有杀伤力:据SemiAnalysis基准,8K输入/1K输出场景下每百万token成本2.01美分,比9月首测时便宜约四成;另一份已公开的推理基准里,16颗TPU v7跑Kimi K3,单用户生成速度每秒709个token,比同配置的GB200快了57%。vLLM、SGLang、Hugging Face、Ray、TorchTitan同步完成接入,连谷歌自己的技术报告都罕见点名旧方案"本质上都是让PyTorch迁就JAX"。36氪机器之心量子位
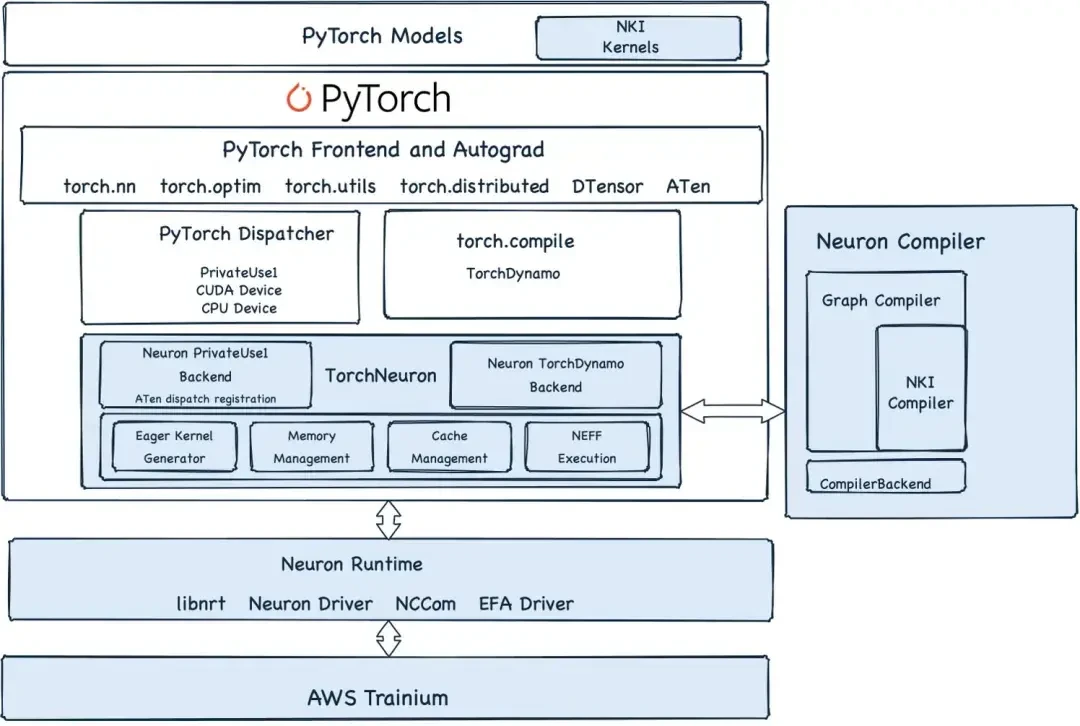
这也不是谷歌一家在动手。同一场大会上,AWS端出开源的TorchNeuron,让Trainium芯片以较小的代码修改成本直跑PyTorch。背景是硬件早就卖动了:Anthropic签下最多100万颗TPU的使用协议,Meta也被曝数十亿美元租用合约。芯片卖得出去,软件是最后一块短板,现在谷歌亲手把它补上了。知乎机器之心
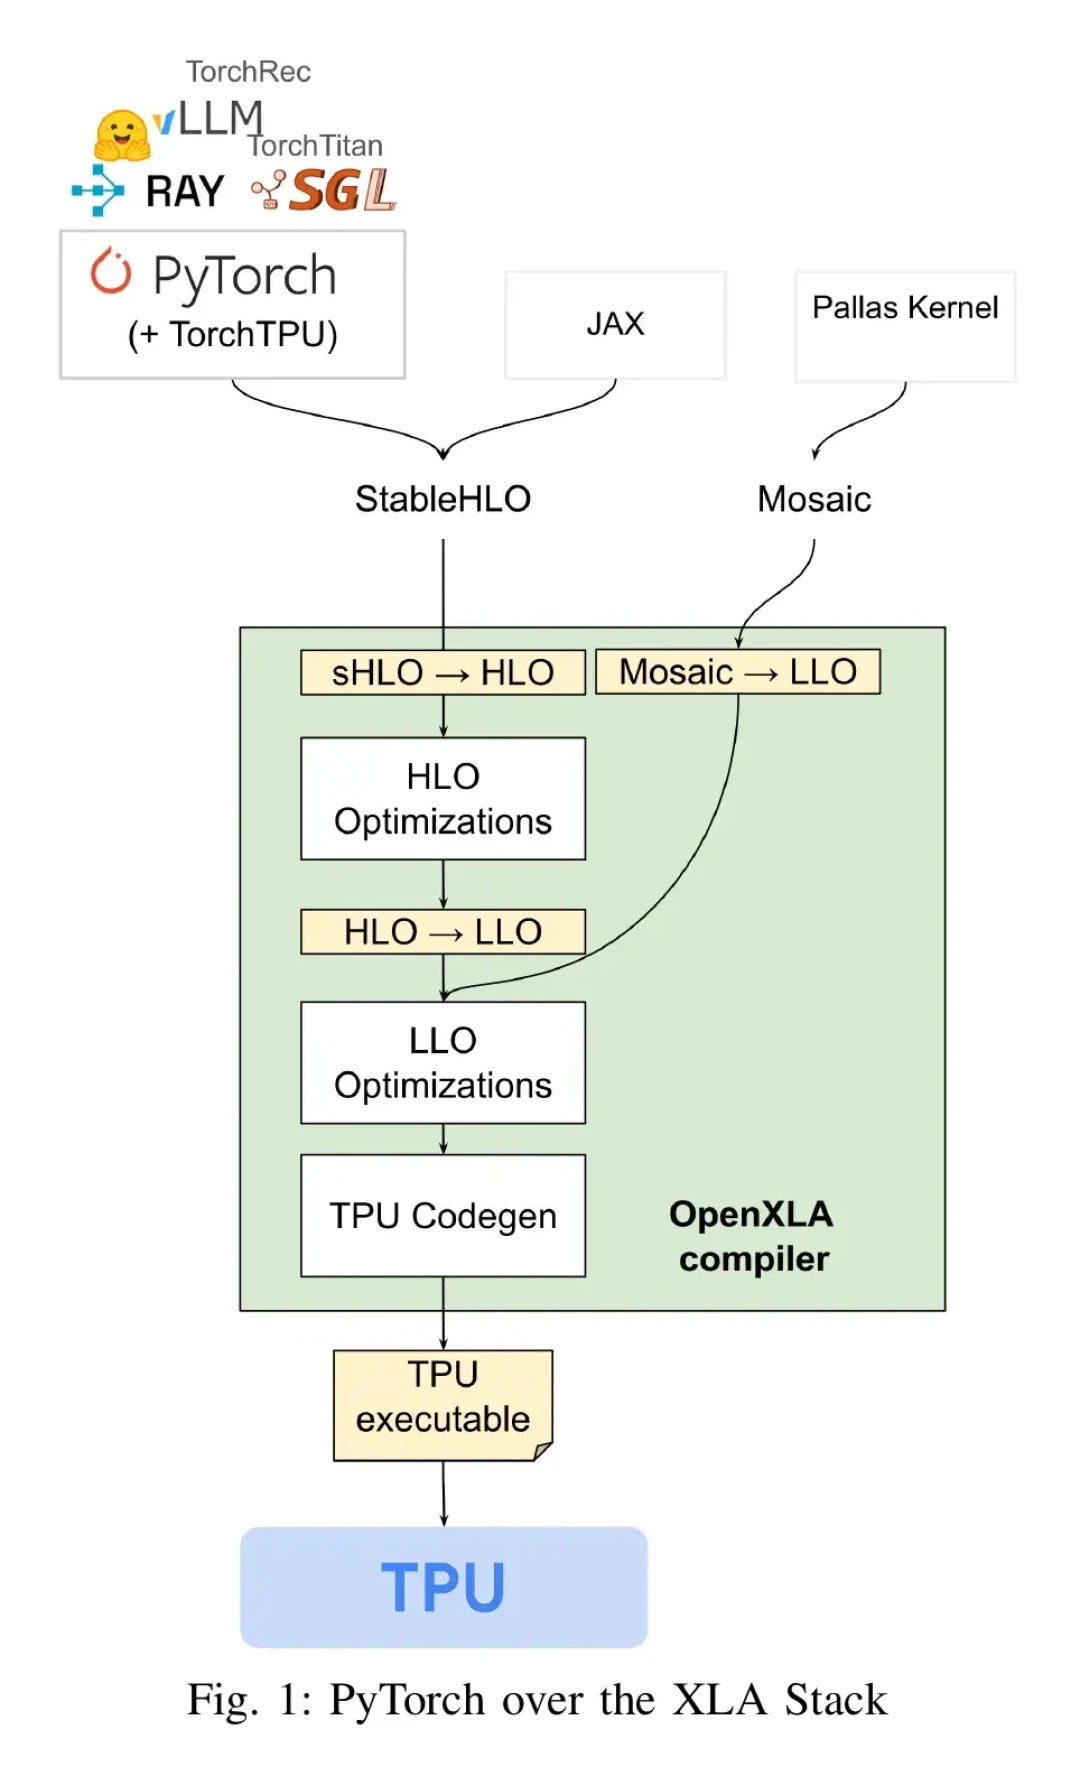
但先别急着喊"护城河填平",三根刺得钉回去:98%跑通≠98%跑得快,改一行代码只保证能跑,峰值性能照得手动调;多数性能数据出自谷歌自测,社区独立验证还没跟上;最倔的细节是,PyTorch默认编译器Inductor深度依赖Triton,而Triton难移植到TPU——墙只在生态层退了一步,编译器那一层还是英伟达的家。至于"OpenAI也要买TPU"的传闻,OpenAI已否认大规模采用,目前仅在早期评估阶段对谷歌TPU进行测试。知乎
对普通爱好者,这事的价值其实很实在:你学的CUDA不会贬值,但垄断定价第一次有了备选项。显卡市场本来就热,"每美元换多少token"这把火烧起来,等着本地部署降本、等着"Token自由"的人,这次是真能看到点指望了。









校验提示文案
校验提示文案