这周,微软往《科学》杂志上交了一份"考卷",把全网看热闹的都惊着了。微博
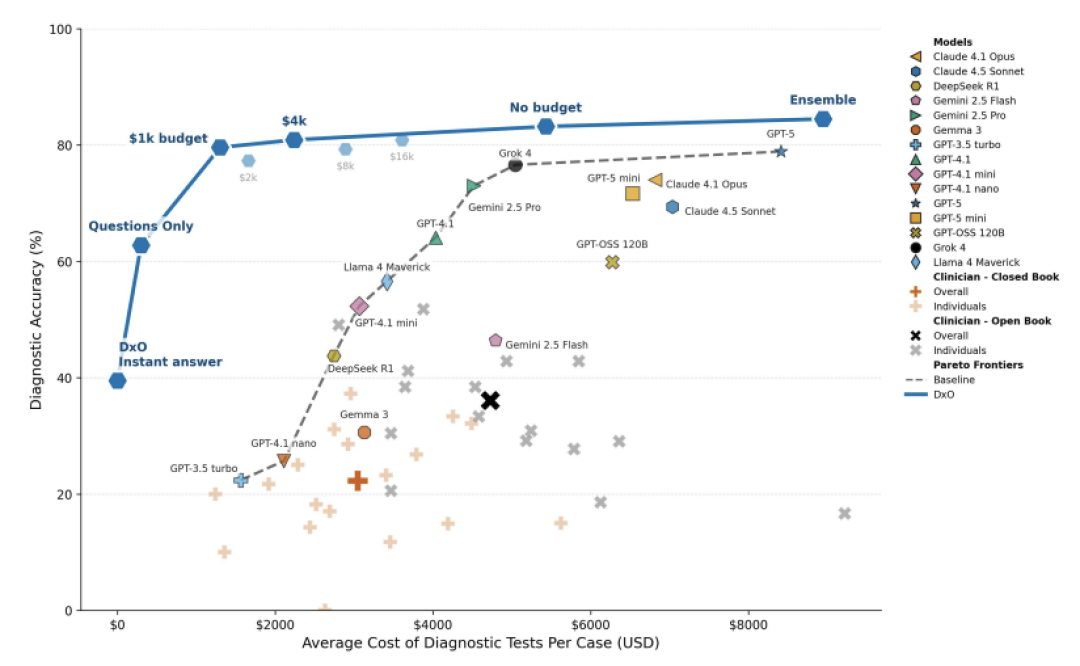
考题是304个来自《新英格兰医学杂志》的疑难病例。微软那套叫MAI-DxO的AI系统,诊断准确率83.2%;同场的全科医生,开卷考36.1%,闭卷只剩22.3%。差了一倍还多。知乎知乎
这个AI,不是一个脑子在看病
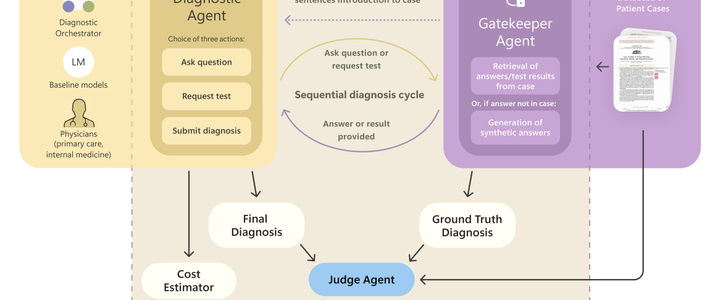
MAI-DxO最有意思的地方,是它不是一个模型,而是一个"会诊小组"。微博
小组里好几个智能体各司其职:有的负责提诊断假设,有的决定开哪项检查,有的专门挑毛病,还有个管预算的,盯着别乱开检查。外加一个"看门人",你问到才给信息,防止考场漏题;一个"评审员",按医生定的量表给最终诊断打分。知乎
这个小组的看病路数很老派:平均问25.5个问题,才开第一项检查;人类医生平均问5.6个就动手了。AI话密,但不偷懒。知乎
账也算得精。预算受限模式下,它单例成本约1303美元,比医生开卷问诊的4725美元便宜得多,准确率还保住了79.6%。知乎
第一盆冷水:这是模拟考,没有真病人
所有病例来自医学期刊,"患者"是论文里的文字,不是活人。真人会主诉混乱、会记错病史、会隐瞒病情,模拟考场测不出这些。微软自己也承认:离临床可用,还差真实的前瞻验证。东方财富微博
第二盆冷水:对手不是同一个量级
36分是全科医生的成绩。而考试用的NEJM疑难病例,现实中本来就轮不到全科医生单打独斗,是专科团队处理的活。“赢过全科"不等于"能替代你的主治大夫”。知乎
第三盆冷水:83分里,大头是底层模型的功劳
GPT-5自己裸考(不上会诊小组)就有78.9分,加上MAI-DxO编排,只多涨了4分出头。微软研究团队自己说得直白:增益大头来自更强的底层模型,编排是锦上添花,真正的价值是把准确率和成本一起按住。微博知乎
那这事为什么还值得高兴
因为这个"会诊小组"不挑模型。研究者把OpenAI、谷歌、Anthropic、xAI、DeepSeek、Meta各家的模型换上去试,增益都能复现。弱模型Gemini 2.5 Flash单跑只有46.4分,配上编排直接拉到接近69分。便宜的小模型也能被抬到能用,这对预算有限的基层诊所,比"AI神医"实在得多。知乎知乎
微软AI负责人苏莱曼把这一步叫作迈向"医学超级智能"。微软已经和梅奥诊所合作往下推进,研究团队下一步将联手波士顿的Beth Israel Deaconess医疗中心,测试AI给急诊候诊患者分诊的能力。谷歌和OpenAI都在喊类似的话,医疗AI这条赛道,是真的卷起来了。知乎东方财富微博
最后说个最让我感慨的细节:AI平均问满25.5个问题才开第一张检查单。下次你挂号只被问了三分钟,不妨想想,到底谁该跟谁学。